ソフトウェア実験について
本実験では、6週にわたってプログラミング言語Java を使ったオブジェクト指向プログラミングの基礎を学びます。 はじめに、実験を実施する前の準備として、以下の内容について説明します。
- レポート作成および提出における注意点について
- プログラミング言語Javaによるプログラミング環境の構築方法について
- Hello,World.の作り方について
なお、学校にて演習する際には、既にプログラミング環境が構築されているため2.をとばしてもらって構いません。
レポート作成の注意点
レポートを作成する際の要点をまとめました。
レポートについて
レポートを作成する際は以下の点に注意してください。 以下の点が守られていないレポートは受け取りません。
- コンピュータを使った印刷物による提出を認めます。
- 実験のタイトル、学籍番号、実施者名、実施年月日、提出日時を表紙に記載してください。
- 実験のタイトルは、自身が他に提出するレポートと区別が付くように、適切な命名をすること。
- 以下の技術文章の作法に従ってください。
技術文章の作法
本演習における基本的なレポートの作法を以下にまとめます。
- ページ番号を表紙を除いた各ページに記載する。
- レポートに記載する図・表は、図番号と図タイトル、表番号と表タイトルを必ず記載し、図番号・図タイトルは図本体の下部に、表番号・表タイトルは表本体の上部におく。
- 図タイトル・表タイトルは、それぞれその図・表がどんなものか適切に表す説明文でなければならない。
- 図・表をレポートに掲載する際には、レポート本文中に図番号・表番号を使った説明文を含める。
- 例)
問題1: "Hello,World."を表示するプログラムを作成、スクリーンショットを示しなさい。
図1に実行結果のスクリーンショットを示す。
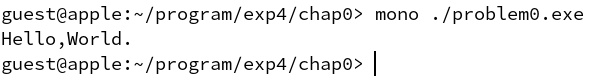
図1: Hello,World.を表示するプログラムの実行例 - ソースコードは図として扱う。
- 例) 図2にHello,Worldのソースコードを示す。
public static void main(String[] args)
{
	Console.WriteLine("Hello, World.");
}
図2: Hello,World.を表示するプログラムのソースコード - 掲載する図・表は、実行結果がはっきりとわかるものに限る[1]。
- 文字情報がまとまったもの(ソースコードなど)をレポート中に掲載する際は、画像データ(スクリーンショットなど)で掲載するのではなく、文字データ(ソースコードのテキストをコピペしたものなど)で掲載する。
- 文字情報を画像として扱うと、画像データはあくまで画像データなので、拡大・縮小や印字した際に文字が潰れててしまい可読性が下がるため避けること。
- 調査課題については、記述内容が何に基づくものなのか、はっきりしていなければならない。もちろん、自分の意見では根拠に乏しいし、なにより調査することを意図している。従って、調査内容の基となった本・論文・Webページを記載しなければならない。
- Webページは閲覧年月日も合わせて書くこと。例を以下に示す。
中間値の定理[3]にて、\( \exists x\in[a, b], f(x)=0 \)となる。
参考文献
:
[3]: 中間値の定理 - KIT 数学ナビゲーション, 金沢工業大学, http://w3e.kanazawa-it.ac.jp/math/category/tyukanti-no-teiri.html (20/04/01閲覧) - なるべく日本語版のWikipediaを参考にすることは避けること。これは、Wikipediaが不特定多数のボランティアユーザによる運営・編纂・校閲を元にした非営利目的の知識集約サイトであり、営利目的の会社によって販売されている辞書のように訓練された編集者が専門家の言質をもってして正当性を担保した文章とは異なるためである。Wikipediaは、あくまで辞書ではなく、個人の意見が多分に反映された、根拠が担保されていないページが多くある文章サイトとして捉えるべきである。従って、参考にする場合は、なるべく教育機関や本などの正当性が保たれている(はずである)ページに限ること。
- Webページは閲覧年月日も合わせて書くこと。例を以下に示す。
参考文献
[1]: 木下是雄, "理科系の作文技術", 中央公論新社, (1981)
Javaのプログラミング環境構築について
本演習は、NetBeansと呼ばれるJavaの統合開発環境を使います。 今回の環境で用意するNetBeansは以下の仕様を満たしますが、独自に構築することは難しいので、指定のページからダウンロードしてください。
- NetBeans 21
- Java Development Kit 11 (Eclipse Temurin JDK 11)
Windows 10とMacOSそれぞれの環境構築の流れをまとめます。この流れに沿って対応してください。
Windowsへのインストール方法
まず、ダウンロードしてきた圧縮ファイルnetbeans-21-bin-ja.zipを、適当なディレクトリに解凍し展開します。
展開して出てきたnetbeansディレクトリは図4のファイル構造になっています。
.\netbeans
    + \bin
        + netbeans
        + netbeans.exe
        + netbeans64.exe
    + \etc
        + netbeans.clusters
        + netbeans.conf
        + netbeans.import
    + \jdk
        + \jdk-11.0.22+7
            + ...
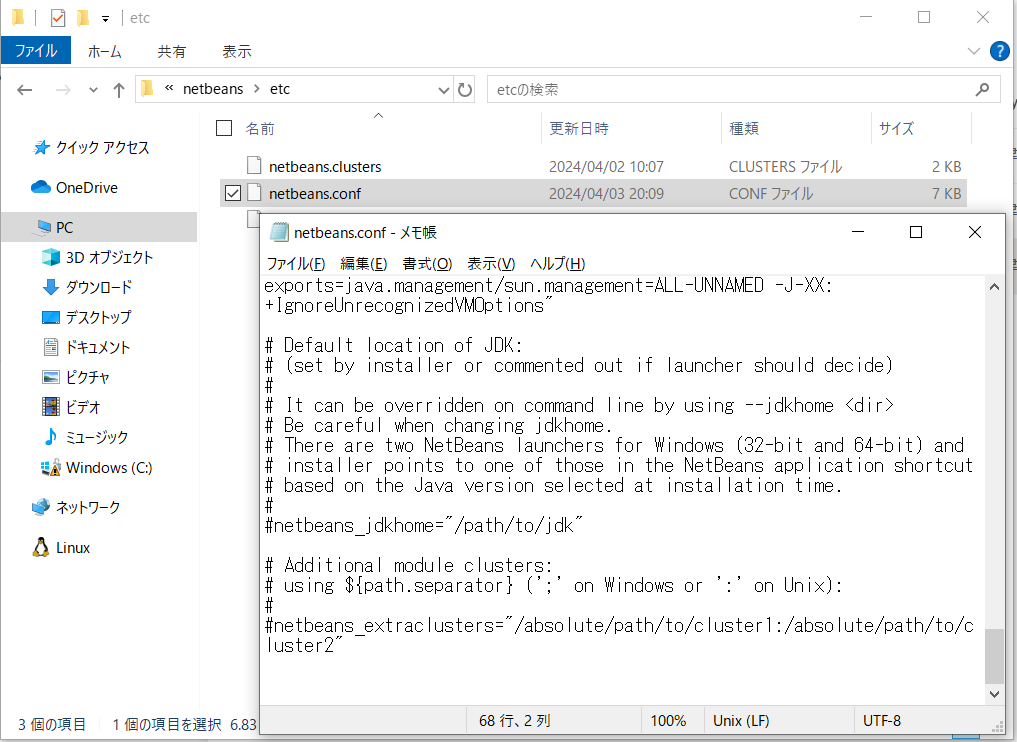
初めに、.\netbeans\etc\netbeans.confをテキストエディタにて開きます(図5)。
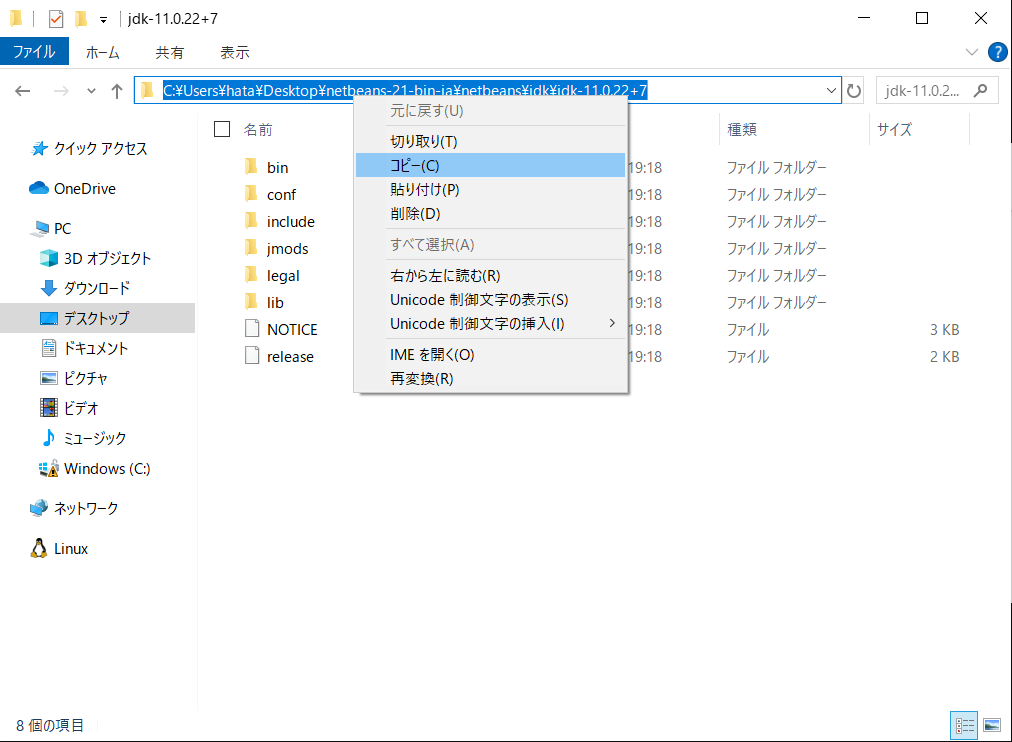
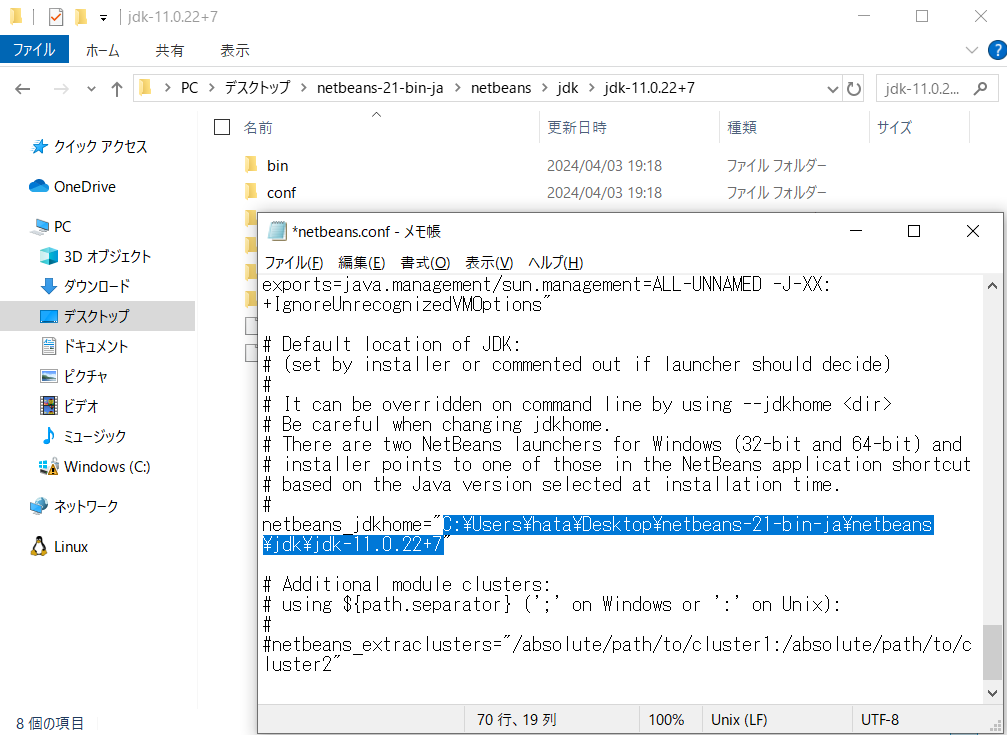
テキストファイル末尾にある、# netbeans_jdkhomeの行について、行頭の#を取り除き、図4の.\netbeans\jdk\jdk-11.0.22+7の絶対パスを記入します(図6、図7)。
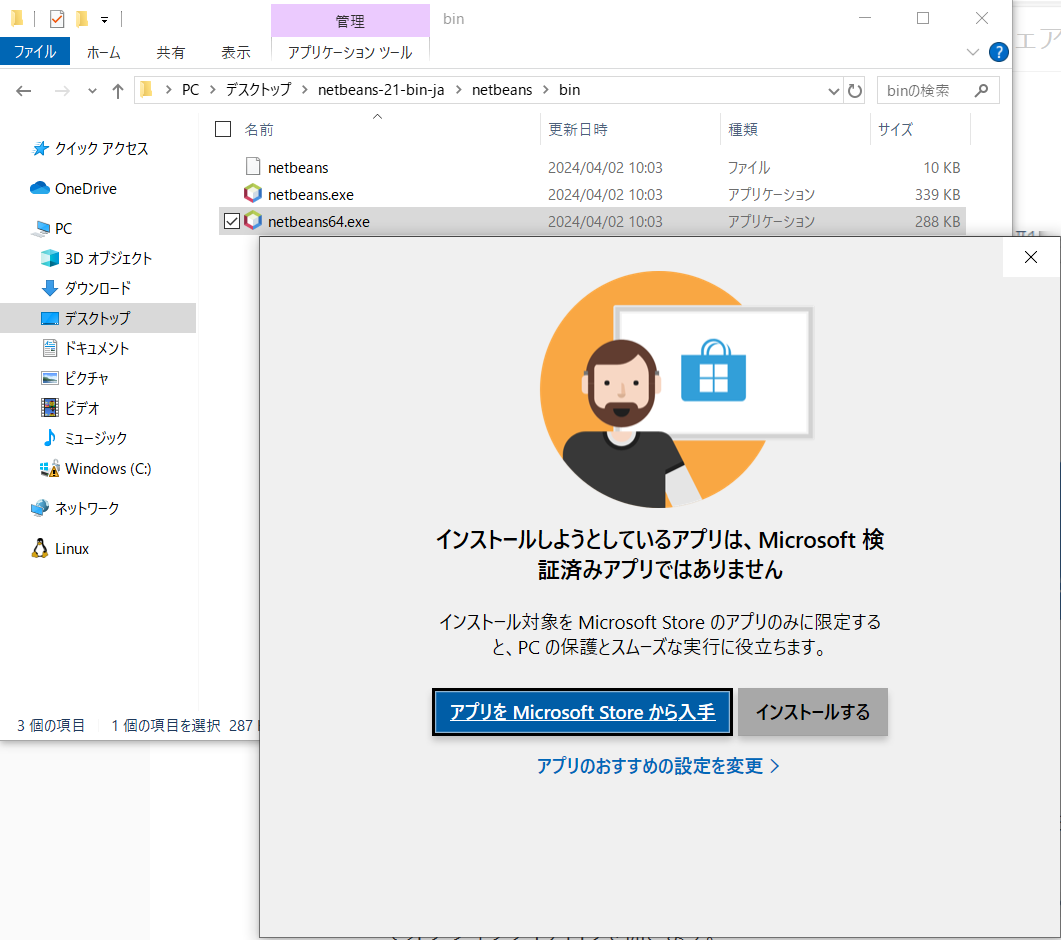
netbeans.confを上書き保存した後、.\netbeans\bin\netbeans64.exeを実行します。
Windows 10であれば、PCの保護機能(図8)が働きますが、そのまま実行してください。
MacOSへのインストール方法
ダウンロードしてきた圧縮ファイルnetbeans-11.3-all-in-one-ja_osx.zipを、適当なディレクトリに解凍し展開します。
しかし、ダウンロードした圧縮ファイルは別途The Unarchiverなど外部の圧縮解凍プログラムでなければ展開できません。インストールして対応してください。
また別途、Temurin JDK 11をインストールしてください。インストーラはここからダウンロードできます。Temurin 11(LTS)をチェックしLatest releaseボタンをクリックしてください。ダウンロードが始まります。
Temurin JDK 11をインストールした後、.\netbeans\etc\netbeans.confをテキストエディタにて開き、76行目を図9に変更してください。ここでnetbeans.conf中にある行頭の#はその行がコメントであることを意味します。
netbeans_jdkhome="/Library/Java/JavaVirtualMachines/temurin-11.jdk/Contents/Home"
NetBeansを起動するためには./netbeans/bin/netbeansを実行する必要があります。しかし、そのままでは実行できません。まずこのファイルが実行可能となるようにフラグを変更してあげる必要があります。次の手順に則って実行してみてください。
- Finderでnetbeansフォルダを開く。
- netbeansフォルダ内にあるbinフォルダを右クリックして右クリックメニューを表示し、
フォルダに新規ターミナルを選択する。 - 開いたターミナル上で次のコマンドを実行する。なお正常に実行されれば何も表示されない。
chmod a+x netbeans - ターミナルを閉じ、Finderでbinフォルダ内にあるnetbeansファイルを右クリックして右クリックメニューを表示し、
このアプリケーションで開く > その他...を選択する。 netbeansを開くアプリケーションを選択します。ダイアログが開かれるので、選択対象のプルダウンリストからすべてのアプリケーションを選択し、ユーティリティフォルダ内のターミナルを選択する。その後、常にこのアプリケーションで開くチェックボックスにチェックを入れて開くボタンを選択する。- Finderから
netbeans/bin/netbeansファイルを選択して実行する。
もし、実行しても何も表示されない場合、上記の2.の手順でもう一度ターミナルを開いてください。その後、ターミナルに以下を入力して実行してみましょう。
./netbeans
実行後にターミナルに以下が表示され実行ができなかった場合は、MacOSが外部から持ち込んだ実行ファイルに対してアプリの実行を制限する属性を自動的に付けている可能性があります。
zsh: operation not permitted: ./netbeans
この場合、ターミナルで以下のコマンドを実行して属性を削除してからNetBeansを改めて実行しなおしてください。
xattr -d com.apple.quarantine ./netbeans
参考URL: Troubleshooting “zsh: operation not permitted” – Alan Siu's Blog
共通の設定
ここからは、ネットワークに接続しておいてください。
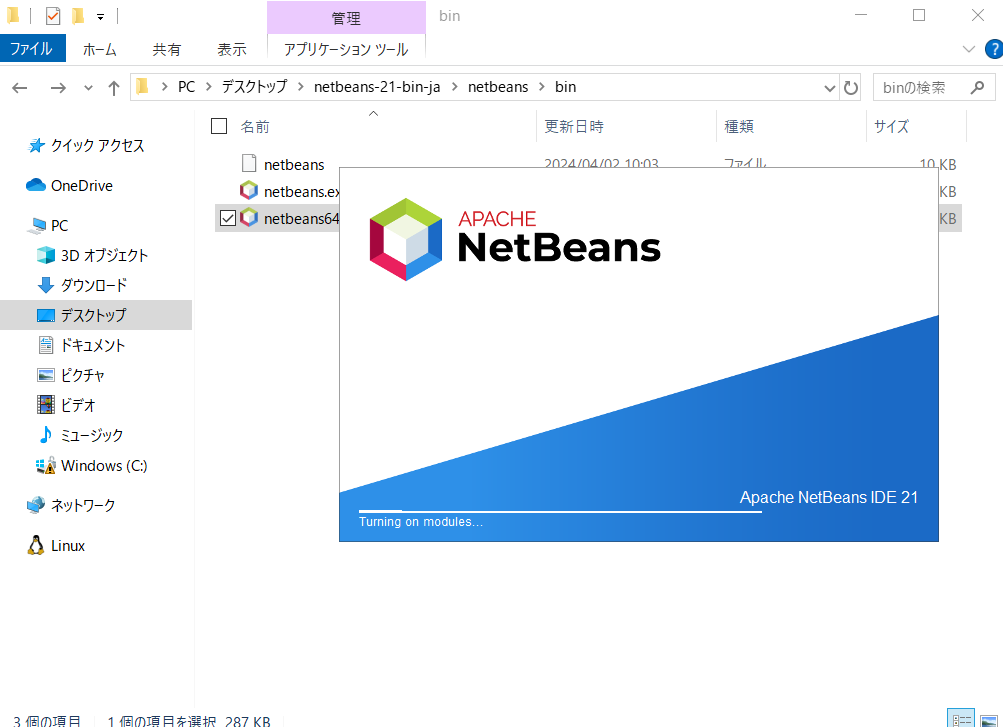
しばらくの初期化・読み込みのち、NetBeansが起動します(図10)。
次に、NetBeansにてJavaの演習をするにあたっては以下のプラグインを有効にする必要があります。
- Java SE
このプラグインはソフトウェアに標準で含まれているものの、初期状態では有効になっていません。このプラグインを有効にする手順を以下に示します。
メニューバーのツール(T) > プラグイン(G)を選びプラグインダイアログを開きます。
MacOSでは、メニューバーのアプリケーションメニューからツール > プラグインを選んでプラグインダイアログを開きます。
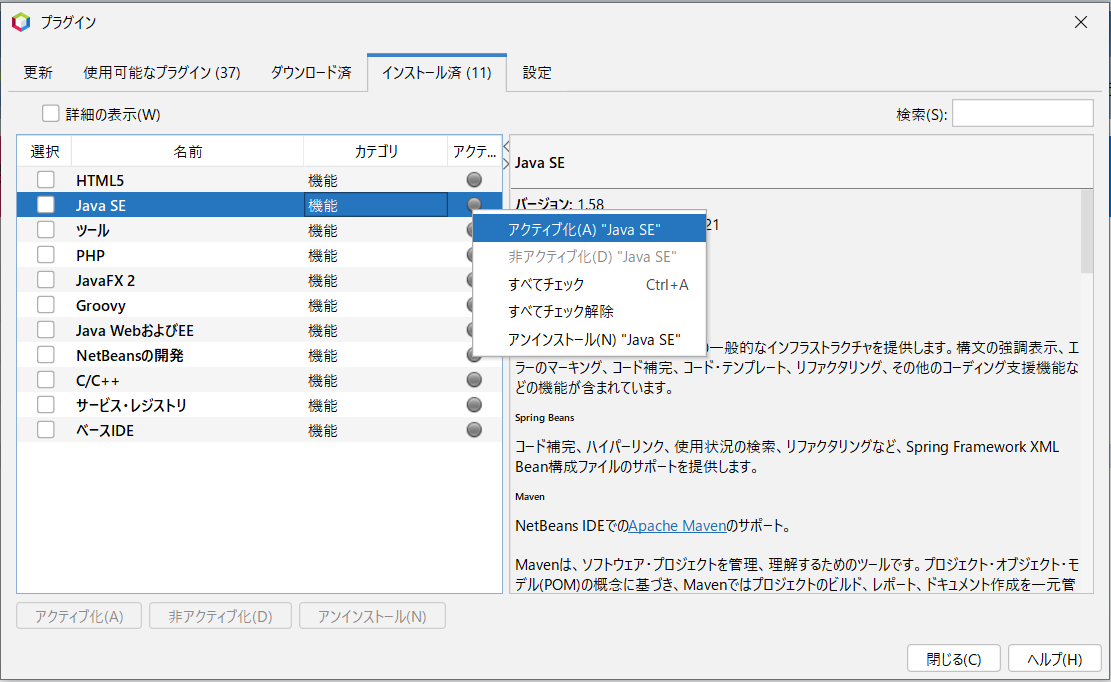
開いたプラグインダイアログのインストール済タブを選び、リスト内のJava SEを右クリックして右クリックメニューからアクティブ化(A) "Java SE"を選びます(図11)。
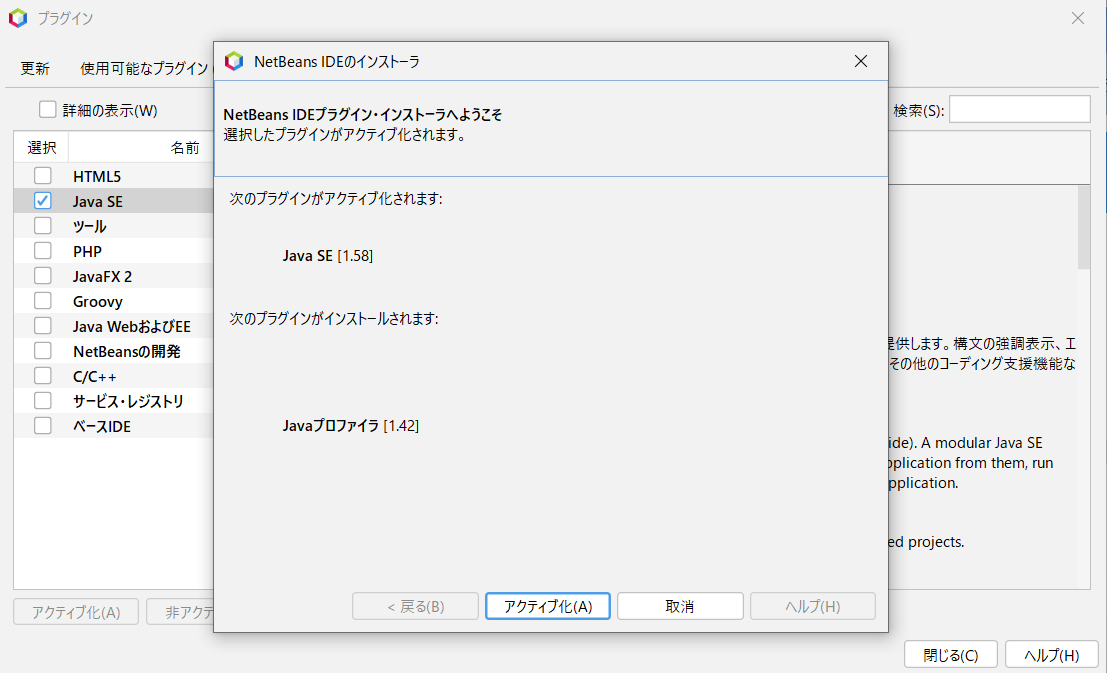
すると、インストーラダイアログが開きますから、アクティブ化(A) を選びます(図12)。
アクティブ化の処理が終わるとアクティブ化が正常に完了しましたと表示されます(図13)。これで必要なプラグインが有効になったため、終了(F)を選びインストーラダイアログを閉じます。
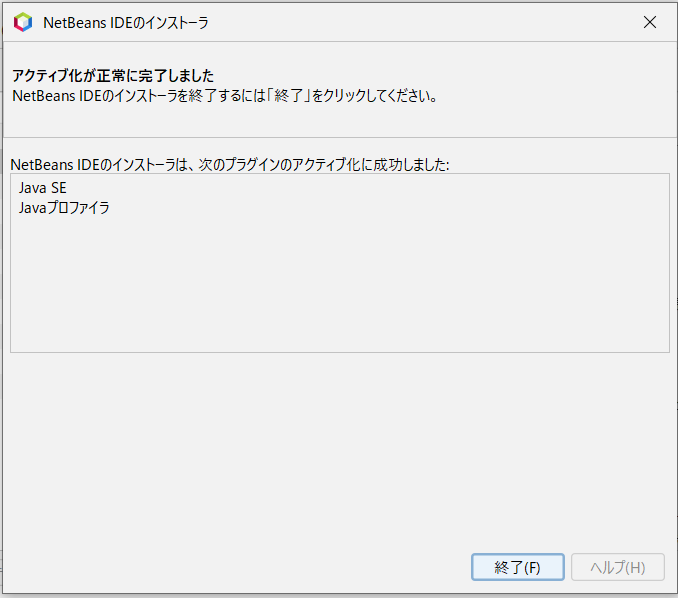
プラグインダイアログのリストにてアクティブ列にチェックマークが入っていることを確認し、設定は終了です。
Hello,World.
動作確認のために、簡単なJavaアプリケーションを作成してみましょう。
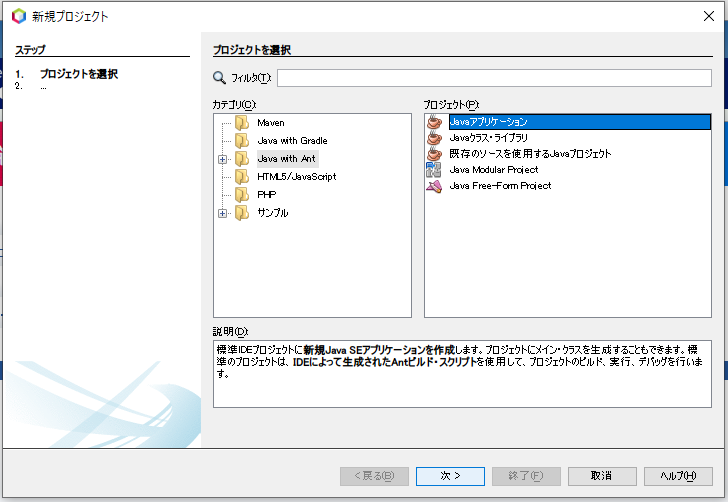
メニューバーのファイル(F) > 新規プロジェクト(W)を選択します。新規プロジェクトダイアログが開くので、カテゴリからJava with Antを選び、プロジェクトからJava アプリケーション選択して、次へボタンを押してください(図16)。
次に、作成するJavaプロジェクトの初期設定をします。
プロジェクト名は課題ごとにその都度指定しますから、その際は変更してください。今回は、JavaApplication1のままにしておきます(図17)。続いて、終了ボタンを選択してください。

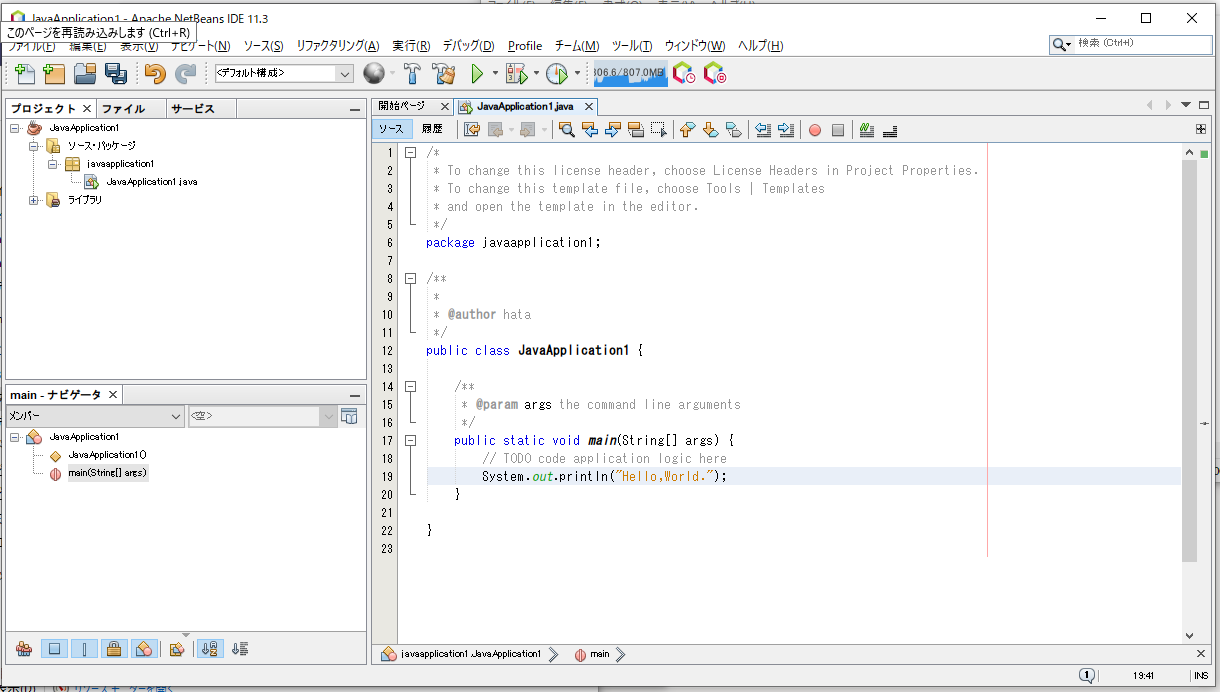
新規プロジェクトが作成されると、メニューバーの直下にあるツールバーが更新されてプログラム実行に関係するアイコンが増え、左側にプロジェクトのファイル構造を閲覧・編集できるプロジェクトペイン、右側にプログラムの編集を行うエディタペインが表示されます(図18)。
プロジェクトペインで、プロジェクトJavaApplication1を選び、ソース・パッケージ内のjavaapplication1フォルダにあるJavaApplication1.javaを開いてください。エディタペインにJavaApplication1.javaタブが開かれ、ソースコードのひな型が表示されます。
このソースコードのひな型で、public static void main...から始まっているブロックがあると思います。これがJavaアプリケーションのmain関数になります。このmain関数を、図19のコードに改変してください。
public static void main(String[] args) {
	System.out.println("Hello,World.");
}
ソースコードを改変したら、次に、プログラムをコンパイルし実行してみましょう。
プログラムをコンパイル・実行するためには、メニューバーの実行(R) > プロジェクト(JavaApplication1)を実行(R)を選びます。あるいはツールバーにある緑三角形のボタンを押すことで、プロジェクトペインで選択しているプロジェクトをコンパイル・実行することができます(図20)。
実行するとコンパイルが始まり、しばらくして出力ペインがエディタペインの下に現れます。このとき図21のように、Hello,World.が表示されていれば、動作確認は終了です。
各週のレポートについて
この実験では実験課題とレポート課題の2種類の課題が課されます。
実験課題は実験時間中にこなしてもらう課題になります。テキストをよく読みながら実験中にすべき演習を実施してください。
レポート課題はレポート作成時に宿題として課す課題として設定しています。実験時間外に実施するか、実験課題をこなして余った時間をレポート課題の実施にあててください。
Javaの基礎
Javaは、1991年にジェームズ・ゴスリンらによって開発された、Java仮想マシン(JVMと略されることが多いです)と呼ばれる仮想的なプログラム実行環境で動作する、プログラムをつくるためのプログラミング言語です。このJVMが動作するOSであれば、OSに関係なくそれらOSが持つ特徴を考慮せずとも、同一のプログラムで、同一の処理を実行させることができる、クロスプラットフォームなプログラミング言語であることが最大の特徴です。
Javaは、デスクトップアプリケーションやWebアプリケーションなどさまざまなアプリケーションを作成するために利用される、現在でも高い利用率を誇る言語です[1]。
特に、オブジェクト指向プログラミングと呼ばれる、クラスと呼ばれる考え方を中心に設計していくプログラミング手法を駆使できるため、これまでのサブルーチンや関数といった手続きを組み合わせて設計する手続き型プログラミングよりも、保守性や拡張性が高い大規模なアプリケーションが作成できると言われています。
この節では、プログラミング言語Javaを使ったプログラムの作り方や文法について見ていきます。
この節の構成は次のとおりです。
- Javaでのプログラミングの作り方
- 型について
- 選択について
- 繰り返しについて
- メソッド(関数)について
[1]: index | TIOBE - The Software Quality Company (20/05/25 閲覧)
プログラムの組み立て方
この節の要点
- 変数などのデータとサブルーチンや関数などの操作がまとまったクラスと呼ばれる構造を組み合わせてプログラムを作成する。
- 操作(Cにおける関数)をメソッドと呼ぶ。
- プログラムを実行した際に最初に呼び出されるメソッド(
mainメソッド )は、public static void main(String[] args)で定義される。- クラスをひとまとまりにしたものをパッケージと呼ぶ。
プログラミングをする、つまりプログラムを組み立てる際には、プログラミング言語の命令の意味を理解するだけではなくて、プログラミング言語で記述されるプログラムの流れ(フロー)を理解する必要があります。
たとえば、Cでは、定数、変数、ポインタなどが持つデータ と、サブルーチンや関数、すなわち具体的な命令が逐次的に記述された処理(操作 )が、それぞれ独立して存在します。 操作はデータを使うことで様々な目的の処理を記述できます。プログラムを組み立てるためには、処理内容を小さな操作に分割して、操作から操作を呼び出していました。
図1にCでHello,Worldを表示するプログラムのソースコードを示します。
#include<stdio.h> // 標準入出力ライブラリの読み込み

int main(void) {
	printf("Hello,World.\n"); // printf関数を使ってHello,World.と表示
}
図1のCのプログラムの読み方の説明は省略します。図1のプログラムについて、処理の流れを図示すると、図2になります。

このプログラムでは、図2に示すように、main関数からprintf関数を呼び出して、Hello,World.を表示する処理を組み立てています。つまり、操作単位で処理を組み立てる わけです。
しかし、Javaではクラス と呼ばれる、 データと操作がまとまった構造 を使って、これまでの手続き的な処理の書き方とは異なる、新たな処理の書き下し方をします。
図3にHello,World.の節で作成したJavaのプログラムを再掲載します。図3のプログラムは、図1のCのプログラムと同様で、実行するとコンソールにHello,World.と表示します。処理の流れを説明する前に、このプログラムを使って、Javaプログラムの基本的な書き方を見ていきましょう。
package javaapplication1; // このソースコードが含まれるパッケージ名

public class JavaApplication1 { // JavaApplication1クラスの定義始まり

    public static void main(String[] args) {
        System.out.println("Hello,World.");
    }
} // JavaApplication1クラスの定義終わり
図3を見ると、public class JavaApplication1と呼ばれるブロック(直後の波括弧{から波括弧閉じ}までのソースコードの範囲)があることがわかります。このclassブロックで定義されるプログラム構造をクラス(class) と呼びます。
Javaのプログラムは クラスが少なくとも1つ定義されていなければなりません 。図3のプログラムの場合、JavaApplication1クラスがこの唯一のクラスに該当します。
また、JavaApplication1クラスは、public static void main(String[] args)と呼ばれるCの関数と似たブロックを持ちます。このブロックをmainメソッド と呼びます。
ここで、メソッド とは、プログラムの処理を1まとまりにして名前を付けたものです。この名前を使って処理を呼び出すことができます。現時点ではC言語などの、関数をイメージしてもらえば、それとほぼ同等の意味と捉えてもらって構いません。
mainメソッドはJavaのプログラムを実行した際に最初に実行される処理 になります。
Javaのプログラムは、1つ以上ある クラスのどれかにmainメソッドが1つ定義されていなければなりません 。図3のプログラムの場合、JavaApplication1クラスが持つmainメソッドがこれに該当します。
なお、図3の先頭の命令package javaapplication1;はソースコードが何のパッケージ に含まれているか示しています。ここで、パッケージとは、複数のクラスを分類してまとめることを目的とした名称のことです。1つのフォルダ(パッケージ)の中に複数のファイル(ソースコード)が含まれているイメージです。パッケージを明記することで、パッケージ名を使って定義されたクラスを呼び出すことができます。 基本的に全てのクラスはなんらかのパッケージに含まれなければなりません 。
図3では、JavaApplication1クラスがjavaapplication1パッケージに含まれる、ということを意味します。このクラスを呼び出す際には、javaapplication1.JavaApplication1と、ピリオドでつないで表記します。
これらクラスとメソッドがどのようにHello,World.を表示するか、図4にその流れを示します。

図4を見てもらうと分かるように、JavaApplication1クラスからSystemクラスを呼び出し、Systemクラスのout変数を介して、PrintStreamクラスのprintlnメソッドを呼び出しています。これはつまり、 クラス単位で処理を組み立てている と言えます。
一見すると、クラス単位に処理を分割することで、処理が複雑になってわかりにくくなっているような印象を受けると思います。なぜ、クラス単位に処理を分けることが良いのかは、以降で触れていきます。
繰り返しますが、ここでの要点は、Javaのプログラムはクラス単位で処理を組み立てる ということです。覚えておいてください。
コメントの付け方
この節の要点
- プログラム中のコメントはC言語と同様に
//でそれ以降の行末までをコメントとして扱うか、/*で始まり、*/で終わる範囲をコメントとして扱うかの2種類の構文がある。/**で始まり、*/で終わる範囲はJavaDocコメントと呼ばれ、IDEが(メソッドの説明表示などで)利用する特殊なコメントである。
Hello,World.の節で作成したプログラムにおいても、ひな型の段階からありましたが、プログラム文中に、プログラム本文ではないコメント文を残したい場合、図5のように記述します。
/* スラッシュコロンからコロンスラッシュまでの文章はプログラムとして解釈されません。
*/

/**
 * スラッシュコロンコロンから始まる文章は、特別なコメント文でJavaDocコメントとよばれます。このコメント文の目的は直後の行の説明ですが、単純なコメント文との違いは、この種類のコメントを抽出してプログラムの説明文章(JavaDoc)を作成することができます。
 */
public static void main(String[] args) {
	// スラッシュスラッシュ以降の行末までの文章はプログラムとして解釈されません。
	System.out.println("Hello,World.");
}
図5に記載してあるコメントのうち、JavaDocコメント は特殊なコメント文です。/**(スラッシュコロンコロン)から始まるこのコメント文は、そのクラスが何をするクラスか、そのメソッドが何をするメソッドか、その変数が何のための変数か、を記述するために使います。ただこのままでは、単純なコメント文と大差ありません。JavaDocコメントはそれを抽出することでプログラムの仕様文章を記述することが、真の目的です。
たとえば、NetBeansのようなエディタやコンパイラやその他支援ツールなどが1つにまとまったソフトウェアである統合開発環境(IDE )であれば、これから使おうとしているメソッドがどんなメソッドか、エディタ上でJavaDocコメントをポップアップで表示させることができます。
NetBeansにおいては、JavaDocが見たいクラス名やメソッド名にテキストカーソルを合わせてCtrl+Shift+Spaceを入力すると、図6や図7のようにJavaDocコメントを装飾して表示させることができます。
自身が書いたJavaDocコメントだけでなく、他者によって既に書かれているJavaDocコメントも閲覧できます。たとえば図7のように、使うメソッドが何をするか、引数(パラメータ)は何か、返り値は何か、といった情報を、英語ではありますが表示できます。


型について
この節の要点
- 整数データだけや文字データだけといった同種類のデータをひとまとまりにしたものを型と呼ぶ。
- 型には、値そのものを扱うことになるプリミティブ型と、ポインタを介して扱うことになる参照型の2種類がある。
- 参照型の値をオブジェクトと呼ぶ。
- 代表的なプリミティブ型には
byte、short、int、long、float、double、boolean、charがある。- 参照型には配列やクラスがある。
プログラムは普通、何かの作業を自動的に行ってもらうようにする処理のかたまり、と考えることが一般的です。
この点をもう少し注意深く見ていくと、プログラムは、数字や文字列といった様々なデータを入力として、それら入力に応じて計算したデータや振る舞いを出力とするもの、とみなすことができます。 つまり、処理においても(内部的にも)、入出力においても(外部的にも)、プログラムはデータのやりとりをしているわけです。
これらデータは、同種類のデータをひとまとまりとしたものを 型(Type) と呼ばれる分類として、Javaのプログラムでは扱われます。
例えば、式(\ref{m:integer})の整数の集合\( \mathbf{Z} \)は、まさに整数型としてプログラムでは扱われますし、式(\ref{m:char})の1文字の集合\( \mathbf{Asci} \)は、文字型として解釈されます。
\[ \mathbf{Z}=\lbrace\cdots,-1,0,1,2,3,\cdots\rbrace \tag{1}\label{m:integer} \] \[ \mathbf{Asci}=\lbrace a,b,c,d,e,f,\cdots \rbrace \tag{2}\label{m:char}\]
Javaのプログラムを観察すると、 データを保持する変数は、当然ですが保持できるデータの型を持ちます 。また、 処理をまとめたメソッドは、処理をするために渡されるデータや処理結果として返却されるデータそれぞれの型を持ちます (図8)。

ここで、注意して欲しいことは、基本的に、ある型の変数に違う型のデータを代入することができませんし、メソッドで指定されている渡すことができる定められた型以外の型で作られたデータを渡すこともできません(図9)。ある型をそれ以外の別の型として扱うことは(基本的には)できない わけです。
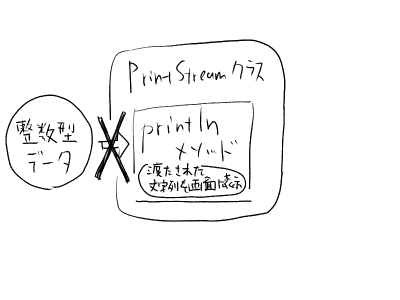
このような、型が数多く存在していて、型によって定められたデータ がプログラム内部の処理を行き来している のです。
したがって、まず、どのような型を扱うことができるかを見ていきましょう。
Javaにおいては、もっとも基本的な型として、以下の8つがあります。
byte型- 8ビット符号付き整数型、\( \text{-}128\sim 127 \)
short型- 16ビット符号付き整数型、\( \text{-}32,768\sim 32,767 \)
int型- 32ビット符号付き整数型、\( \text{-}2^{31}\sim 2^{31}\text{-}1 \)
long型- 64ビット符号付き整数型、\( \text{-}2^{63}\sim 2^{63}\text{-}1 \)
float型- 単精度32ビット浮動小数点型
double型- 倍精度64ビット浮動小数点型
boolean型- ブール型(論理型)、
true、falseの2値
- ブール型(論理型)、
char型- 16ビットUnicode文字型
基本の8つの型以外にも、各自で定義できるクラスも型として扱われます。外部パッケージから特に利用することが多いクラスとして、以下があります。
Stringクラス- 文字列そのものや文字列に対する操作を表すクラスです。
java.langパッケージに定義されています。
- 文字列そのものや文字列に対する操作を表すクラスです。
ArrayListクラス- 可変リストを表すクラスです。
java.utilパッケージに定義されています。
- 可変リストを表すクラスです。
Scannerクラス- 主にキーボードからの入力をデータとして取得する操作を表すクラスです。
java.utilパッケージに定義されています。
- 主にキーボードからの入力をデータとして取得する操作を表すクラスです。
また、以上の型に対する配列も型として扱われます(図10)。
int[] digits; // int型の配列型
String[] args; // Stringクラスの配列型
これら型は次の2種類に分類されます。
- プリミティブ型 (Primitive Type)
byte、short、int、long、float、double、boolean、char型
- 参照型 (Reference Type)
- クラス、配列など
プリミティブ型と参照型の違いは、メモリ上でのデータの扱いです。
プログラムを組み立てるに当たって、フローを意識するのはもちろんですが、どのようにその命令がメモリ上のデータを操作するか想像しながら組み立てることも重要な事の1つです。
ここでは、それほど厳密さがないコンピュータのメモリ上の話をします。メモリを長いテープだと考えてください。このとき、テープには連続した区切りが等間隔で存在します。これが、メモリの領域単位でそれぞれに番地が割り当てられています(図11)。
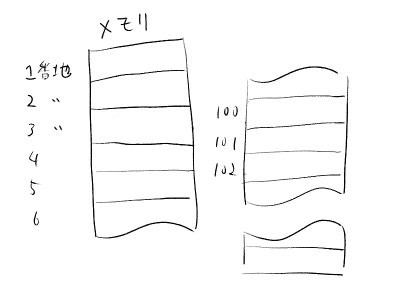
プリミティブ型を使ったプログラム例を図12に示します。
int x = 10; // int型変数xを定義し、int型データ10で初期化
図12のプログラムではint型変数xを定義し、int型のデータである10で初期化しています。
この時の変数xにおけるメモリでのデータの割り当てイメージが図13です。

図12の初期化を行うと、メモリ上のどこかの番地に変数xのデータ領域が確保され、その場所にint型のデータ10が格納されます。このように、プリミティブ型のデータはあくまでデータそのものを扱うイメージです。従ってプリミティブ型の変数はデータそのものが格納されます。
対して、参照型を使ったプログラム例を図14に示します。
int[] x; // int型の配列型変数xを定義
x = new int[4]; // サイズ4の配列オブジェクトを作成しxを初期化
x[0] = 3;
x[1] = 4;
x[2] = -1;
x[3] = -2;
図14のプログラムではint型の配列型変数xを定義し、**new演算子(new operator)**によって配列型データで初期化します。
そして、配列xの0番目にint型のデータ3を、1番目に4を...として初期化しています。
ここで、new演算子は、参照型のデータをメモリ上に作成し、そのデータを指し示すアドレスを返却します。ここで、作成した参照型のデータをオブジェクトと呼びます。
この時の変数xにおけるメモリでのデータの割り当てイメージが図15です。

初めに、変数xがメモリ上に用意されます。次に、メモリ上のどこかに配列オブジェクトが作成され、そのアドレスを変数xが格納します。ここで、変数xがデータを利用する時は、格納されたアドレスを参照して、配列オブジェクトを利用します。
このように、プリミティブ型とは異なり、参照型のデータは、データそのものでなく、データがあるメモリ上のアドレスを扱うイメージ になります。
このことは、クラスでも同様です。クラスを使ったプログラムを図16に示します。
Scanner x = new Scanner(System.in);
図16のプログラムでは、Scanner型の変数xが定義され、new演算子によって作られたScannerクラスのオブジェクトにて初期化されています。
(なお、Scannerオブジェクトを作成する際には、Systemのin変数を使っています)
この時の変数xにおけるメモリでのデータの割り当てイメージが図17です。
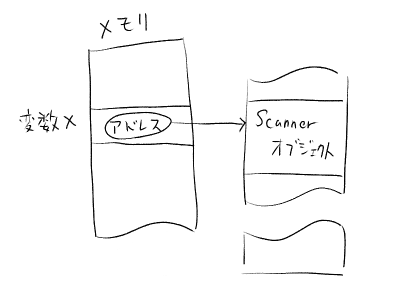
以上のことから、プリミティブ型と参照型がJavaには存在し、それぞれ動作が異なります。
ここからは、これら型を個別に掘り下げて見ていきます。
実験課題1
Exercise 1(課題1) See the section from 1.3 "About Type" to 1.4.5. "Array". Then show the execution result of the following source code as a screenshot. To show the result, first, create Java application project named chapter1kadai1. Second, create main method to run this program. Further, explain why this program results.
int[] orig = new int[5];
int[] copy;

orig[2] = 30;

System.out.println(orig[2]);

copy = orig;
copy[2] = 20;

System.out.println(orig[2]);
(1.3節.から1.4.5節までをよく読み、"Hello,World."の節を参考にしてプロジェクト名chapter1kadai1のJavaアプリケーションプロジェクトを作成して、次のプログラムがmainメソッド上で動作するよう改変し、その実行結果を示しなさい。また、なぜそのような動作となったか説明しなさい。)
整数型
この節の要点
- 整数データを扱う整数型には
byte、short、int、そしてlongがある。
Javaにおいて、整数型は次の4種類があります。
byte型- 8ビット符号付き整数型、\( \text{-}128\sim 127 \)
short型- 16ビット符号付き整数型、\( \text{-}32,768\sim 32,767 \)
int型- 32ビット符号付き整数型、\( \text{-}2^{31}\sim 2^{31}\text{-}1 \)
long型- 64ビット符号付き整数型、\( \text{-}2^{63}\sim 2^{63}\text{-}1 \)
よく使われる、あるいは見かけることが多い整数型はint型です。ここで、整数としてソースコードに直接記述された数字はすべてint になります。なお、図18に示すように、整数型の初期値は全て0です。
int x;
System.out.println(x);	// 0が表示される。
整数型に対する演算命令は一律で以下の通りに定まっています。
+加算演算子- 前の値と後ろの値を足し合わせた結果を返します(図19)。
int x = 2; int y = 3; System.out.println(x + y); // 5が表示される。図19:整数型の足し算
- 前の値と後ろの値を足し合わせた結果を返します(図19)。
-減算演算子- 前の値から後ろの値を引いた結果を返します(図20)。
int x = 2 int y = 3; System.out.println(x - y); // -1が表示される。図20:整数型の引き算
- 前の値から後ろの値を引いた結果を返します(図20)。
*乗算演算子- 前の値と後ろの値を掛け算した結果を返します(図21)。
int x = 2; int y = 3; System.out.println(x * y); // 6が表示される。図21:整数型の掛け算
- 前の値と後ろの値を掛け算した結果を返します(図21)。
/除算演算子- 前の値に後ろの値を割り算した結果を返します(図22)。なお整数型では小数点以下の値は切り捨てされます。
int x = 2; int y = 3; System.out.println(x / y); // 0が表示される。図22:整数型の割り算
- 前の値に後ろの値を割り算した結果を返します(図22)。なお整数型では小数点以下の値は切り捨てされます。
%剰余演算子- 前の値に後ろの値を割り算した結果の余りを返します(図23)。
int x = 2; int y = 3; System.out.println(x % y); // 2が表示される。図23:整数型の割り算の余り
- 前の値に後ろの値を割り算した結果の余りを返します(図23)。
++インクリメント演算子- 前または後ろの値に1足し合わせた結果を元の変数に代入しなおします(図24)。
int x = 2; ++x; System.out.println(x); // 3が表示される。図24:整数型の1増加
- 前または後ろの値に1足し合わせた結果を元の変数に代入しなおします(図24)。
--デクリメント演算子- 前または後ろの値に1引いた結果を元の変数に代入しなおします(図25)。
int x = 2; --x; System.out.println(x); // 1が表示される。図25:整数型の1減少
- 前または後ろの値に1引いた結果を元の変数に代入しなおします(図25)。
浮動小数点型
この節の要点
- 実数データを扱う浮動小数点型には
floatとdoubleがある。
浮動小数点とは、コンピュータで小数を表現方法のなかでもっとも普及している方式です。この方法で表現される小数は、あくまで近似した小数であるため、無限に数列が続く循環小数などは表現できず、誤差を含む可能性があります。Javaにおいても、浮動小数点を使った表現にて小数が実装されています。したがって、小数は以降に示す浮動小数点型に属します。
Javaにおいて、浮動小数点型は次の2種類があります。
float型- 単精度32ビット浮動小数点型
double型- 倍精度64ビット浮動小数点型
標準で使われる浮動小数点型はdouble型です。また、小数としてソースコードに直接記述された数字はすべてdouble になります。なお、図26に示すように、浮動小数点型の初期値は全て0.0です。
double x;
System.out.println(x);	// 0.0が表示される。
浮動小数点型に対する演算命令は一律で整数型と同様ですが、動作が微妙に異なり、以下の通りに定まっています。
+加算演算子- 前の値と後ろの値を足し合わせた結果を返します(図27)。
double x = 2.0 + 3.0; System.out.println(x); // 5.0が表示される。図27:浮動小数点型の足し算
- 前の値と後ろの値を足し合わせた結果を返します(図27)。
-減算演算子- 前の値から後ろの値を引いた結果を返します(図28)。
doube x = 2.0 - 3.0; System.out.println(x); // -1.0が表示される。図28:浮動小数点型の引き算
- 前の値から後ろの値を引いた結果を返します(図28)。
*乗算演算子- 前の値と後ろの値を掛け算した結果を返します(図29)。
double x = 2.0 * 3.0; System.out.println(x); // 6.0が表示される。図29:浮動小数点型の掛け算
- 前の値と後ろの値を掛け算した結果を返します(図29)。
/除算演算子- 前の値に後ろの値を割り算した結果を返します(図30)。
double x = 2.0 / 3.0; System.out.println(x); // 0.6666666666666666が表示される。図30:浮動小数点型の割り算
- 前の値に後ろの値を割り算した結果を返します(図30)。
%剰余演算子- 前の値に後ろの値を割り算した結果の余りを返します(図31)。
double x = 2.0 % 3.0; System.out.println(x); // 2.0が表示される。図31:浮動小数点型の割り算の余り
- 前の値に後ろの値を割り算した結果の余りを返します(図31)。
++インクリメント演算子- 前または後ろの値に1足し合わせた結果を元の変数に代入しなおします(図32)。
double x = 2.0; ++x; System.out.println(x); // 3が表示される。図32:浮動小数点型の1増加
- 前または後ろの値に1足し合わせた結果を元の変数に代入しなおします(図32)。
--デクリメント演算子- 前または後ろの値に1引いた結果を元の変数に代入しなおします(図33)。
double x = 2; --x; System.out.println(x); // 1が表示される。図33:浮動小数点型の1減少
- 前または後ろの値に1引いた結果を元の変数に代入しなおします(図33)。
文字列型
この節の要点
- 文字データと文字列データは区別され、文字データは
char型、char型が列んだ文字列データはString型である。- 文字列型は
Stringクラスとして定義されている。int型やdouble型などのプリミティブ型とString型の加算演算は、文字列として連結したString型を作ることになる。
Javaにおいて、文字を表す型は、char型があります。ですがもっぱら文字列として扱うことが多いです。文字列を表したい場合は、Stringクラスを使います。
char型- 16ビットUnicode文字型
Stringクラス- 文字列を表す文字列型を表現したクラスです。
java.langパッケージに定義されています。
- 文字列を表す文字列型を表現したクラスです。
なお、文字型の初期値は\u0000(ヌル文字)です。また、文字列型の初期値はnull(ヌル)になります。しかし、図34に示すように、初期化することなくこれら型の変数を使うことはできません。コンパイル前にエラーとして表示されます。
なお、参照型の初期値も同様にnullです。
String s;
System.out.println(s);	// 初期化されていないためエラー
また、ソースコードに直接記述されたシングルクオート'で囲われた1文字は文字型の値として扱われ、ダブルクオート"で囲われた複数文字は文字列型の値として扱われます(図35)。
char c = 'C'
String s = "Hello,World.";
文字列型では加算演算子を使うことで、文字列同士を結合することができます。また、文字列型と他のプリミティブ型を文字列として結合することもできます(Autoboxing)。
+加算演算子-
前の値と後ろの値を結合した結果を返します(図36)。他のプリミティブ型のデータと結合した結果を返すこともできます(図37)。
String x = "Hello"; String y = "World"; System.out.println(x + "," + y + "."); // Hello,World.が表示される。図36:文字列型の足し算 int x = 42 * 365; System.out.println("result: " + x); // result: 15330が表示される。図37:文字列型の足し算
-
なお、プリミティブ型は、Javaの機能によって、String型に自動で変換してくれるため(Autoboxing + 加算演算子によるtoStringメソッド呼び出し)、System.out.printlnメソッドなど、文字列型のみを受け取るメソッドであっても渡すことができます。
なお、文字列の長さを取得したい際には、文字列オブジェクトが持つlengthメソッドを使います(図38)。オブジェクトはそのデータ構造内部に変数やメソッドを持つことが一般的です 。これら内部の変数やメソッドを参照あるいは呼び出しする際には、ピリオド.を使って呼び出します。
System.out.println("string length: " + "あいうえお".length()); // string legnth: 5と表示される。
ブール型
この節の要点
- 真偽値を表すデータ型は
booleanであり、trueかfalseの2値で表されるデータである。- 分岐など条件式をつかう制御構造は、条件式の演算結果である
boolean型の値がtrueかfalseかを判断して制御する。
Javaにおいて、真偽値を意味するtrueあるいはfalseの2値は、ブール型と呼ばれます。
一般的に、trueを真の状態、falseを偽の状態として扱います。
このブール型は、以降で説明する制御構文にて、分岐するかどうか、繰り返しを継続するかどうか、などを判断する際に使われます。
ブール型に対する演算命令を以下に示します。
&&AND条件式演算子- 前の値と後ろの値の論理積をブール型の値で返却します(図39)。
boolean x = true; boolean y = false; System.out.println(x && y); //falseが表示されます。図39:ブール型の論理積
- 前の値と後ろの値の論理積をブール型の値で返却します(図39)。
||OR条件式演算子- 前の値と後ろの値の論理和をブール型の値で返却します(図40)。
boolean x = true; boolean y = false; System.out.println(x || y); //trueが表示されます。図40:ブール型の論理和
- 前の値と後ろの値の論理和をブール型の値で返却します(図40)。
!否定演算子- 直後の値の否定をブール型の値で返却します(図41)。
boolean x = true; boolean y = false; System.out.println(!y); //trueが表示されます。 System.out.println(x && !y); //trueが表示されます。図41:ブール型の否定
- 直後の値の否定をブール型の値で返却します(図41)。
また、ブール型のデータは直接扱わずとも、整数型や浮動小数点型といった整数型に対する比較演算子の演算結果として間接的に利用していることが大半です。
以下にJavaにおける関係演算子を示します。
==等しい- 前後の値がデータ的に等しいかどうか、等しければ
true、等しくなければfalseを返す(図42)。int x = 2; int y = 3; System.out.println(x == y); //falseが表示されます。図42:int型データが等しいかどうか
- 前後の値がデータ的に等しいかどうか、等しければ
!=等しくない- 前後の値がデータ的に等しくないかどうか、等しくなければ
true、等しければfalseを返す(図43)。double x = 2.0; double y = 3.0; System.out.println(x != y); //trueが表示されます。図43:double型データが等しくないかどうか
- 前後の値がデータ的に等しくないかどうか、等しくなければ
>より大きい- 前の値が後ろの値よりもデータ的にそれを越えて大きいかどうか、大きければ
true、大きくなければfalseを返す(図44)。int x = 30; int y = 30; System.out.println(x > y); //falseが表示されます。図44:int型データがより大きいかどうか
- 前の値が後ろの値よりもデータ的にそれを越えて大きいかどうか、大きければ
>=以上- 前の値が後ろの値よりもデータ的にそれと等しいかあるいは大きいかどうか、等しいあるいは大きいなら
true、そうでなければfalseを返す(図45)。int x = 30; int y = 30; System.out.println(x >= y); //trueが表示されます。図45:int型データが以上かどうか
- 前の値が後ろの値よりもデータ的にそれと等しいかあるいは大きいかどうか、等しいあるいは大きいなら
<より少ない- 前の値が後ろの値よりもデータ的にそれを越えて小さいかどうか、小さければ
true、小さくなければfalseを返す(図46)。double x = 30.0; double y = 30.0; System.out.println(x < y); //falseが表示されます。図46:double型データがより少ないかどうか
- 前の値が後ろの値よりもデータ的にそれを越えて小さいかどうか、小さければ
<=以下- 前の値が後ろの値よりもデータ的にそれと等しいかあるいは小さいかどうか、等しいあるいは小さいなら
true、そうでなければfalseを返す(図47)。double x = 30.0; double y = 30.0; System.out.println(x <= y); //trueが表示されます。図47:double型データが以下かどうか
- 前の値が後ろの値よりもデータ的にそれと等しいかあるいは小さいかどうか、等しいあるいは小さいなら
配列
この節の要点
- 決められた長さのデータが連結された配列型は、
int[]のように型の後ろに[]を付けることで定義できる。- 配列型を初期化するためには
new演算子を使う。
配列とは、決められた数だけ指定された型を保存できるデータ構造(コンテナオブジェクト)です。
配列型は、型名の直後に角括弧、角括弧閉じ[]を付けることで定義できます。ここで、どのような型であっても配列を作成することができます(図48)。
int[] intArray;	// nullで初期化されている。
double[] dblArray; //nullで初期化されている。
String[] strArray; //nullで初期化されている。
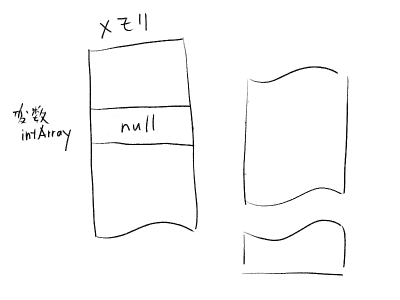
図48における変数intArrayのメモリ上でのイメージを図49に示します。
また、配列を使うためには、new演算子を使って配列オブジェクトを作成し、初期化する必要があります(図50)。
int[] intArray = new int[2];
double[] dblArray = new double[6];
String[] strArray = new String[3];
ここで、あらかじめその配列が格納できるデータの数を指定してあげなければなりません。例えば、図50のintArray変数はint型データを2つ持つことができる配列として宣言されています。この配列が持つことができるデータの個数を長さと呼びます。ここで、初期化された個々のデータの初期値は、各型の初期値になります。
図49における変数intArrayのメモリ上でのイメージを図51に示します。

初期化した配列は、角括弧[]と番号(インデックス )を付けることで、そのインデックスに対応したデータを参照できます(図52)。
dblArray[4] = 100.0; // 配列のインデックス4に100.0を代入。
System.out.println(dblArray[0]); // 0.0が表示される。
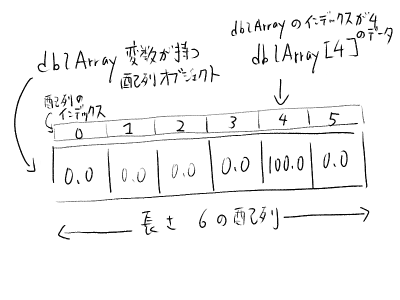
このとき、配列オブジェクトのデータ構造のイメージを図53に示します。ここで注意して欲しい点は、配列のインデックス\(i\)は、配列の長さが\(N\)の時、\(0\leq i\leq N-1\)の範囲で指定しなければなりません。配列オブジェクトの先頭はインデックスが\(1\)からではなく\(0\)からであり、最後のインデックスは\(N\)ではなく\(N-1\)であることに注意しましょう。
配列の長さを取得するためには、配列オブジェクトが持つlength変数を参照してください(図54)。 オブジェクトはそのデータ構造内部に変数やメソッドを持つことが一般的です 。これら内部の変数やメソッドを参照あるいは呼び出しする際には、ピリオド.を使って呼び出します。
System.out.println("array length: " + dblArray.length); // array legnth: 6と表示される。
実験課題2
Exercise 2(課題2) See the section 1.4.1. "About Standard Input and Output". Then show the execution result as the screenshot by creating Java project chapter1kadai2 with the following source codes. This program is similar to the program of the Fig. 57 that directly specifies the Scanner class by writing the package and class name joined by dot. The source code of Fig. 57 still can become shorter by using import keyword such as the following source code.
import java.util.*; // java.utilパッケージ内に含まれる全てのクラス等を読み込む(ソースコードの先頭からクラスブロックよりも前のどこかに記述する)
Scanner scan = new Scanner(System.in); // Scannerオブジェクトを作成する。
String input = scan.nextLine(); // 改行が押されるまでのテキストデータを返却する。
System.out.println("input: " + input);
(1.4.1.節をよく読み、以下のプログラムについて、プロジェクト名chapter1kadai2のJavaアプリケーションプロジェクトを作成して、実行結果を示しなさい。このプログラムは、Scannerクラスを参照するためにパッケージ名を直接記述して参照している図57のプログラムと同じプログラムである。次のように import文 を使って、パッケージをあらかじめ読み込むことで、パッケージ名による指定を省略している。)
標準入出力について
この節の要点
- ターミナルに文字を表示(標準出力)するためには、
System.out.printlnメソッドを使う。- プログラムがターミナルから文字を受け取る(標準入力する)ためには、
Scannerクラスを使う。
標準出力
Javaにおける標準出力(ターミナル、本演習においてはNetBeansでの出力タブ)へのテキスト出力については、これまでのサンプルコードを見てもらえれば分かる通り、System.out.printlnメソッドを使うことで出力できます(図55)。
System.out.println("Hello,World.");
このprintlnメソッドはSystemクラスが持つout変数がPrintStreamクラスの構造(オブジェクト)を参照型として持っていて、out変数が表すオブジェクトの持つprintlnメソッドを呼び出しているわけです。これは図4でも概略を示しました。このPrintStreamクラスには、printlnメソッド以外にも、テキスト出力するメソッドが用意されています。
以下によく使うPrintStreamクラスのメソッドを示します。
printメソッド- たとえば、
printlnメソッドは末尾に改行が必ず挿入されますが、挿入してほしくないときもあります。このような時は、printメソッドを使います。printメソッドは指定された文字列を出力するだけです(図56)。System.out.print("Hello,"); System.out.print("World."); // Hello,World.と表示される。図56:printメソッドによる標準出力への表示
- たとえば、
標準入力
Javaにおける標準入力(キーボード入力)からテキストデータを取得する場合、いくつかの方法がありますが、もっとも簡単な方法はScannerクラスを使う方法です。
図57にScannerクラスを使った、最小の読み取りプログラムを示します。
Scannerクラスはjava.utilパッケージにあります。従って、クラスを呼び出す際にはjava.util.Scannerのように呼び出す必要があります。
java.util.Scanner scan = new java.util.Scanner(System.in); // Scannerオブジェクトを作成する。
String input = scan.nextLine(); // 改行が押されるまでのテキストデータを返却する。
System.out.println("input: " + input);
図57において、Scannerオブジェクトをscan変数に作成した後、オブジェクトが持つnextLineメソッドをscan変数を介して呼び出すことで、改行が入力されるまでのテキストをStringオブジェクトとして取得します。そして、取得した結果を変数inputに代入しています。キーボードから入力する際は、出力タブの中央をクリックしてテキストカーソルを出した状態で、キーボードから文字を入力し、エンターキーを押すことでテキストデータを入力できます。
以上のprintlnメソッドと、Scannerオブジェクトを利用することで、基本的な入出力データのやりとりをすることができます。
制御構文について
この節の要点
- プログラミングの制御構造として順接、選択、そして繰り返しがある。
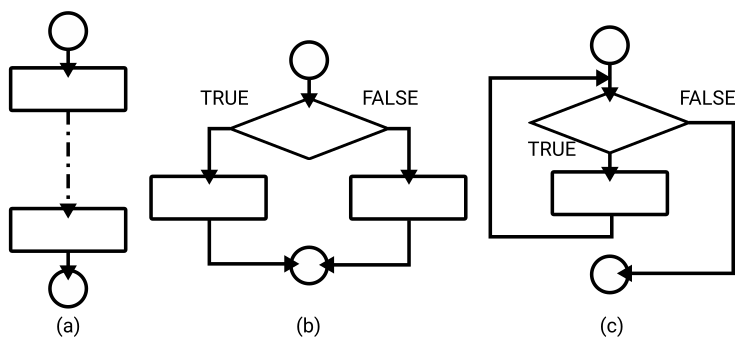
Javaでは、一般的な手続き型プログラミング言語が持つ3種類の制御構造、
- 順接: 命令を連続して記述する、
- 選択: 条件に応じて処理を選択する、
- 繰り返し: 条件を満たすまで処理を繰り返す、
を表現することができます。各制御構造をフローチャートで表記したものを図58に示します。
順接構造を記述することは容易に思いつくはずなので、ここでは、選択と繰り返しを実現するための構文を次にまとめました。
- 選択
if文、switch文
- 繰り返し
for文、while文、do-while文
以降、選択と繰り返しについて掘り下げていきます。
実験課題3
Exercise 3(課題3) See the section 1.6.1. "About Selection". Then, first, modify the Fig. 59 program to judge the input data from keyboard by creatintg Java project chapter1kadai3. Second, show the source code and the execution result as the screenshot. To convert the string object to int value, use parseInt method in Integer class as follows.
String str = "42";
int x = Integer.parseInt(str); // 文字列型オブジェクトをint型の値に変換する。
System.out.println(x * x); // 1764と表示される。
(1.6.1.節をよく読み、プロジェクト名chapter1kadai3のJavaアプリケーションプロジェクトを作成して、図59のプログラムを標準入力から受け取ったデータについて判断するように変更しなさい。そしてソースコードと実行結果を示すこと。なお、入力から取得した文字列型オブジェクトをint型の値に変換するためには、次に示す、IntegerクラスのparseIntメソッドを使いなさい。)
選択について
この節の要点
- 条件分岐には
if文とswitch文がある。
Javaで、処理を選択する、つまり条件分岐させる構文は、ifとswitchの2つがあります。
if文は条件式と呼ばれる、ブール型の値として定められる式、に基づいて次の呼び出す処理を選択することができます。ここで条件式とは例えば、"変数\(x\) の中身が\(0\)以外である"を、プログラムの命令文"\(x != 0\)"として記述したものです。
この条件式は、一般的にブール型の節で説明した、関係演算子を使って書き下されることが多いです。
またswitch文は、byte型、short型、char型そしてint型のデータのみしか扱うことができませんが、一致させたいデータのパターンが多くあるような場合、そしてそのパターンごとに処理を選びたいとき、if文よりも簡潔に記述できます。
それぞれ、処理速度の違いはあまりありませんから、書きやすさ・見やすさを記述する処理ごとに判断して、利用するかしないか選択しましょう。
if文
if文の例を図59に示します。このソースコードは、与えられたbirthyear、birthmonthとbirthdayの生年月日に応じて令和生まれか平成生まれかあるいはそれ以外かを判断します。ちなみに以下の条件に則って判断しています。
- 生年月日が2019年5月以降は令和生まれである。
- 生年月日が1989年1月8日以降2019年4月以前は平成生まれである。
- それ以外の生年月日は認識しない。
処理については、Cなどの言語とかわりません。ですから、else if節はいくらでも追加することができます。また、else節は無くても良いです。
if文の丸括弧の中は、ブール値が求まる式であればどんな式でも書くことができます。なお、if文はソースコードの実行順序において先に定義されている条件式から順番に真偽値を判断していくため、前方の式が真であれば、後方の条件式については判断されないことに注意してください。
int birthyear = 2019;
int birthmonth = 6;
int birthday = 7;

if (birthyear >= 2019) {
	if (birthyear == 2019) {
		if (birthmonth >= 5) {
			System.out.println("令和生まれです。");
		} else {
			System.out.println("平成生まれです。");
		}
	} else {
		System.out.println("令和生まれです。");
	}
} else if (birthyear >= 1989) {
	if (birthyear == 1989) {
		if (birthmonth == 1 && birthday < 8) {
			System.out.println("認識できません。");
		} else {
			System.out.println("平成生まれです。");
		}
	} else {
		System.out.println("平成生まれです。");
	}
} else {
	System.out.println("認識できません。");
}
switch文
switch文の例を図60に示します。このソースコードは、monthに与えられた月の数値を元に、対応する英単語を表示します。
switch文の丸括弧で渡されたデータがcase文の値と一致していれば、caseブロックの処理が実行されます。ここで、Javaのswitch文においては、各caseブロックにおいて必ず末尾にbreak文を記述しておく必要がある(記述しなければコンパイルエラーとなる)ことに注意してください。
int month = 8;
String monthString;
switch (month) {
    case 1:  monthString = "January";
	     break;
    case 2:  monthString = "February";
	     break;
    case 3:  monthString = "March";
	     break;
    case 4:  monthString = "April";
	     break;
    case 5:  monthString = "May";
	     break;
    case 6:  monthString = "June";
	     break;
    case 7:  monthString = "July";
	     break;
    case 8:  monthString = "August";
	     break;
    case 9:  monthString = "September";
	     break;
    case 10: monthString = "October";
	     break;
    case 11: monthString = "November";
	     break;
    case 12: monthString = "December";
	     break;
    default: monthString = "Invalid month";
	     break;
}
System.out.println(monthString);
実験課題4
Exercise 4(課題4) See the section 1.7.1. "About Iteration". Then create the calculator program by creating the project chapter1kadai4. The term "calculator" here is that show the calculating result by inputting from keyboard such as + 10 2. In the input string separated by space, first term shows the operations: +(addition), -(subtraction), *(multiplication), /(division), and e(termination of the calculator). Second and third terms are operands. The calculator should use infinity loop. To get each term value from input string, should use split method in String class.
(1.7.1.節をよく読み、プロジェクト名chapter1kadai4のJavaアプリケーションプロジェクトを作成して、電卓を作成しなさい。そしてソースコードと実行結果を示すこと。ここで電卓とは記号 整数 整数として半角スペースで区切られた文字列がキーボードから入力され、それに対して計算結果を出力するプログラムである。例えばキーボードから+ 10 2のように入力された際には、12を返却する。この電卓は記号として+、-、*、/、eを受け付ける。受け付けられた記号ごとに、加算、減算、乗算、割り算を実行する。このプログラムは無限ループで処理が構成され、記号としてeが与えられた際には、無限ループを終了する。)
ここで、文字列から記号や数字などを個別に取得するためには、区切り文字で文字列を分割するStringクラスのsplitメソッドを使う。以下にsplitメソッドの利用例を示す。
String str = "あ い う え お"; // 変数strに文字列型オブジェクト"あ い う え お"を代入する。
String[] chars = str.split(" "); // 変数strの文字列を元に半角スペース" "にて区切った複数の文字列型オブジェクトを配列として変換する。
System.out.println("2番目の文字を表示: " + chars[1]);
また、文字列の比較をする際には、Stringクラスのequalsメソッドを使う。以下にequalsメソッドの利用例を示す。
String str = "あ";
if ("い".equals(str)) { // strの文字列オブジェクトと文字列オブジェクト"い"を比較する。
	System.out.println("いです。");
} else if ("あ".equals(str)) { // strの文字列オブジェクトと文字列オブジェクト"あ"を比較する。
	System.out.println("あです。");
)
繰り返しについて
この節の要点
- よく使う繰り返し文として
for文とwhile文がある。
繰り返しとは、特定の処理を決められた回数繰り返す制御のことです。
これら繰り返しは、配列のような連続したデータ構造を処理するために使われることが多いです。
Javaの繰り返しは、while、do-while、forの3つがあります。ここでは、do-while文は省略し、while文とfor文について、説明します。
while文
while文は、丸括弧で指定された条件式が真であるかぎり、繰り返す構文です。条件式はif文の時と同様に、ブール値を返却する内容であれば何でも良いです。
while文は、繰り返す前に、条件式が成り立っているか判断します。繰り返す以前に条件式が成り立っていなければ、while文はスキップされ、繰り返し処理を実行しません。
図61にプログラム例を示します。このようなループ回数が定まっていない処理をする際にwhile文が利用されます。
int collatz = 50;

while (collatz != 1) {

	if (collatz % 2 == 0) {
		collatz = collatz / 2;
	} else {
		collatz = (collatz * 3) + 1
	}

	System.out.println(collatz);
}
なお、while文を利用することで、無限ループを実現できます。図62に無限ループの例を示します。
Scanner scan = new Scanner(System.in);

while (true) {
	String s = scan.nextLine();

	if (s.length() > 5) {
		break;
	}

	System.out.println(s);
}
図62では break文 を使っています。break文は実行中の繰り返しを終了する文です。このプログラムの場合、入力された文字列の長さが6以上だった場合、ループを終了します。それ以外の長さの文字列があった場合、ループを継続します。
また、Cなどと同様に continue文もあります。continue文は繰り返し処理を中断する文です。中断した後、それ以降の繰り返し処理は行わず、先頭の条件式評価からやりなおします。
for文
for文は、for (初期化; 条件式; ループ後処理)で定義される、繰り返し文です。for文開始時に、初期化がなされ、ついで条件式が評価され真であれば、繰り返し処理を実施します。繰り返し処理が終わるたびにループ後処理を実行して、再び条件式が評価され真であれば、繰り返し処理を繰り返す文です。
一般的にループ回数の上限が定まっているため、不用意なループを繰り返すことが少なく、意図したプログラムを作成しやすいため、なるべくfor文を利用した繰り返しをすべきです。
for文の利用例を図63に示します。
int[] nums = new int[5];
nums[0] = 10;
nums[1] = 5;
nums[2] = 6;
nums[3] = -5;

int sum = 0;
for (int i = 0; i < nums.length; i++) {
	sum = sum + nums[i];
}

System.out.println("array sum: " + sum);
また、Javaではfor文の配列オブジェクトやリストオブジェクトなど、連続したデータを扱うための特殊な記法があります。これを拡張for文と呼びます。
図64に拡張for文を使った繰り返し例を示します。
int[] nums = new int[5];
nums[0] = 10;
nums[1] = 5;
nums[2] = 6;
nums[3] = -5;

int sum = 0;
for (int x: nums) {
	sum = sum + x;
}

System.out.println("array sum: " + sum);
図64のプログラムの処理内容は、図63の内容と変わりません。唯一違う内容としては、for文の定義の箇所です。拡張for文では、初期化、条件式およびループ後処理がありません。その代わりfor (一時変数: 走査する配列)のような定義となっています。このfor文では、走査する配列に与えられた配列やリストに対して、先頭インデックスのデータから順に、ループごとに一時変数へ代入します。そして繰り返し処理を実施します。繰り返し処理終了後、一時変数へ代入されているデータを配列インデックスをずらして、代入しなおし、再び繰り返し処理を行います。この処理を全ての配列内のデータに対して行うまで(走査しきるまで)繰り返し処理を行います。
このように拡張for文は、配列内の全データあるいはリスト内の全データについて、繰り返し処理を行う際に、for文よりも簡潔に記述できます。
メソッドについて
この節の要点
- メソッドとはオブジェクトに含まれる関数のことである。
- 関数とメソッドの違いは、引数に基づいて処理が変わるのが関数、オブジェクトの内部状態に基づいて処理が変わるのがメソッドである。
- メソッドを呼び出すためにはオブジェクトを介して呼び出す方法、あるいはクラスを介して呼び出す方法の2種類がある。
- オブジェクトを介してメソッドを呼び出すためには、
new演算子を使ってオブジェクトを作らなければならない。クラス名.メソッド名()のように.(ピリオド)を介してクラスから直接呼び出すことができるメソッドをクラスメソッドと呼ぶ。
メソッドとは、先に述べたようにプログラムの処理を1まとまりにして名前を付けたものです。この名前を使って処理を呼び出すことができます。Cなどの、関数をイメージしてもらえば、それとほぼ同等の意味ですが、少し意味合いが異なります。
まず、Cの関数をソースコードに定義する際に、なるべく近い目的の関数が集められて定義されますが、特に制約はありません。
対して、メソッドはクラス内に定義する際に、クラスから作られたオブジェクトが持つデータを改変する・利用して実現される目的で定義されます。 つまり、オブジェクトが表現する役割、に対して操作が定義されます。
この違いを見るために例として、電灯の機能をプログラムで実現してみます。Cであれば、例えば以下のように定義できます。
- データ
- 電灯を表す情報が集められた構造体(変数の集合)
- 操作
- 渡された電灯をオンにする関数
- 渡された電灯をオフにする関数
直感的に、データが先に定義され、それを使った操作を定義するでしょう。では次に、以下のような電灯オブジェクトを例に挙げて考えてみましょう。
- 電灯オブジェクト
- データ
- スイッチの状態: ONかOFFか
- 操作
- 電灯をオンにする
- 電灯をオフにする
- データ
ここで仮定した電灯オブジェクトは、データであるスイッチの状態を変更する操作から構成されています。 これを見る限り、まず、電灯そのものをオブジェクトに置き換えて、その電灯に対する操作(メソッド)を定義しています。
以上をまとめると、関数は定義するにあたって特に制約はなく、メソッドは定義するにあたってクラスの役割に沿う、という違いがあります。
また、Cの関数は定義されているソースコードを読み込みさえすれば、関数名を使ってどこでも呼び出すことができました。 ですが、メソッドはクラス内に定義されており、つまりクラスが持っているわけです。つまり、何らかの形でクラスを介してしかメソッドを実行できません。
メソッドを実行する際には、次の2つの方法があります。
- オブジェクトを介してメソッドを呼び出す。
- クラスを介してメソッドを呼び出す。
オブジェクトを介してメソッドを呼び出している例を図65に示します。
Scanner scan = new Scanner(System.in); // クラスからnew演算子でオブジェクトを生成
String input = scan.nextLine(); // オブジェクトを介してメソッドを呼び出し
まず、new演算子を使って、ScannerクラスからScannerオブジェクトを作成し、scan変数に代入します。
このscan変数(が指し示すScannerオブジェクト)を介して、nextLineメソッドを呼び出しています。
このように、(オブジェクトが割り当てられた変数名).(メソッド名)のようにピリオドを使ってオブジェクトの内部にあるものを呼び出しているわけです。
一般的に、Javaではこのオブジェクトを介したメソッド呼び出しを主体にプログラムが構成されます。
次に、クラスを介してメソッドを呼び出している例を図66に示します。
String nstr = "42";
int x = Integer.parseInt(nstr); // クラスを介したメソッド呼び出し
このIntegerクラスは整数を表すクラスで、parseIntメソッドは文字列を整数型に変換するメソッドです。先のオブジェクトを介したメソッドと違う点は、new演算子を使ってオブジェクトを作成することなく、(クラス名).(メソッド名)のように、ピリオドを使ってクラスから直接呼び出しています。
このようなクラスを介して直接呼び出すことができるメソッドのことを クラスメソッド と呼びます。
Javaでは、以上の2種類のメソッドがあって、これらを場合に応じて定義、利用します。
なおこれ以降、特に指定がない限り、単に メソッド と記述している場合はオブジェクトを介した呼び出し方ができるメソッド\(\dagger\) 、クラスメソッド はクラスを介した呼び出し方ができるメソッドとします。
\(\dagger\): なお非クラスメソッドはインスタンスメソッドと呼ばれることが多いです。これはオブジェクト(インスタンス)を介した呼び出し方をするメソッドであることに由来します。ですが、本演習ではインスタンスの定義を避けたため、この呼称を使わないようにしています。
実験課題5
Exercise 5(課題5) See the section 1.9.1. "Class Method". Then create the sample program with the class method to calculate the summation: \(\sum_{i=1}^{n} (3i-1)\) by creating the project chapter1kadai5. In this program, \(n\) is should inputted from keyboard. Further, show the sourcecode and execution result as the screenshot. Hint. see Figure 63.
(1.9.1.節をよく読み、プロジェクト名chapter1kadai5のJavaアプリケーションプロジェクトを作成して、1から引数で与えられた数字\(n\)について総和\(\sum_{i=1}^{n} (3i-1)\)を求めるクラスメソッドを作成しなさい。そしてクラスメソッドを利用した実行例を独自に作成して、ソースコードと実行結果を報告しなさい。)
クラスメソッド
この節の要点
- メソッド名の前に
staticを付けることでクラスメソッドを定義できる。mainメソッドはクラスメソッドである。
クラスメソッドを定義するためにはメソッドの修飾子にstaticを付けることで定義できます。
ここで、メソッド名と返り値の型、引数の数や型が定義されている1行のことをメソッドシグネチャと呼びます。
たとえば、mainメソッドであれば、図67に示す部分がメソッドシグネチャです。
public static void main(String[] args)
mainメソッドのシグネチャを見れば分かるように、Javaにおけるmainメソッドはクラスメソッドです。
シグネチャの見方は図68のとおりです。メソッドを定義する際にはこの順序に則って、記述します。
[アクセス修飾子] [static] 返り値の型 メソッド名(引数の型 引数名 ...)
基本的にはCなどの関数の見方とおなじですが、アクセス修飾子とstatic修飾子が新しく導入されています。
mainメソッドをシグネチャに則って読み解くと、
- 引数は1つ
- 第1引数として渡されるデータは
String型配列で引数argsとして受け取る
- 第1引数として渡されるデータは
- 返り値はvoid型
- つまり値を返却しない
- publicアクセス可能なクラスメソッド
- publicアクセスの意味については後の章で説明します。
であることがわかります。
以上を踏まえて、クラスメソッドを定義例を図69に示します。ここでは、mainメソッドが定義されているクラスに、同じく定義しました。
public static int addIntegers(int a, int b) {
	int x = a + b;
	return x;
}

public static void main(String[] args) {

	Scanner scan = new Scanner(System.in);
	String input = scan.nextLine();

	String[] nums = input.split(" ");

	int x = Integer.parseInt(nums[0]);
	int y = Integer.parseInt(nums[1]);

	int z = addIntegers(x, y); // addIntegersクラスメソッドの呼び出し
	System.out.println("sum: " + z);
}
なお、クラスメソッドはクラスメソッドから呼び出せますし、メソッドからも呼び出すことができます。図5の例では、mainクラスメソッドからaddIntegerクラスメソッドを直接呼び出しています。これはaddIntegerメソッドがstatic修飾子を持っているから可能なわけです。
ですが、クラス内に非クラスメソッドとして定義したメソッドを、クラスメソッドのように呼び出すことはできません。
なぜならば、非クラスメソッドは生成されたオブジェクトが持つデータを利用することが前提ですから、クラスを介してクラスメソッドを呼び出している時は呼び出し元のオブジェクトが用意されていないため、呼び出すことができないのです。
実験課題6
Exercise 6(課題6) See the section 1.11.1. "Package". Then create the ArrayPrinter class of Fig. 74 to array.utils package in the project chapter1debug. Further, create the following main and initArray method that initialize a specified array with a sequence from 1 to the array length (see the following figure depicts it). Then, show the sourcecode and execution result as the screenshot.
public static void initArray(int[] a) {

	for (int i = 0; /* 考えてください */; i++) {
		/* 考えてください */
	}
}
public static void main(String[] args) {

	Scanner scan = new Scanner(System.in);

	int x = 0;

	/*
		このコメント部分に入力された文字列を整数型データに変換して、
		変数xに代入するプログラムを考えてください。
	*/

	int[] arr = new int[x];

	ArrayPrinter.printInt(arr);

	ArrayPrinter.initArray(arr);

	ArrayPrinter.printInt(arr);
}
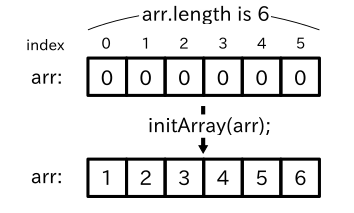
(1.11.1.節をよく読み、プロジェクト名chapter1debugのJavaアプリケーションプロジェクトを作成して、図74に示すarray.utilsパッケージとそれに含まれるArrayPrinterクラスを作成し、さらに以下の要件を満たすinitArrayクラスメソッドをArrayPrinterクラスに追加しなさい。そしてChapter1debugクラスのmainメソッドを/**/で囲われたコメント文の箇所を穴埋めして完成させ、ソースコードと実行結果を報告しなさい。なおinitArrayクラスメソッドは引数として渡された配列データの0番目を1、1番目を2、n-1番目をnに初期化することが要件である。)
パッケージ
この節の要点
- パッケージはクラスをまとめたフォルダのようなものである。
- 自分が属するパッケージ外のクラスを使う際は、
import文を使ってそのクラスが属するパッケージを指定する必要がある。
Cでは、外部のライブラリで定義されている関数を使いたい時、そのライブラリを読み込んで、関数名を使って呼び出します。ここで、複数のライブラリを読み込んだ時に、もし、それぞれのライブラリに同名の関数が定義されていた場合、関数名前の衝突が起こり、読み込むことができません。
これを防ぐためには、関数名を注意深く設定する必要があります。その結果、関数名が長大になったり、見ただけで何をする操作なのかわからないなど、弊害が生まれます。
Javaでは、先に述べた パッケージ(Package) をつかうことで、名前の衝突を避けることができます。
以下に例を示します。ここでは、array.utilsパッケージを作成し、その中にArrayPrinterクラスを作成してみましょう。
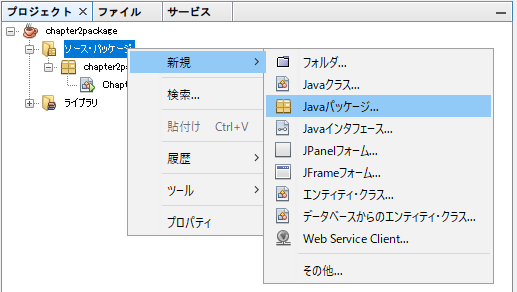
まず、プロジェクトペインの現在のプロジェクトの中のソースパッケージを選択した状態で右クリックし、新規 > Javaパッケージ...を選びます(図71)。
New Javaパッケージダイアログにて、パッケージ名をarray.utilsとして終了を選びます。
次に、同じくプロジェクトペインで作成したパッケージarray.utilsを選択した状態で右クリックし、新規 > Javaクラス...を選びます(図72)。
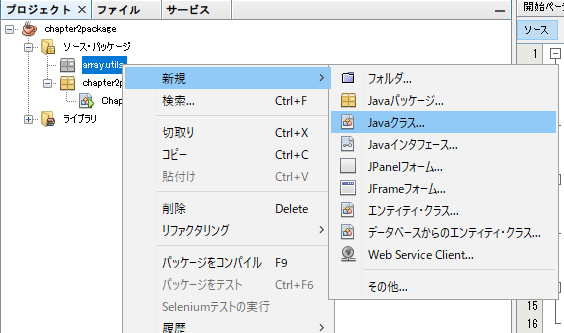
New Javaクラスダイアログにて、クラス名をArrayPrinterとして終了を選びます。
すると、エディタペインに、ArrayPrinterクラスのソースコードのひな型が開かれます。
このひな型をみると先頭に図73にしめすpackage文が明記され、空の状態のArrayPrinterクラスがarray.utilsパッケージに属した状態で作成されていることがわかると思います。
package array.utils;
図74に示すソースコードのArrayPrinterクラスのようにprintIntクラスメソッドを持つように変更しましょう。
public class ArrayPrinter {

	public static void printInt(int[] arr) {

		for (int i = 0; i < arr.length; i++) {

			System.out.print(" " + arr[i]);
		}
		System.out.println();
	}
}
続いて、作成したarray.utilsパッケージに含まれるArrayPrinterクラスのprintIntクラスメソッドをmainメソッドから呼び出してみたいと思います。
図75に示すようにプロジェクトを作成した際に初めに作成されるクラスのmainメソッドを改変してみましょう。
int[] x = new int[]{2, 7, 1, 8, 2, 8, 1}; // 配列オブジェクトの割り当てと初期化を同時に行う記法

ArrayPrinter.printInt(x);
ここで、図75の1行目の書き方は、配列型変数に、配列型オブジェクトを作成し初期化したものを割り当てる方法です。この書き方は図76に示すの書き方と同じです。
int[] x = new int[7]; // 長さ7のint型配列オブジェクトの割り当て
x[0] = 2; // 以下、配列オブジェクトの初期化
x[1] = 7;
x[2] = 1;
x[3] = 8;
x[4] = 2;
x[5] = 8;
x[6] = 1; // 配列オブジェクトの初期化、以上
このままでは正しく実行できずエラーとなります。なぜならば、ArrayPrinterクラスが含まれるパッケージを指定できていないためです。
エディタをよく見ると、図77に示すように、 赤波線がエラーが起こる箇所に表示されます 。ここで、マウスカーソルでこの波線上にフォーカスを合わせると、エラー内容が記述されたポップアップが表示されます。
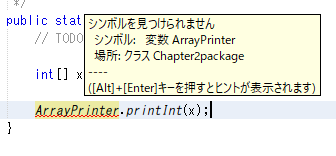
先に示したように、パッケージを指定した呼び出し方は、array.utils.ArrayPrinterのようにパッケージ名とクラス名をピリオドでつないで呼び出すか、import文を使ってあらかじめarray.utilsパッケージのArrayPrinterクラスを読み込んでパッケージ名を省略して呼び出す、2種類の方法があります。
ここでは、IDEを使ったコードアシスト機能を使って、import文を使ったパッケージを読み込む方法を実施してみましょう。赤波線の箇所をクリックして、テキストカーソルを赤波線に合わせます。その後、Alt+Enterキーを押してみましょう。図78に示すような修正候補を提示してくれます。
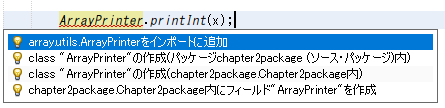
ここでは、一番上の項目であるarray.utils.ArrayPrinterをインポートに追加を選びましょう。
すると、自動でソースコードの先頭にimport array.utils.ArrayPrinter;の1文が追加され、赤波線が消えたはずです。
以上のように、IDEの機能を使うことで効率的なエラー修正が可能です。
このように、IDEでプログラミングをすることでコードアシスト機能を使うことができ、わざわざ独自にimport文を記入せずとも、簡潔にプログラムを作成できます。
実験課題7
Exercise 7(課題7) See the section 1.10.1. "Package". Then add printDouble class method to ArrayPrinter class in chapter1debug project. The printDouble method shows the all data of passed double type array object. Further, create sample program to use printDouble method and show the sourcecode and execution result as the screenshot.
(1.10.1.節をよく読み、chapter1debugプロジェクトのArrayPrinterクラスに、新たにdouble型配列の中身を表示させるprintDoubleクラスメソッドを作成し、mainメソッドをprintDoubleを活用するように独自に改変し、それらソースコードと実行結果を示しなさい。ここで、mainメソッドを独自に改変する例として、長さxのdouble型配列を作成しprintDoubleメソッドの引数として渡して呼び出す、と言ったものが挙げられる。)
レポート課題
Homework 1(調査課題1) Explain the difference between the reference type and the primitive type. Hint. see the section 1.3.1. "About Type".
(参照型とプリミティブ型の違いを説明しなさい。)
Homework 2(調査課題2) Explain what new operator is for. Hint. see the section 1.3.1. "About Type".
(new演算子はどのような場合に使われるか、説明しなさい。)
Homework 3(調査課題3) Explain the advantage of import keyword in Exercise 2.
(課題2にて実施したimport文はパッケージ名を直接記述して参照する方法と違って何が良いか、説明しなさい。)
Homework 4(調査課題4) Explain why the Java program cannot compare between two string objects by using ==. e.g. "Software" == "Hardware" . Hint. see the section 1.3.1. "About Type".
(文字列オブジェクトの比較として==演算子がなぜだめなのか(例: "ソフトウェア" == "ハードウェア")、調べて説明しなさい。)
デバッグ
プログラムを作成するにあたって、頭に描いた処理手順をキーボードからソースコードとして入力(コーディング)して、コンパイル、続けて実行をしたとき、果たして期待した結果を思い通りに実装できるでしょうか。エラーなしの期待通りのプログラムをミスなしで作れるでしょうか。大体のプログラマは、コーディング、コンパイル、コンパイルエラー、コード修正、コンパイル、実行、結果がおかしい、コード修正...のように、修正とコンパイルおよび実行を繰り返し行って正しいプログラムを形作っていくものです。
このコード修正作業は、プログラム作成の一連の流れにおいて一番要所でかつ一番退屈な部分でもあり、プログラム作成活動のなかでもっとも多くの時間を占めています。
コード修正は、大別して、プログラミング言語の文法に則っておらずコンパイルできない状態(コンパイルエラー)に伴うコード修正 と、実行結果を期待通りの結果に修正するためのコード修正 、の2つに分けられます。
このうちコンパイルエラーに伴うコード修正は、エラーメッセージを元にソースコードを修正すればよいわけです。それよりも、期待通りの結果に修正するためのコード修正の方がはるかに頻出することになり、いかにこれを解決するかが重要になるわけです。この期待通りの動作となることを妨げるプログラムの不具合をバグ(Bug) と呼び[2]、バグの訂正にかかるコード修正のことを デバッグ(Debugging) と呼びます。
この節では、統合開発環境(IDE)のNetBeansを使って、デバッグの仕方に触れていきます。
[2]: The Jargon File (19/04/02 閲覧)
実験課題1
Exercise 1(課題1) See the section from 2.1.1. "About Exception" to 2.1.2. "printf Debugging". Show the execution result of Figure 4 by using printf debugging like Figure 7. Further, explain the cause of failures and propose the fix. Follow the instructions below to show the result.
- create the Java application project named
chapter2kadai1. - create
mainmethod to run this program. - take a screenshot of the execution result.
(2.1.1.節から2.1.2.節をよく読み、chapter2kadai1プロジェクトを作成し、2.1.2.節の手順に則って、図8のように図4のプログラムをprintfデバッグしなさい。その際、実行結果を示し、エラーの原因とエラーを訂正するためにはどうすればよいか説明しなさい。)
例外について
この節の要点
- Javaプログラムでエラーが発生したとき、例外(Exception) がプログラム上で発行される。例外の発行を投げる と呼ぶ。
- 例外はエラーの種類ごとに用意されている。たとえば、初期化していないオブジェクトを利用した場合NullPointerExceptionが投げられる。
あるメソッドが、想定外の入力に対して正しい出力・処理ができない際に、うまく動作しないこと(エラー)に対する処理をどのように表現すればよいでしょうか。
基本的に、プログラムの無理な(不正な)動作はメモリ上のエラーにつながることが多く、その大半はOSが最終的にはセグメンテーション違反(Segmentation fault)などのエラーを代わりに出力して、プログラムがクラッシュして、強制終了します。
しかし、長時間動き続けるプログラムにおいては、このような強制終了を避けなければなりません。なぜならば、いつ強制終了するかわからないわけですから、つねにプログラムを監視して、必要であれば再起動させる必要が生まれます。これではプログラムを使う利点が台無しです。プログラマは、意図しない強制終了がないように、プログラムの処理を組み立てていく必要があるわけです。
ではどのようにエラー処理を実現すべきでしょうか。たとえば、Cであれば、関数が想定している入力以外を受け付けた際は、直ちにエラーを表す数値を返却するようにしておきます。 そして、呼び出した関数側で、返却された値がエラーを表しているかどうかチェックをし、エラーであれば、それに対応したエラー復帰処理を実施する、と言った流れでエラー処理を記述することが一般的です。
ですが、他の人が設計し作成した複数のライブラリを利用して、プログラムを作成する場合において、このようなエラー処理を書くことは、作成者おのおのの統一されている保証がないエラー処理を理解した上で改変しなければなりませんから、新たなエラーの温床になりますし、エラーの伝播を考慮する必要がうまれ、プログラムのフローが複雑化します。
例外(Exception) とは、エラー処理のための言語機能です。ここでは、単純に 例外=エラー として捉えてください。例外はプログラムの処理中のどこでもthrow(投げる)することができます。
例えば、図1に示すような赤字で示されるエラーがコンソールに表示された経験があると思います。

これが、例外によるエラー表示になります。このように例外が不用意に発生すると、標準出力にその例外がどの箇所でどのような内容で発生したかが表示され、プログラムがそれ以降の処理を待たず終了します。
以下によく現れる例外を示します。
- NullPointerException
- 参照型変数の中身が
nullのとき、オブジェクトが本来持つ変数やメソッドを利用すると投げられます。
- 参照型変数の中身が
- ArrayIndexOutOfBoundsException
- 配列を、配列の長さを越えたインデックスを使って利用すると投げられます。
- NumberFormatException
- 引数としてメソッドに渡された文字列データが、数値データに変換できない形式であるときに投げられます。
- RuntimeException
- より一般的なエラーであることを表す例外です。コンパイル時にわからない、実行時にのみわかるエラーが発生した時、投げられます。
具体的に、図2に示すようなプログラムを実行してみましょう。
Scanner scan = null;	// 参照型の初期値を代入する

String input = scan.nextLine();	// Scannerオブジェクトが持つnextLineメソッドを呼び出す

System.out.println("next: " + input); // コンソールに表示する
図2のプログラムを実行すると、3行目で図3に示される例外が発生するはずです。図3で出力タブに表示された赤色文字がエラー出力であり、発生した例外の種類を示します。1行目を見るとNullPointerExceptionであることがわかります。また、エラーが発生した発生箇所をメソッド呼び出し毎に記録したログ(スタックトレース)も合わせて表示します。このスタックトレースの2行目を見ると、TextException.java:23を表示された、青文字が表示されていることが解ると思います。これは例外が発生したソースコード名と行数を表しており、この青文字をクリックすると、エディタペイン上で例外が発生した箇所にジャンプ(テキストカーソルが移動)します。
ここで、図2の3行目でNullPointerExceptionが発生すると、3行目以降は実行されず、プログラムが強制終了してしまいます。
printfデバッグ
この節の要点
- 変数のデータを処理ごとに標準出力(ターミナル)に表示しながらプログラムの状態を確認するデバッグ方法をprintfデバッグ と呼ぶ。
プログラムを実行中にエラーが起こった時、エラーが起こった箇所を特定するためにプログラム中の変数の中身や処理の流れを表示したいことがあります。このようなとき、ターミナルに処理毎に気になる変数の中身を表示させることをしたことがあるかもしれません。適宜System.out.println(Cではprintf)を使って確認したい変数を表示させる処理を追加し、実行してその表示された状態を確認しながら、期待通りの動作結果となるようにコード修正する、これを繰り返すデバッグ方法を printfデバッグ と呼びます[3]\(\dagger\)。
たとえば、図4のような繰り返しを使って配列の隣り合う中身を先頭から順に交換していく手続きを記述する際に、正しく操作されているか確認するためにprintfデバッグをすることができます。
int[] arr = new int[]{3, 1, 4, 1, 5, 9, 2};

for (int i = 0; i < arr.length; i = i + 1) {

	int x = arr[i];
	arr[i] = arr[i + 1];
	arr[i + 1] = x;
}
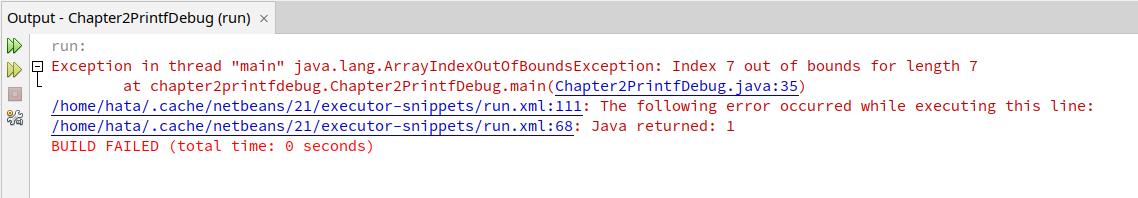
図4で示すプログラムは、配列内の隣り合う要素を先頭インデックスから順に入れ替えていくプログラムを意図しています。ですが、図4を実行すると、ArrayIndexOutOfRangeExceptionが発生します(図5)。このArrayIndexOutOfRangeExceptionがなぜ発生したのか、コード修正を行うためにprintfデバッグを行ってみましょう。
第1週の課題6にて、作成したArrayPrinterクラスのprintIntメソッドが役に立ちそうです。パッケージ機能を使って呼び出してみましょう。
プロジェクトペインで、現在のプロジェクトツリー内にあるライブラリフォルダを右クリックし、右クリックメニューからプロジェクトの追加...を選びます(図6)。プロジェクトの追加ダイアログにて、chapter1debugを選択し、プロジェクトJARファイルの追加を選択してください(図7)。これにより、既に作成してある別プロジェクトのプログラムを読み込み、パッケージ名を指定することで呼び出すことができます。
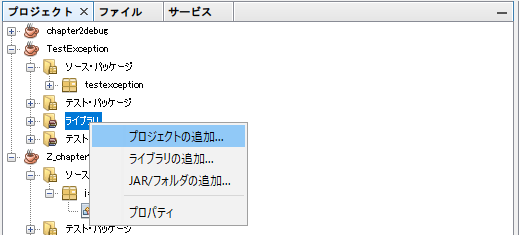
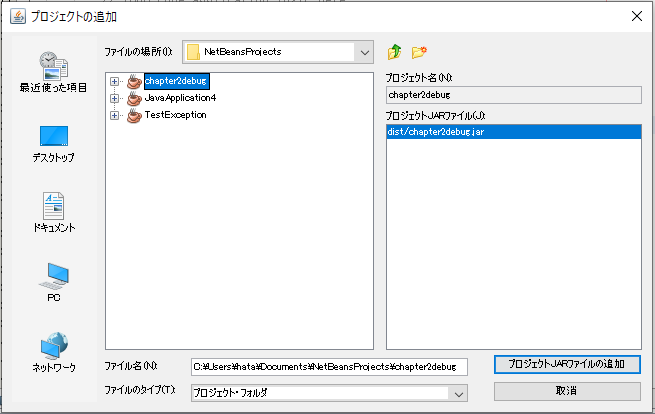
図8で示すように、ループ中に、標準出力する命令を追加しプログラムを実行することで、強制終了する時の状態を確認しながらプログラムを作成できます。
int[] arr = new int[]{3, 1, 4, 1, 5, 9, 2};

for (int i = 0; i < arr.length; i = i + 1) {

	System.out.println("ループ回数:"+i); // ループ回数を表示してみる
	ArrayPrinter.printInt(arr); // 配列の中身がどのように変化しているか表示してみる

	int x = arr[i];
	arr[i] = arr[i + 1];
	arr[i + 1] = x;
}
図8の実行結果を図9に示します。この結果をみると、ループ回数が6のとき、すなわちi=6のときエラーが起こっていることがわかります。また実行結果の図から35行目(図10)でエラーが起きていることもわかります。
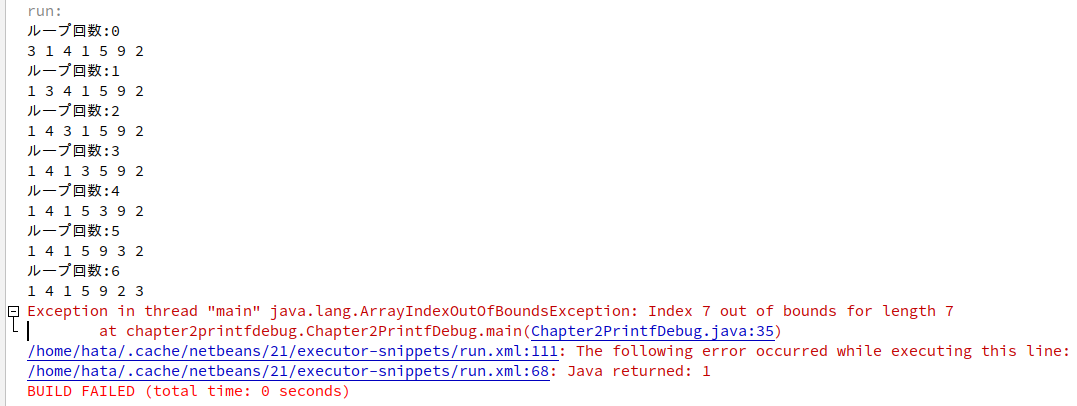
図10のプログラムの内容と標準出力に表示させた変数の値i=6から、標準出力にデータを表示させないときよりも容易にエラーを特定することができるはずです。
arr[i] = arr[i + 1];
[3]: printf() debugging - Everything2.com (20/06/04 閲覧)
\(\dagger\): Caveman Debuggingなどその他の呼称も存在しますから、この呼称がデファクト・スタンダードというわけではないです。しかし、Cを経験したことがあるプログラマであれば、どのようなことを指し示すのか理解できます。
実験課題2
Exercise 2(課題2) See the section 2.1.2. "printf Debugging". Explain the reason why the following method can not execute by following instructions.
- create the Java application project named
chapter2kadai2. - create
calcDivisorsmethod andmainmethod in the same Main class. - add some codes for the printf debugging to the class.
- take a screenshot of the execution result.
public static void calcDivisors(int n) {

	for (int i = 0; i <= n; i = i + 1) {

		if (n % i == 0) {

			System.out.print(i + " ");
		}
	}
	System.out.println();
}
calcDivisors to enumerate all divisors of n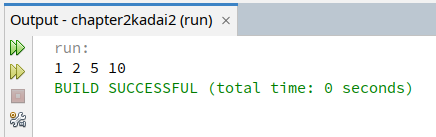
calcDivisors method with n = 10(2.1.2.節をよく読み、chapter2kadai2プロジェクトを作成し、与えられたnの約数をすべて表示するcalcDivisorsメソッドと、calcDivisorsメソッドを実行するmainメソッドを作成しなさい。そしてprintfデバッグを行ってiやnがどの値のときに例外を発生するのか、エラーの原因を説明しなさい。)
実験課題3
Exercise 3(課題3) See the section 2.3.1. "Usage of Debugger". Show the screenshot of "variable tab" in the debugger just before throwing exception in the program of Figure 12 and Figure 13, the debugged sourcecode, and its execution result. Further, explain what variables should assign in variable tab and cause the exception throwing and propose the fix. Follow the instructions below to show the result.
- create the Java application project named
chapter2kadai3. - create
mainmethod to run debugged program. - take a screenshot of the execution result.
(2.3.1.節をよく読み、プロジェクトchapter2kadai3を作成し、図12および図13に示すプログラム作成しなさい。更にデバッガを使ってデバッグし、例外が発生する直前の状態の変数タブの内容をスクリーンショットで示しなさい。その結果、変数タブの中で.99999999のような数値を取る変数は正しくはどの様な値を変数が持っておくべきなのか、例外が発生した理由にどう関係するのか説明し、正しく動くコード修正を行ってそのソースコードと実行結果を示しなさい。)
デバッガの使い方
この節の要点
- プログラムを実行しながら、処理を一時停止し変数内のデータなどを確認することができるデバッグ支援のソフトウェアをデバッガと呼ぶ。
- デバッガでプログラムを一時停止させるためには、ブレークポイントをソースコード中に設定してあげる必要がある。
- デバッガでのデバッグ時に、現在の行を実行して次の行に進む手続きをステップオーバー、現在の行のメソッド内に進む手続きをステップイン、そして現在の行があるメソッドの呼び出し元に戻る手続きをステップアウトと呼ぶ。
- ブレークポイントを使って一時停止させている時、変数タブに現在使われている変数が持つ値が表示される。
デバッガ(Debugger)とは、デバッグ作業を補助するソフトウェアです。具体的には、プログラムを指定した箇所で一時的に停止させ、その際にプログラム内で利用している変数の中身を確認することができます。このデバッガを使い処理の途中で変数がどのような値となるか適宜確認することで、大規模であったり複雑なプログラムの修正を効率的に行うことができるようになります。
C言語などでは、GDBと呼ばれるターミナルで実行できるコンソールデバッガなどがあります。統合開発環境(IDE)には、先に示したコード補完だけでなく、こうしたデバッガももちろん含まれています。
以降では、NetBeansのデバッガの利用例を示していきます。
図11のプログラムを実行してみましょう。このプログラムは指定された範囲で指定された数だけの目盛りを作成することを意図しています。
public static double[] createAxis(int n, double min, double max) {

	double tick = (max - min) / n;

	double[] axisdata = new double[n + 1];

	int tickcnt = 0;
	for (double x = min; x < max; x = x + tick)
	{
		axisdata[tickcnt] = x;
		tickcnt++;
	}
	axisdata[tickcnt] = max;

	return axisdata;
}
double[] arr = createAxis(5, 1.0, 20.0);

ArrayPrinter.printDouble(arr);
なお、createAxisクラスメソッドとmainメソッドは同じクラスが持ちます(図11、図12)。
ここで、図12の1行目を図13のように改変してcreateAxisメソッドを利用してみるとします。すると図14に示すように、例外ArrayIndexOutOfRangeExceptionが発生してしまいました。
double[] arr = createAxis(10, 1.0, 20.0);
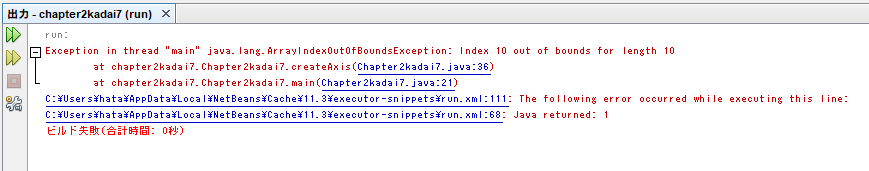
この例外が発生した理由をデバッガを使って見ていきましょう。
デバッガを起動するためには、メニューバーからデバッグ(D) > プロジェクト()をデバッグ(D)を選択するか、ツールバーの緑三角ボタンであるプロジェクト実行アイコンの右隣のアイコン(図15)を押すことで、プロジェクトペインで選択しているプロジェクトをデバッグすることができます。
ただ、このままデバッグを実行しても、普通にプログラムが実行され、終了するだけです。デバッグをするためには、 ブレークポイント(breakpoint) を設定する必要があります。
ブレークポイント とは、デバッグで一時停止させる地点のことです。ブレークポイントを設定して、デバッガを起動すると設定されたブレークポイントの命令を実行する直前で、プログラムが一時停止します。
例えば、先に述べたmainメソッド中のcreateAxisメソッドを呼び出す際にブレークポイントを設定してみたいと思います。
ここで、エディタペインの左端に行数が表示されていますが、ブレークポイントを設定したい行数をクリックすると、 赤四角が表示され、行背景が赤色に強調されます (図16)。赤色に強調された行は、ブレークポイントが設定されていることを示しています。ブレークポイントを削除したい場合は、もう一度クリックすることで削除することができます。
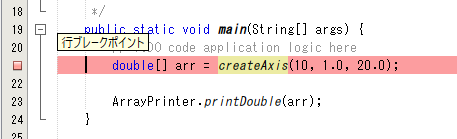
この状態で、デバッガを起動してみましょう。すると図17に示すように、行数の代わりに緑矢印が表示され、エディタペインの行背景が緑色に変化し、プログラムが一時停止した状態で、出力タブと同じペインに変数タブが現れ、変数タブが表示されます。
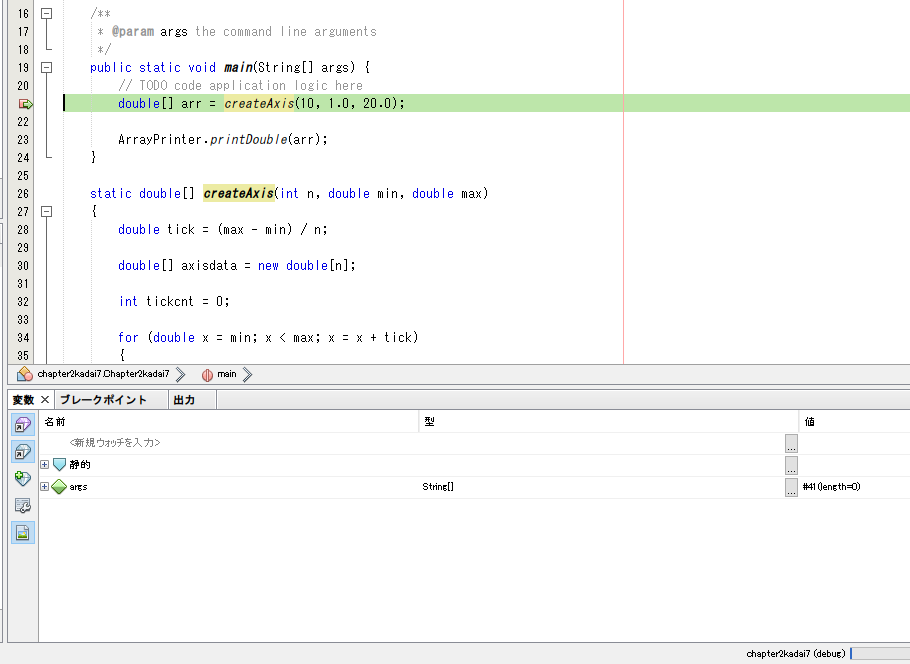
緑色に強調された行が、現在実行せずに一時停止している命令 になります。 ここで、この変数タブには、その時点でプログラムで定義されている変数名とその変数が持つ値が表示されます。 この変数タブを使うことで、先のprintfデバッグのような変数の標準出力への表示をすることなく(またそのためのコード改変をする必要もなく)、容易にデバッグ出来ます。
なお、ブレークポイントはデバッガ実行中であっても、設定・削除を自由にすることができます。
一時停止させた状態で、デバッガを終了させたい場合はツールバーにある、 赤四角のデバッガ・セッションを終了アイコンを選択することでデバッグ終了します (図18)。
また、一時停止させた状態で、次のブレークポイントまで実行させたい場合はツールバーにある、 緑丸の続行アイコンを選択することで一時停止していたプログラムを再起動できます (図18)。
デバッガの機能は、このようなブレークポイントごとのデバッグのみではなく、 ステップ実行 することで、ブレークポイントを起点とした各命令実行時の変数の状態を確認できます。
ステップとは命令呼び出しの1単位を表します。この場合、ソースコードの命令1行が1ステップに相当します。ステップ実行とは、1ステップ実行し一時停止させるデバッグの実行方法です。
ステップ実行には、大まかに分けて、 ステップオーバー 、 ステップイン 、 ステップアウト の3つの方法があります。
ステップオーバー とは、現在の命令を実行し、単純にソースコード上でテキスト空間的に隣接している次の1命令に移動して一時停止させます。すなわち、デバッガで一時停止している状態で、一時停止している命令がメソッド呼び出しであったとしても、ステップオーバーすると、メソッド呼び出しを行いその返り値を取得した後、そのメソッドの次の命令を実行する前で一時停止させます。ステップオーバーするためには図19のアイコンをクリックします。
ステップイン とは、プログラム的に次に実行される命令で一時停止させます。つまり、デバッガで一時停止している状態で、一時停止している命令がメソッド呼び出しであれば、ステップインすると、その呼び出したメソッド内の最初の命令で一時停止させます。ステップインするためには図20のアイコンをクリックします。
ステップアウト とは、現在一時停止している命令が属しているメソッドを最後まで実行し、呼び出し元でその返り値を取得させた後、次の命令を実行する前で一時停止させます。ステップアウトするためには図21のアイコンをクリックします。
例えば、図17に示すcreateAxisクラスメソッドを実行する前で一時停止している状態から、ステップインしてみましょう。すると、図22のように、createAxisクラスメソッド中の先頭の命令行が緑背景になっていることがわかります。
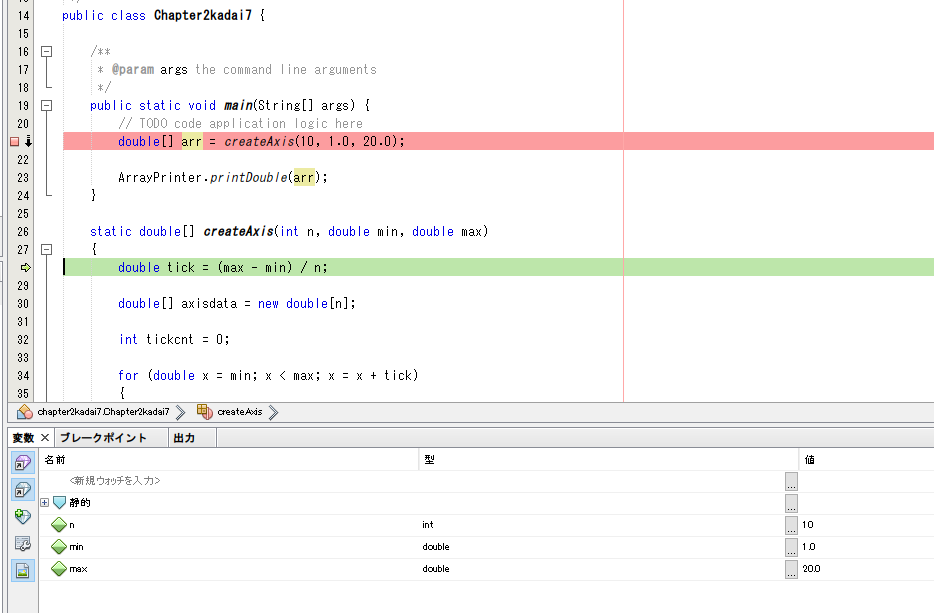
このとき、まだ緑背景の命令は実行されていません。現時点での、変数の割り当て状況を確認してみましょう。図22の変数タブを見ると、メソッドの引数に何が割り当てられたかが表示されています。ここで、ステップオーバー1回行うと、1ステップ移動します。ステップオーバーを使うことで細かく移動することができますが、目的の命令まで複数回選択することは面倒です。したがって、ブレークポイントをもう1つ設定してみましょう。今回は、for文の最初の命令の箇所にブレークポイントを設定してみます(図23)。
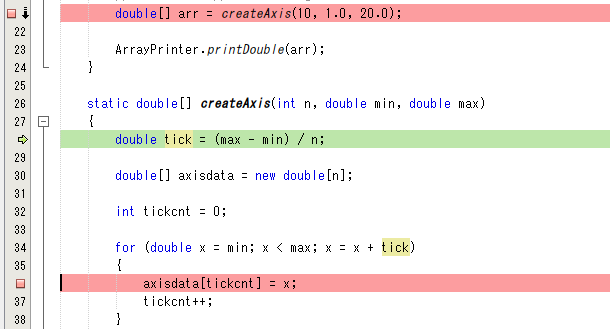
図23のようにブレークポイントを設定した後、続行アイコンを押すと、一気に次のブレークポイントまで実行がなされます。
ここで、デバッグの注意点ですが、 ソースコードを変更する際には、必ず、デバッガセッションを終了アイコンを選択するなどしてデバッガを終了させておく 必要があるので注意してください。
以上のように、ステップ実行とブレークポイントを使いこなすことで、デバッグを効率的に進めることができます。
実験課題4
Exercise 4(課題4) See the section 2.3.1. "Usage of Debugger". Show the sourcecode, the execution result that has the sort method in the following Figure, and the screenshot of "variable tab" in the debugger just before entering internal for loop at the second time iteration of external for in the program. Further, introduce modified sourcecode to sort correctly. Follow the instructions below to show the result.
- create the Java application project named
chapter2kadai4. - create
mainmethod to sort following contents in double array by usingsortmethod in following figure. - take a screenshot of the execution result.
[2.0, 2.2, 1.5, 5.0, 3.0]
[5.0, 3.0, 2.2, 2.0, 1.5]
/**
 * バブルソートによって配列をソートする。
 * @param n 配列の長さ
 * @param array ソートする配列
 * @return ソートした配列
 */
public static double[] sort(int n, double[] array) {

	for (int j = 0; j < n; j = j + 1) {
		for (int i = j; i < n - 1; i = i + 1) {
			if (array[i] < array[i + 1]) {
				double t = array[i];
				array[i] = array[i + 1];
				array[i + 1] = t;
			}
		}
	}
	return array;
}
(2.3.1.節をよく読み、プロジェクトchapter2kadai4を作成し、下図のメソッドを作成して、下に示すdouble型配列の中身を図のsortメソッドに渡して、その結果を表示させるプログラムを作成しなさい。その際、デバッガを使ってデバッグし、外側のfor文のループ毎に、内側のfor文に入る直前の状態の変数タブの内容をスクリーンショットで示しなさい。また、その結果どのような変数の値であれば問題ないのか、プログラムが正しくソートするためにはどのように改変すればよいか説明しなさい。)
実験課題5
Exercise 5(課題5) See the section 2.5.1. "About Exception Handling". Show the screenshot that an exception emerges in the calculator program of 1st week's exercise 6. Further, show the modified source code of it and its result as the screenshot of the program debugged by adding try-catch statement for its exception detection.
(2.5.1.節をよく読み、第1週の課題4で作成した電卓プログラムで、例外が発生する実行例をスクリーンショットを撮って示し、try文を使って処理を継続するコード修正を行い、訂正後のソースコードと、実行結果のスクリーンショットを示しなさい。)
例外処理について
この節の要点
- 例外が発生しそうな箇所をあらかじめtry文で囲っておくことで、catch節に復帰処理を書くことができる。
先に述べたように、プログラムを実行し続ける必要がある場合、例外が発生する可能性があればプログラムが停止してしまう可能性があるわけで、そのまま放置しておくわけにはいきません。デバッグをすることで例外が発生しないようにプログラムを書くべきです。しかしながら、すべてのエラーの可能性を踏まえてプログラムを書くことは大変です。そのため例外機構には、次のtry文 (try block)とcatch文 (catch block)とよばれる、例外が発生した際に強制終了することなく、エラー処理を記述できる仕組みが用意されています。
int x = Integer.parseInt("a"); // 文字列aを整数型データに変換を試みるが失敗

System.out.println("result: " + x);

図24に示すプログラムでは、文字列データを整数型データに変換するに当たって、文字列データに変換できない文字が含まれているため、NumberFormatExceptionが発生してしまいます(図25)。
try文とcatch文を使うことで図26のように書き下すことができます。
int x = 0;

try {
	x = Integer.parseInt("a");

} catch(NumberFormatException e) {

	x = -1;
}

System.out.println("result: " + x);
try文は例外が投げられるであろう可能性がある命令を事前に囲っておくことで、例外が投げられた際に、tryブロック中のそれ以降の処理を中断し、対応する例外が割り当てられたcatch節のブロックの処理を実行します。つまり、try節で例外の捕捉を行い、catch節にはエラー復帰処理を書くことになります。その結果、図26を実行すると例外が発生するものの、復帰処理を行うことでプログラムを正常に実行終了しています(図27)。

レポート課題
Homework 1(調査課題1) Investigate serious effects for real world issues by causing bugs.
(バグが現実社会に与える深刻な影響を調査して報告しなさい。)
Homework 2(調査課題2) Investigate the disadvantage of try-catch statement in the program.
(try-catch文の短所を調査して報告しなさい。)
Homework 3(調査課題3) What is the name of the error in Excercise 3 ?
(課題3で発生した誤差はなんと呼ばれるか、調べて報告しなさい。)
構造化プログラミング
時代と共に計算機環境や実装先環境の推移などの技術基盤に変化はあれど、基本的に我々の社会システムを自動化するに当たって、計算機上で動く巨大なプログラムを作成する必要性があることは、コンピュータが身近に広まりつつあった1960年代から今日に至るまで変わらない事実です。
社会システムの自動化などと大げさな例でなくとも、身近な生活に溶け込んでいる製品を動かすためのプログラムも例に漏れません。
例えば、iOS向けの単純なゲームであればソースコードの行数は約1万行[4]、心臓のペースメーカーの制御プログラムは約8万行[4]、DVDプレイヤーの再生ソフトウェアは約470万行[4]、Android OSは約1200万行[4]、そしてWindows XPは約4500万行[5]、といった具合です。
このような巨大なプログラムを作成するに当たって、最も深刻な問題の1つは、膨大な量のソースコードの作成・管理・保守を人間が行わなければならないことです。当たり前ですが、人間の理解力や記述能力は有限ですから、読み間違えたり、書き間違えたりミスをすることがまったくない、とは言い切れません。巨大なプログラムを作成するためには工夫が必要なのは明らかです。
例えば、数千行のプログラムであればまだ可能かも知れませんが、数万行を超えたプログラムのソースコードを想像してみてください。果たして読んだ人は理解できるでしょうか、殆どの読者は理解できなくはなくともそのために多大な努力が必要になることは容易に想像できますよね。
また、仮になんとか理解できたとして、本当にそのような膨大なソースコードが生み出すプログラムが正しく動作することを保証できますか、本当にソースコードで打ち間違えた、実装し間違えたところなどないといえますか。
これは非常に難しい問題です。この問題を解決するために今日までに様々な技法が生み出されました。
構造化プログラミング(Structured Programming)もそのうちの1つであり、もっとも基本となる技法・考え方(Paradigm)です。
この節では、構造化プログラミングとはどういうものか、触れていきます。
[4]: Million Lines of Code — Information is Beautiful (19/03/25 閲覧)
[5]: Windows - 2011年1月12日 - Thanks to everyone who participated in today's round of trivia ... (19/03/25 閲覧)
実験課題1
Exercise 1(課題1) See the section 3.1.1. "What is Unstructured Code". Show the source code converted from C language program of Figure 1 to Java program and its execution result as a screenshot. Follow the instructions below to write the souce code.
- create the Java application project named
chapter3kadai1. - create
mainmethod and modify its method to the program equal to the C language program. in the project class. - take the screenshot of the execution result.
(3.1.1.節をよく読み、chapter3kadai1プロジェクトを作成し、Cで書かれた図1のプログラムをJavaのプログラムとして作り直し、ソースコードを報告しなさい。また実行結果をスクリーンショットで示しなさい。)
構造化されていないということ
この節の要点
Goto文の様なジャンプ命令を極力、順接、選択、反復のプログラミング構造で置き換えることでプログラマが理解できるプログラムを作成する手法を構造化プログラミングと呼ぶ。- 構造化プログラミングを行うための方法として段階的作成法がある。
計算科学者であるエドガー・ダイクストラは、1960年代にGoto文がプログラムに与える悪影響を議論しました[6]。
当時のプログラミング言語、たとえばFortranやCOBOLで記述されたプログラムにはGoto文が多用されていました。
Goto文とは、ラベルを指定することで、指定したラベルが割り当てられているソースコード中の処理地点に移動する制御命令です。
Javaでは、Goto文が意図的に除外されており、現時点では利用することができません\(\dagger\)。
ですが、他の言語、例えば、CなどではGoto文が存在しており、図1で示すようなプログラムを作成することができます。
#include<stdio.h>

int main(void) {

	int n = 9, j = 0, i;
First:
	if (j < n) {

		i = 0;

	} else {

		return 0;
	}

Second:
	if (i <= j) {

		goto Third;
	} else {

		printf("\n");

		j = j + 1;
		goto First;
	}

Third:
	if (i > j/2) {

		printf("%d", j - i);
	} else {
		printf("%d" , i);
	}

	printf(" ");

	i = i + 1;

	goto Second;
}
0
0 0
0 1 0
0 1 1 0
0 1 2 1 0
0 1 2 2 1 0
0 1 2 3 2 1 0
0 1 2 3 3 2 1 0
0 1 2 3 4 3 2 1 0
ここで、図1のプログラムを読んで、図2の結果が予想できた人は優秀です。もちろん図1の様な極端な例は稀ですが、Goto文の濫用は、図1のプログラムのような状況をたびたび招いてしまいます。図3にフローチャートを示してみましょう。
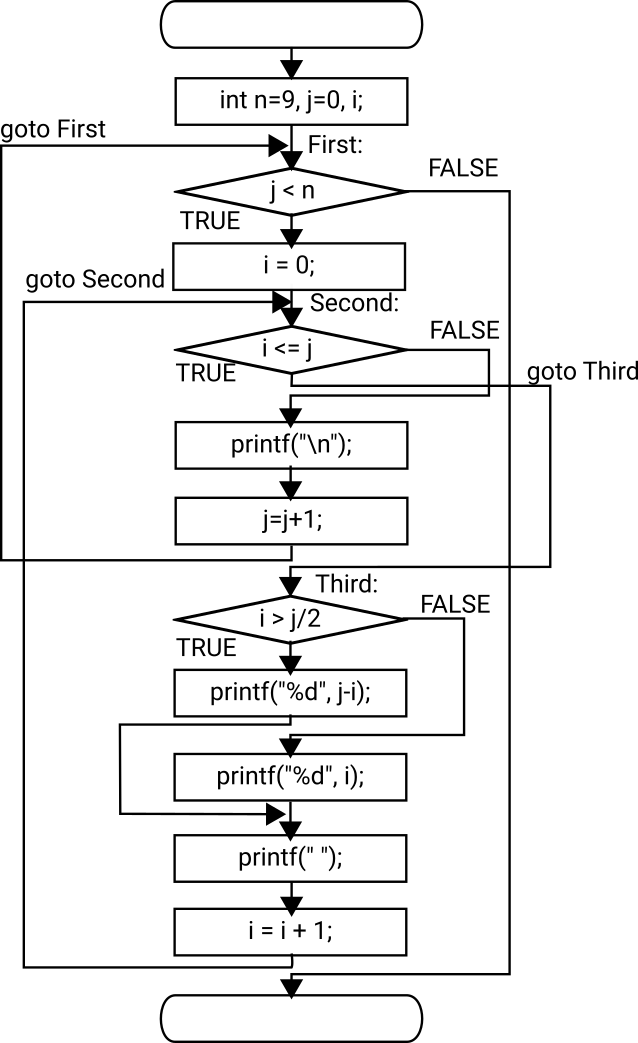
このダイクストラのGoto文に関する議論の中では、プログラムの動作を正しく理解するという観点から、ソースコード内で先頭から順に現れる命令の順序と、プログラムを実行した時に時系列順で実行される命令の順序がなるべく対応付けられているべきであるとの主張がなされました。図3を見る限り、命令の順序が時系列順で並んでいないことがわかると思います。
ここで、図3の実行順序を整理すると、図4のように変形することができます。
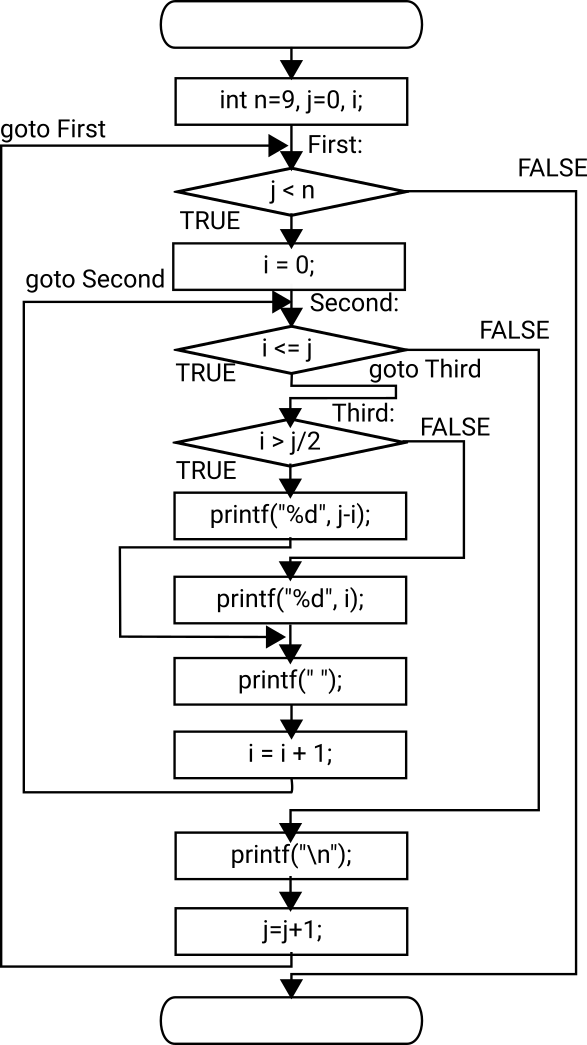
整理した図4を見る限り、命令の実行順序が直感的に分かるようになり明らかにソースコードの見通しが良くなったことがわかります。
この主張を発展させる形で、1972年に構造化プログラミング(Structured Programming)と題した小論文[7]を記したことに端を発する、 人間が理解できうる大きさでプログラムをうまく構造化する という効率的なプログラミングの形式手法は、今尚プログラマが知っておくべき重要な考え方です。
ダイクストラは、プログラムが計算を組織化したものとみなしました。本文中では、正しさを証明によって保証できる、数え上げ、数学的帰納法、そして抽象と呼ばれる3つの計算の構造を定義しました。そして、これらの中から対応付けることができる、 順接 、 選択 、そして 繰り返し と呼ばれるプログラムの構造(図5)を示しました。

また、これら構造によって形作られる構造化されたプログラムの 段階的作成法(step-wise program composition) を提案しました。数学的証明によって紐付けられた構造を組み合わせてプログラムを形作るこの作成手法は、全体を通して数学的に証明できており正しく動作するプログラムを作ることになる、というわけですね。
[6]: E.W. Dijkstra, ``Go-to statement considered harmful'', Communications of the ACM, Vol.11, pp.147--148 (1968)
[7]: E.W. Dijkstra, C.A.R. Hoare, and O.J. Dahl, ``構造化プログラミング'', サイエンス社 (1975)
\(\dagger\): ただし、ラベル付きcontinue文やラベル付きbreak文などを使うことで似たような制御をすることができます。
実験課題2
Exercise 2(課題2) See the section 3.2.1. "Stepwise Program Decomposition". Show the complete source code to calculate \(1000\) prime numbers as the program from Figure 6 to Figure 12 organized by step-wise program decomposition, and its execution result as a screenshot. Follow the instructions below to run program.
- create the Java application project named
chapter3kadai2. - create
mainmethod to run the program described from Figure 8 to Figure 14 in the project class. - take the screenshot of the execution result.
(3.2.1.節をよく読み、chapter3kadai2プロジェクトを作成し、図8、図10、図12~図14で示されたプログラムを、段階的作成法に基づいて、省略部分を追加して作成し、ソースコードを報告しなさい。また実行結果をスクリーンショットで示しなさい。)
段階的作成法
この節の要点
- 段階的作成法は、プログラムで実現したいことを初めに文章として書き下し、分割できそうな処理に分け、プログラムの命令としてすべての分割した処理が置き換えることができるまで繰り返し行うトップダウンな手法である。
- 段階的作成法を行うことで、階層的なプログラムを作成できる。
- 分割した処理を作用と呼び、メソッドや関数などのモジュールや、具体的な命令が対応する。
ダイクストラは、段階的作成法について、数段に分けてプログラムを作成することであり、各段階で決定することをできるだけ少なくする 、との方針を述べています。この構成方法においては、アルゴリズムを用意されている命令に対応する 作用(action) で構成することになります。 段階的作成法を、次のプログラムを例に試みてみましょう。
- 小さい順に\(1000\)個の素数を画面に表示する。
素数は、\(1\)とそれ自体でしか割り切ることができない自然数です。上記作用1. は、少なくとも、プログラミング言語に用意された1命令に対応付けることはできません。そこで、作用1. を分離させることを考えましょう。最初の案として、以下のように分離してみましょう。
-
小さい順に\(1000\)個の素数を画面に表示する。
1.1. 小さい順に\(1000\)個の素数を求める。
1.2. 求めた素数を画面に表示する。
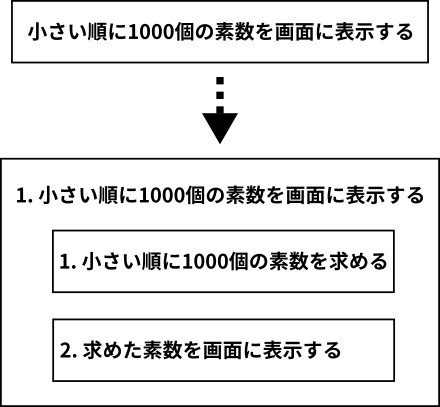
ここで注意すべきなのは、 分離させた作用同士は独立していなければならない 、ということです。少なくとも上記1.1. と1.2. の作用においては、素数の概念を変更することにはなりませんし、また、素数の内容によって、表示が別の操作に変わるというわけでもないから、独立していると言えます。
また、作用の分離にあたって、分離された作用は同じ状態空間を共有することになるので、どのように状態空間を利用するかを考えなければなりません。ここで状態空間とは、作用によってもたらされた結果を維持し、共有するための領域・構造などを指しています。例えば、1.1. と1.2. の作用において共有すべき情報は求めた素数です。つまり、作用の分離と共に、 共有すべき情報をどの範囲でどのようなデータ構造で受け渡すかを考えなければなりません 。
以上のことから、作用の分離に際して何らかの共有すべきデータ構造を定義しなければなりませんが、このデータ構造の決定を プログラムを作成する過程においていつすべきでしょうか 。これについては、少なくとも次の2案を考えることができます。
案1. 作用の詳細をなるべく決めてから、それに合ったデータ構造を決める。
案2. 作用の詳細を決める前に、思い切ってデータ構造を決める。
基本的に、上記の2案はどちらも表裏一体です。 案1. は分解する作用の詳細に依存していますし、これら作用を正しく見極められなかった場合、複雑なデータ構造になってしまいます。また 案2. は、決めたデータ構造に各作用が依存する形になるため、うまく決めることができなかった場合、プログラム自体が複雑になってしまいます。基本的に、作用(あるいはプログラム)とデータ構造、お互いを繰り返し修正する試行錯誤はなるべく少なく楽にすべきです。 ダイクストラは、思い切ってデータ構造から決めることを提案しています 。ここではその提案に則って、 案2. を採用しましょう。
1.1. と1.2. の間で受け渡す素数の集まりは、\(1000\)個で固定されています。だとすれば、ひとまずこの個数を拡張することを考えずに、長さ\(1000\)の配列構造を用意しておけば、受け渡すことができるはずです\(\dagger\)。また、それぞれの要素の型は、整数論の結果より\(1000\)個目の素数が符号付き32bit整数型の上限(2,147,483,647)に収まる事実から、長さ\(1000\)の整数型の配列を、作用1. の状態空間に予め用意しておけばひとまずよさそうです\(\ddagger\)。よって、上記作用 1.1. ~1.2. に対して、作用1.1. より前に新たに作用を追加することで、以下の 1.1'. ~1.3'. に変更できます(図7)。
-
小さい順に\(1000\)の素数を画面に表示する。
1.1'. 長さ\(1000\)の整数型の配列\(p\)を用意する。
1.2'. 小さい順に\(1000\)個の素数を配列\(p\)に順に格納する。
1.3'. 長さ\(1000\)の整数型の配列\(p\)を画面に表示する。
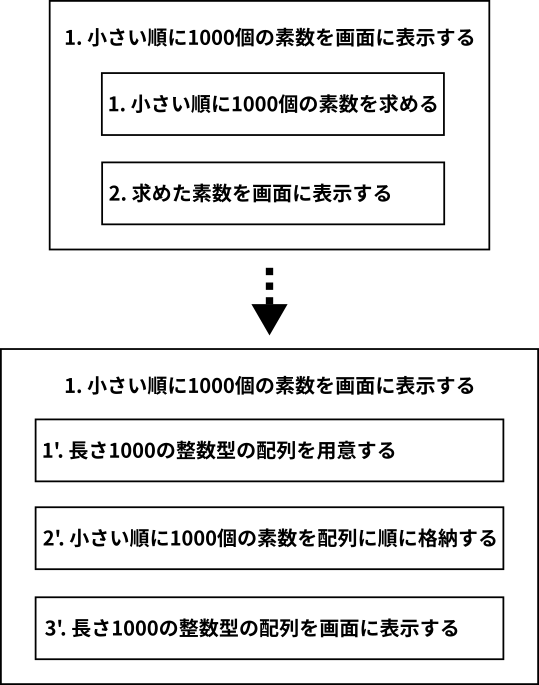
さて、ここで1.1'. には対応付けられる命令が存在します。それは、次の様に記述できます。
1.1'. 長さ\(1000\)の整数型の配列\(p\)を用意する(図8)。
int[] p = new int[1000];
また、1.3'. は配列\(p\)の中身を\(0\)から順に\(1000\)まで順に表示すれば良さそうです。これは素直に書き下すと図9の様に記述できます。
System.out.print(p[0] + " ");
System.out.print(p[1] + " ");
:
System.out.print(p[999] + " ");
図7をよく観察すると、大半の処理が共通しており、唯一、配列インデックスをずらしているところだけが違いです。基本的に、同じ処理がインデックスをずらして連続して行われる場合は、繰り返し構造を使って、洗練させることができます。
ここで、作用1. をプログラムとして記述する上で、プログラマは配列の長さが\(1000\)であることを知っているため、長さを改めて知る必要がないことに注意してください。 改めて、1.3'. は次のように記述できるはずです。
1.3'. 長さ\(1000\)の整数型の配列を画面に表示する(図10)。
for(int i = 0; i < 1000; i++) {

	System.out.print(p[i] + " ");
}
ここで、作用1. の処理において、作用1.2'. が最も核となることは容易に分かるはずです。ここからは、作用1.2'. を掘り下げていきます。
作用1.2'. を分離するにあたって、まず外形から考えていきましょう。先に述べたように、素数は\(1\)とそれ自身でしか割り切ることができない自然数です。素数を単に配列に保存するだけであれば、自明な案は作用1.2'. を次のように書くことです。
1.2'. 小さい順に\(1000\)個の素数を配列\(p\)に順に格納する(図11)。
p[0] = 2;
p[1] = 3;
:
p[999] = 7919;
しかし、この作用1.2'. では\(1000\)個の素数表を知っておく必要がありますし、なによりもプログラムを必要としないことを意味しています。このあまり現実的ではない処理を観察すると、我々は少なくとも小さい順に素数を知っていることが分かりますから、配列\(p\)を埋めるためには、インデックスを昇順に増やして埋めていけば良さそうです。
この処理をまとめると、作用1.2b.を改良した次の作用1.2'. を容易に思い浮かべることができるはずです。
1.2'. 小さい順に\(1000\)個の素数を配列\(p\)に順に格納する(図12)。
int x = 1, pcnt = 0;

while(pcnt < 1000) {

	x = xの次の素数を計算する;
	p[pcnt] = x;
	pcnt = pcnt + 1;
}
もちろん、このwhile文で記述された作用1.2'. は、for文でより洗練させることができることはすぐ分かりますね?
さて、ここで「\(x\)の次の素数を計算する」演算が存在するならばこのプログラムは完成ですが、ここでは無いと仮定します(一般的なプログラミング言語では無いでしょう)。すると、次の洗練段階で、\(x\)がどのように増やされるか表現しなければなりません。
ダイクストラは、手続き (本来は返り値のないメソッドの意味であるが、文脈的には返り値のあるメソッドでも良い)を駆使することで、全ての変数が全ての処理中に存在できる状態よりも、変数が存在できる範囲、すなわちスコープ を定義して適切に変数の存在範囲を制限することの方が、非常に有意義であると述べています。これは、 ある処理を実行するに当たって内部処理を理解せずとも利用できること( 抽象 (化))につながるため です。 つまり、 適宜作用ごとにメソッド化すべきである ことが理解できますね。したがって、「\(x\)の次の素数を計算する」作用をメソッド化しましょう。
作用1.2'.x. として次の様に書きます。
1.2'.x. \(x\)の次の素数を計算する(図13)。
static int nextPrime(int x) {

	int k = x + 1;

	while(! kが素数である) {

		k = k + 1;
	}
	return k;
}
引数\(x\)として与えられた値を素数となるまで増加させれば良いわけですから、繰り返し文を使えば良いはずですね。
次に、図11中の「\(k\)が素数である」作用を、次の作用1.2'.x.x. として再び洗練させましょう。
1.2'.x.x. \(k\)が素数である(図14)。
static boolean isPrime(int k) {

	/* 省略 */
}
この作用1.2'.x.x. を記述するためには既存の命令を組み合わせるだけで実現できるため、全ての作用をプログラムの命令と対応付けできたことによりプログラムは完成しました。
本来は、手続きの洗練をさらに繰り返し行うため、もう少し手順が増えますが、基本的な考え方はここまでで示した通りです。
なお、段階的に設計していくのは、手続きだけでなく、データ構造も段階的に洗練させていきます。従って、作用を分離していく各段階で、手続きまたはデータ構造のいずれか1つを洗練させていくことが段階的作成法の要点です。
ダイクストラは、手続き(メソッド)の呼び出しが入れ子となることを、手続きの呼び出し階層と手続き内部の階層と言った具合に、層状にプログラムを構成することにたとえました。こうした層状のプログラム構成は、上記の段階的作成法を用いることで、作ることができます。この層状のプログラム構成は、以下の利点などが挙げられるため、プログラム作成においては魅力的なやり方であるとダイクストラは述べています。
- 各層が分離(独立)しており、ある層に対する修整が他の層に影響を与えない
- 層を重ね合わせて目的のプログラムを作ることで同じ処理の共通化が進む(再利用性が上がる)
- よく分離された層に注目することでデバッグがしやすくなる
ここで、機能(作用)を分割していく設計方法(図15)を、プログラム設計におけるトップダウン方式 と呼びます[8]。一般的なトップダウン方式のメリットを以下に示します。

- 人は大きなものを小さく分解することは得意であるから、反復的に機能を分解していく方法は容易に行うことができる
同時にトップダウン方式のデメリットを次に示します[8][9]。
- 機能を分割していく関係上、分割された機能の呼び出し関係は木構造になり、再利用性が低下する
- 機能を分割してくことに注視しているため、データ構造が無視されがちであり、プログラムの機能追加など修正にともなう複雑さが増える
一見すると、段階的作成法はトップダウン方式であり、メリット・デメリットが重複しており矛盾していると感じるかも知れません。 ですが、ダイクストラが提案した段階的作成法は、厳密にはトップダウン方式ではありません。 なぜならば、同じ処理を共通化して利用することを推奨しており、機能の呼び出し関係が木構造になりません。 また、機能(作用)の分割のみならず、データ構造の分割についても、機能分割と並行してなされています。 さらに、段階ごとに決定することをなるべく少なくすることと手続きによって抽象化した機能を層状に組み立てていく設計方針は、 理想的には 、変更に強いプログラムを作成できます。
まとめると、プログラムを構造化すること、手続き(メソッド)を定義して抽象化しプログラムを組み立てていくことが、プログラムの理解しやすさひいては書きやすさに繋がるということ、そして、要件を正確に満たしたプログラムを作ることになるわけです。
[an error occurred while processing the directive][8]: M. Steve, ``CODE COMPLETE 上 完全なプログラミングを目指して'', 第二版, 日経BP社 (2005)
[9]: B. Meyer, ``オブジェクト指向入門'', アスキー出版局 (1990)
\(\dagger\): もちろん動的配列やリスト構造を利用した動的な構造を利用することも考えられます。しかし、ここでは議論が複雑になりすぎるので全て静的な構造で定義します。
\(\ddagger\): その他にも、配列インデックスに対応する数値が素数か否かをboolean値で持つ配列構造なども考えることができますが、ここではこれ以上の議論はしません。
実験課題3
Exercise 3(課題3) See the section 3.2.1. "Stepwise program decomposition". Show the source code to display Pascal's triangle with the height given \(h\) as the following figures and its execution result as a screenshot. Pascal's triangle is a numbers array arranged in triangle. This arrangement manner is that its top line is only 1, and each number after top line is plus left above number and right above number (if left or right above number is not in, then it number is 0). Follow the instructions below to run program.
- create the Java application project named
chapter3kadai3. - create
mainmethod to run the program in the project class. - create the program to display Pascal's triangle such by using double for loop such as below figure in
mainmethod. - take the screenshot of the execution result.
1
1 1
1 2 1
1 3 3 1
1 4 6 4 1
1 5 10 10 5 1
1 6 15 20 15 6 1
The simplest way to implement the calculation of Pascal's triangle is to fill 2d array object as follows:
int[][] triangle = new int[h][h];  // 二次元配列オブジェクトをtriangleに作成。ここでhはScannerで読み取った数。

// for文を使って最上段から順に埋めていく。
for (int j = 0; j < h; j++) {
	for(int i = 0; i <= j; i++) {
/* 以下略 */
(3.2.1.節をよく読み、chapter3kadai3プロジェクトを作成し、段階的作成法を用いて、与えられたhの高さのパスカルの三角形を表示するプログラムを作成しなさい。このとき作用はメソッドとして分割すること。それに伴い、作用をどのように分解したかもまとめなさい。そして、プログラムのソースコード、および実行結果のスクリーンショットを報告しなさい。パスカルの三角形とは、最上段が1で、それより下の段はその位置の右上の数と左上の数(存在しなければ0)の和を配置することで作られる三角形状である。)
構造化における保守性の高め方
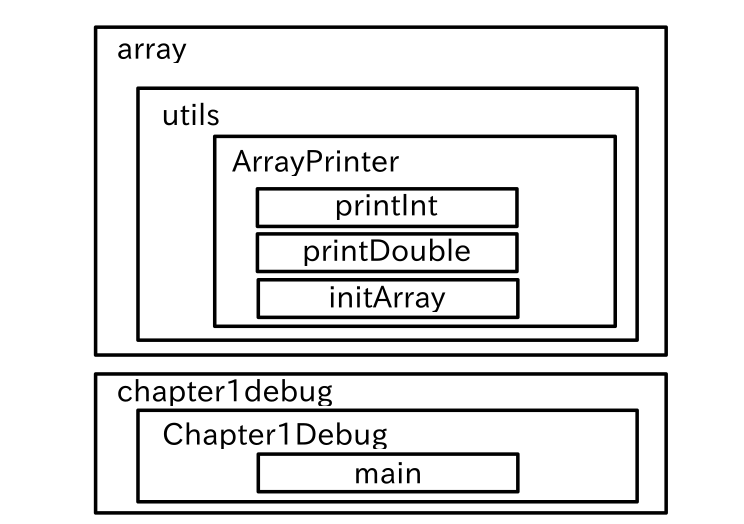
モジュール(module) とは、様々な種類のサブルーチンつまり 何らかの処理がまとめられた返り値のない手続き(の複数がまとまったもの)や、返り値のある関数(の複数がまとまったもの)、またはクラスなどがあつまったまとまりのこと です(図16)。先に述べたように、人間の能力は有限ですから、 途方もないわかりづらいソースコードの山を作り上げる前に、プログラマのミスをカバーできるようにプログラムは作っていくべき です。前節で、プログラムを正しいモジュールの組み合わせとして作っていく、段階的作成法の大まかな流れと利点を説明しました。この 段階的作成法においては、プログラムの正確性を主眼に置いていました 。ですが、それ以外にもプログラムに関する指標は数多く存在します。その中でも特に有名なものとして、バグの発見しやすさ修正しやすさである保守性 に則ったモジュールを作成するための構造化設計の指標である、結合度 と凝集度 があります。
ここで保守性とは、修正のしやすさに関するソフトウェア製品の能力\(\dagger\)を意味します。
先に述べた途方もないわかりづらいソースコードをなんとか組み上げ、(一応)要件を満たした上でプログラムを動作させることができたとしても、プログラマの役割はそれで終わりではありません。一般的には、新たな機能追加やバグ修正など、積み上げられたソースコードの山の改修が待ち受けているのです。しかし、そのようなソースコードの山を修正することは、うずたかい粗雑に組み上げられた積み木を崩さずに、不要なパーツを抜き取り、あるいは差し込むことで再構築するようなもので、プログラマに時間的にも労力的にも多大な負担をかけることは容易に想像できるはずです。こうした状況を未然に防ぐためには、プログラム作成時に、ソースコードを保守性の高い書き方で記述することが重要になります。
結合度と凝集度に注目してモジュールを作成していくことで保守性の高い構造化を行うことができます。次節から、これら指標がどのようなものか説明してきます。
\(\dagger\): JIS X 0129-1 ソフトウェア製品の品質 第1部:品質モデル
実験課題4
Exercise 4(課題4) See the section 3.5.1. "Coupling". Improve isJidou and calculateBMIorRohrer methods that have a common coupling in below figures. calculateBMIorRohrer method calculates Body Mass Index or Corpulence(Rohrer's) Index. Follow the instructions below to explain. Hint. the variable with a prefix public static is a kind of global variable.
- create the Java application project named
chapter3kadai4. - create
mainmethod to run the program described as below figures in the project class. - modify the program to decrease the coupling.
public static boolean isBmi = false;

public static boolean isJidou(int age) {

	int chugaku_age = 16;
	if (age <= chugaku_age) {

		isBmi = false;
		return true;
	} else {

		isBmi = true;
		return false;
	}
}

public static double calculateBMIorRohrerIndex(double weight, double height) {

	if (isBmi) {
		return weight/(height*height);
	} else {
		return 10.0*weight/(height*height*height);
	}
}
(3.5.1.節をよく読み、プロジェクトchapter3kadai4を作成し、共有結合となっている下図のソースコード中の2つのメソッドisJidouとcalculateBMIorRohrerを改善しなさい。なおcalculateBMIorRohrerIndexメソッドはボディマス指数またはローレル指数を計算する。)
結合度とは
この節の要点
- 結合度とは複数の関数・メソッド・クラスなどのモジュールがどの程度関係しているかを表す尺度である。
モジュールの結合度(coupling) とは、 あるモジュールがどれだけ他のモジュールと結びついているかを表します 。この考え方は1974年にラリー・コンスタンティンを中心として、凝集度と対になる形で合わせて考えられました[10][8]。
どのようなモジュールの結合度ならばよいソースコードといえるのか、その基準として、良いモジュール間結合 とは、あるモジュールが他のモジュールから複雑な前処理がなく簡単に使用できるぐらい繋がりが薄い(疎結合である)こと とされています。
例えば、java.lang.Mathパッケージに含まれるdouble sin(double a)といったラジアン値に対する正弦関数の値を返すメソッドは、別のモジュールから呼び出されるに当たって、ラジアン値が1つ渡されることだけ知っておけば良いので、疎結合であると言えます。
しかし例えば次の、void initVariables(double a, double b, ..., double x)といった、何らかの初期化を行う関数があったとすれば、これは前述したsinメソッドよりかは、密結合だといえます。なぜならば、別のモジュールからinitVariablesメソッドを呼び出す際に、そのモジュールは、渡さなければならない全ての引数から、その関数の中で何が起きるかを実質的に知っていることと同じだからです。
以下に、モジュールに対する結合度の度合いとその分類を段階別で示します[10]。ここで、結合度は高(強)ければ悪く、低(弱)ければ良いとされます。
- 内容結合(最も密、最も悪い) (Content coupling)
- あるモジュール内部のコードを別のモジュールで利用している場合(図17)
goto文などのジャンプ命令によって処理を共有するなど、一部のプログラミング言語でしか実現できない結合度
- あるモジュール内部のコードを別のモジュールで利用している場合(図17)
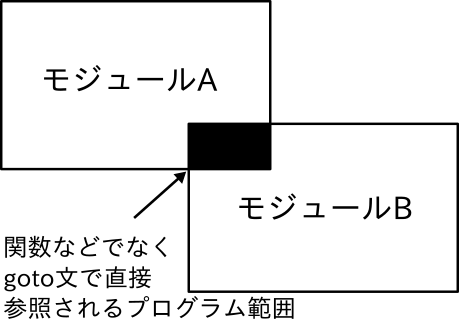
- 共有結合 (Common coupling)
- 複数のモジュールが共通のグローバルデータ(プログラムのどこからでもアクセスできるデータ)にアクセスしている場合(図18)
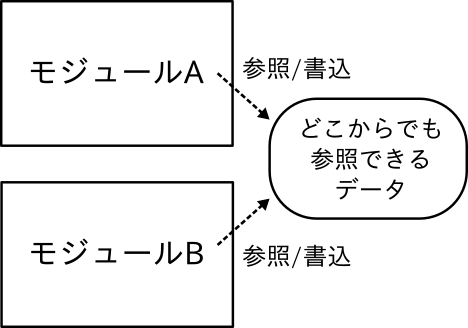
- 外部結合 (External coupling)
- 複数のモジュールが外部ソフトウェアで用意されているデータフォーマットやプロトコル、やデバイスなどの役割を共有している場合(図19)
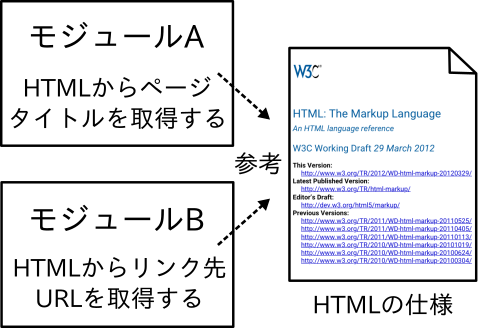
- 制御結合 (Control coupling)
- 1つのモジュールが別のモジュールの処理の内容を制御している場合(図20)。例えば、なんらかのフラグをモジュール間で渡している、など
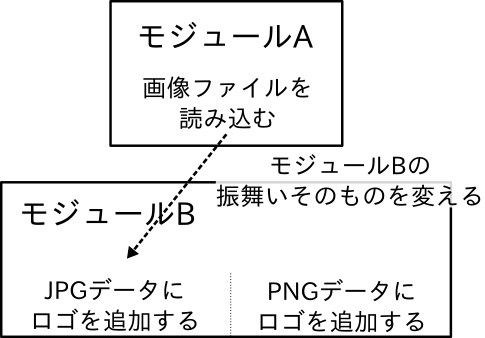
- スタンプ結合 (Stamp coupling)
- 複数モジュールがデータを共有し、そのデータのうち一部だけ利用し、かつおのおのしか使われていないような場合(図21)
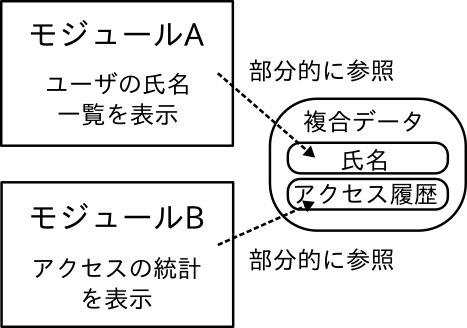
- データ結合(最も疎、最も良い) (Data coupling)
- 複数モジュールがデータを共有し、各モジュールがそのデータのうち全体を利用している場合(図22)
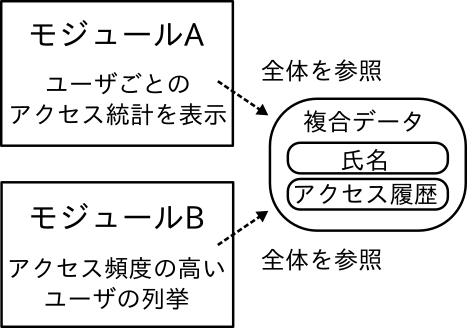
基本的に、我々が作ることになる大体のモジュールは、データ結合(疎結合)になるように心がけるべきです。ただ、すべてのモジュールを疎結合にすることは困難です、注意してください。保守性を特に高めたい箇所は選ばなければなりません。 各モジュールが疎結合となることで、おのおののモジュールが容易に切り離すこと(モジュールの削除や内容の変更など)ができることを意味し、また新たなモジュールに容易に組み合わせること(新たなモジュールの追加)ができることに相当します。これは保守性やモジュールの再利用性に関係していて、重要な特性です 。 こうした、データ結合になるようなモジュールの設計方針として以下の3つが挙げられます。
- 結合箇所の多さをなるべく少なくする。
- なるべく関数の引数の数を少なくする。
- あまり多くの関数を公開しすぎない(アクセス修飾子による)。
- 結合箇所をなるべく明らかにする。
- モジュール内部であるデータを利用する際、モジュール内部で暗黙的にデータを参照するよりかは、モジュールの引数などで明示的にデータを渡して参照する。
- グローバル変数は使わない(Javaだと特に
static変数)。
- グローバル変数は使わない(Javaだと特に
- モジュール内部であるデータを利用する際、モジュール内部で暗黙的にデータを参照するよりかは、モジュールの引数などで明示的にデータを渡して参照する。
- 結合箇所はなるべく単純にする。
- 複雑なデータ構造を引数としてモジュールに渡すのではなく、もし単純に済むのであれば単純な引数にする。
[8]: M. Steve, ``CODE COMPLETE 上 完全なプログラミングを目指して'', 第二版, 日経BP社 (2005)
[10]: W.P. Stevens, G.J. Myers, and L.L. Constantine, ``Structured Design'', IBM Systems Journal, Vol.13, pp.115-139 (1974)
実験課題5
Exercise 5(課題5) See the section 3.5.1. "Coupling". Show the source code to display intersection between given two arrays by modifying intersectAndPrint method in following figure and its execution result as a screenshot. Follow the instructions below to show the result.
- create the Java application project named
chapter3kadai5. - create
mainmethod to run the program inlucdingintersectAndPrintas below Figures in the project class. - take the screenshot of the execution result.
public static void intersectAndPrint(int[] a, int[] b) {

	int[] dup = new int[a.length]; // 共通集合を表すリスト

	int dupCnt = 0; // 共通集合の要素数

	// 共通集合の導出処理
	for (int j = 0; j < a.length; j = j + 1) {

		for (int i = 0; i < b.length; i = i + 1) {
			// 略
		}
	}

	// 共通集合の表示処理
	for (int i = 0; i < dupCnt; i = i + 1) {
		// 略
	}
}

public static void main(String[] args) {

	int[] a1 = new int[]{1,2,3,4,5};
	int[] a2 = new int[]{3,1,5,10,11};

	intersectAndPrint(a1, a2);
}
1,3,5
(3.5.1.節をよく読み、プロジェクトchapter3kadai5を作成し、二つの配列の共通集合を表示するintersectAndPrintメソッドを下図のソースコードとの実行結果を元に作成し、ソースコードを示しなさい。ここで二つの配列の共通集合とは、二つの配列に共通して存在する要素からなる配列を意味する。例えば、配列a1が1,2,3,4,5でa2が3,1,5,10,11からなるとき、二つの配列の共通集合は1,3,5からなる配列である。)
実験課題6
Exercise 6(課題6) See the section 3.7.1. "Cohesion". Show the modified source code to increase the cohesion of intersectAndPrint method in exercise 5 by separating intersect method and print method and its execution result as a screenshot.
1,3,5,0,0
(3.7.1.節をよく読み、課題5で作成したintersectAndPrintメソッドを機能的凝集度に照らし合わせて凝集度を高めなさい。intersectメソッドとprintメソッドに分割して実行するプログラムを新たに作成し、ソースコードを示しなさい。また実行結果をスクリーンショットで示しなさい。)
凝集度とは
この節の要点
- 凝集度とはある関数・メソッド・クラスなどのモジュールの処理目的が主だった目的と一致しているか(凝集しているか)を表す尺度である。
結合度と対をなす指標として、凝集度(cohesion) があります。
モジュールの凝集度とは、 モジュールの主目的に対して、どれだけ厳密にサポートしているか、つまりどれだけ処理内容の焦点が主目的に凝集しているかを表します [8][10]。
例えば、java.lang.Mathパッケージに含まれるdouble cos(double a)といったラジアン値に対する余弦関数の値を返すメソッドは、メソッドの処理が1つの機能を実行することに徹しているので、凝集度は高いと言えます。しかし例えば次のようなdouble cosAndTan(double a, boolean flag)といった第二引数の値によって、余弦かあるいは正接関数の値を切り替えて返却するメソッドがあったとすれば、これは先のメソッドと比較しても凝集度は低いと言えます。
以下に、モジュールに対する凝集度の度合いとその分類を段階別に示します[8][11]。ここで、凝集度は高(強)ければ良く、低(弱)ければ悪いとされます。
- 暗号的凝集度(最も低い、最も悪い) (Coincidental cohesion)
- モジュール内の処理同士にそれとわかるような関係性が無い場合
- 論理的凝集度 (Logical cohesion)
- モジュール内の処理同士が1つの目的に関係している場合
- 例えば、入力処理をまとめたパッケージ
inputが、キーボードからの入力処理、スキャナからの入力処理、データベースからの入力処理からなる場合、inputは論理的凝集度を持つ - 例えば、データ入力メソッド
inputAllを仮定する。inputAllはキーボードからの入力、スキャナからの入力、データベースからの入力などすべてから得たデータを文字列出力するメソッドである。このようなinputAllメソッドは論理的凝集度を持つ
- 手続的凝集度 (Procedural cohesion)
- モジュール内の処理が特定の手続き的にあるいはアルゴリズム的な関係性のある処理、すなわちある特定の処理に関係する順接、分岐そして繰り返しのいずれかの処理からなる場合
- 例えば、読み込んだデータへの消費税処理をまとめたパッケージ
taxが、データを読み込む処理、消費税の計算処理、取り出したデータに対して1件づつ消費税の計算処理を適用する処理からなる場合、taxは手続的凝集度を持つ - 例えば、読み込んだデータの消費税処理をおこなう
calculateTaxメソッドが、データを読み込み、消費税の計算し、取り出したデータに対して消費税の計算をする処理の場合
- 時間的凝集度 (Temporal cohesion)
- モジュール内の処理がプログラム中の特定のタイミング中で順序が関係なく実行される関係性でまとまっている場合
- 例えば、ファイル読み込みの初期化処理をまとめたパッケージ
readinitが、カウンタ変数を初期化する処理、読み込む配列を初期化する処理、ファイルポインタを開く処理からなる場合、readinitは時間的凝集度を持つ - 例えば、ファイル読み込みの初期化処理をまとめた
readInitメソッドを仮定する。このようなreadInitメソッドは時間的凝集度を持つ
- 連絡的凝集度 (Communicational cohesion)
- モジュール内の処理が同じデータを使用するが、データの共有を除いて処理の関連が無い場合
- 例えば、入力された成績情報に関する処理をまとめたパッケージ
score.frominputが、成績表の作成処理、成績データの補正処理、氏名の補正処理からなる場合、score.frominputは(同一の成績情報を利用する点において)連絡的凝集度を持つ - あるいは、成績データを作成する処理をまとめたパッケージ
score.tooutputが、入力された文字列から成績データを作成する処理、今回の成績と前回の成績から成績データを作成する処理、特定の成績を除外した新しい成績データを作成する処理からなる場合、score.tooutputは(同一種類の出力データである成績データを出力する点において)連絡的凝集度を持つ
- 逐次的凝集度 (Sequential cohesion)
- モジュール内の処理が、受け渡されたデータを加工を施し結果を返却する処理であり、かつ順番に連鎖できる関係性でまとまっている場合。
- 例えば、成績を表示する処理をまとめたパッケージ
scoreutilsが、ファイルを読み込み成績データを作成する処理、成績データから補正した成績データを作成する処理、成績データから画面出力を行う処理からなる場合、scoreutilsは逐次的凝集度を持つ
- 機能的凝集度(最も高い、最も良い) (Functional cohesion)
- モジュールがある処理を1つだけ実行する場合
基本的に、我々が作ることになる大体のモジュールは、機能的凝集度となるように心がけるべきです。もちろん、すべてのモジュールを機能的凝集度にすることは困難であることには注意してください。保守性を特に高めたい箇所は選ばなければなりません。このように凝集度を高くするように心がけることで、モジュールが行う処理が明確化されるため、デバッグのしやすさにつながり、保守性が向上します。
例えば、先に述べたcosメソッドやsinメソッドのように、1つのモジュールには 1つの明確な役割 (つまり処理内容、cosメソッドならばラジアン値に対する余弦関数の値を返す、それ以外の処理内容は持たせない)だけを与えるように設計したほうが良いです。
なお、 機能的凝集度を目指すモジュールには当然ながら、良いモジュール名が命名されていなければなりません 。それは、 先に述べた1つの明確な役割は、モジュール名によって(まず初めに )識別されるから です。例えば、void do()関数を見てあなたは何を考えますか。メソッドdoとは一体何をするのだ、大概の人は思うはずですよね。このようなモジュール内の処理が何をするのか全く表現できていない命名は避けましょう。もちろん長すぎても駄目ですし、冗長すぎても駄目です。これはプログラマにとっての悩みの種の1つです。一説には、変数名の最適な長さが9~15文字である[8]から、少なくとも変数名より複雑になりそうにないモジュール名はこれより短くするよう務めましょう。例えば文章を印刷するモジュールなのであれば、printDocumentだし、注文情報が正確か確かめるモジュールであれば、checkOrderInfoでも良いと思います(もちろんこれが最適とは限りません、場合によっては冗長であったり、悪くなる可能性もあります)。
そうはいっても、モジュールの命名は適切に行うこともプログラマにおける重要な関心事であることを覚えておいてください。
[8]: M. Steve, ``CODE COMPLETE 上 完全なプログラミングを目指して'', 第二版, 日経BP社 (2005)
[10]: W.P. Stevens, G.J. Myers, and L.L. Constantine, ``Structured Design'', IBM Systems Journal, Vol.13, pp.115-139 (1974)
[11]: E. Yourdon, L.L. Constantine, ``Structured Design: Fundamentals of a Discipline of Computer Program and Systems Design'', Prentice Hall Inc. (1979)
レポート課題
Homework 1(調査課題1) Explain what kind of the cohesion the main methods in exercise 3 is.
(課題3でmainメソッドの凝集度を段階別に示すと何凝集度になるか。説明しなさい。)
Homework 2(調査課題2) Explain each reason that following each example of the function name are bad.
take,checkmethodA,methodB,methodCcalculatePT,getUS
(次の関数名が望ましくない理由をそれぞれ述べなさい。)
クラスと継承
構造化プログラミングは、段階的作成法に基づいて、階層的な抽象化を関数や手続きにて行って、順接・分岐・繰り返しの3つの構造を組み合わせて推し進めるプログラム作成技法でした。
しかし、この技法を用いて作成したとしても、プログラム作成後の仕様変更には多くの労力が必要になります1。例えば、既に完成したプログラムで、ある関数の引数の数を変更しなければならないときを考えてみてください。
明らかに変更する関数は別の関数で利用されているはずです。とすると、変更した関数が関係する全ての呼び出し元関数にも変更を加えなければならず、つまりプログラムにおいて1つの変更は大なり小なり他の関数(モジュール)に波及してしまいます(図1)。

そしてこうした変更は往々にして、プログラム開発の最中に多発します!
プログラマの労力を減らすために、できるだけ、このような変更の波及は抑えられるべきですよね。
1967年にオーレ・ヨハン・ダールとクレステン・ニゴールはプログラミング言語Simula 67を開発しました。
Simula 67では、こうした変更の連鎖を避けるために、システムの構成要素おのおのが独立したプログラムとして作成でき、なおかつシステムの他の部分とはまったく、あるいはほとんど関わり合わずに修正できる構造として、クラスと呼ばれるプログラム構造を初めて導入しました[7][9]2。 Simula 67のプログラムは、時々刻々と変化する動的なシステムとして、より高度な概念、すなわち何らかの意味を持つ概念と対応付けられたプログラムの構造(図2)、を階層的に組み合わせることで構成します。

この概念と対応付けられたプログラムの構造をクラスと呼んだわけです。
そして、このクラス構造を階層付ける方法が、継承(inheritance)と呼ばれる方法です。
この節では、オブジェクト指向プログラミングを構成する要素である、クラスと継承について触れていきます。
もちろん、プログラムの構造化手法を提唱したダイクストラは構造化をする上で、修正(修整)の影響を受ける箇所は既によく分離されているべきであると述べているし、段階的手法を使って、関数や手続きなどで層状に形作られた構造は分割統治的であるから[7]、ある程度は構造化手法でも解決可能な問題ではあります。しかし、構造化手法においては、ダイクストラの言う関数や手続きをつなぐインタフェース(データの表現)の有効範囲が存在し[7]、この有効範囲を超えた場合はこの限りではありません。
Simula 67で導入された時点では、``オブジェクト指向''と呼ばれる単語はありませんでした。同年に、1970年代にSmalltalkと呼ばれるオブジェクト指向プログラミング言語を開発したアラン・ケイが初めて使ったとされています [11]。
[7]: E.W. Dijkstra, C.A.R. Hoare, and O.J. Dahl, ``構造化プログラミング'', サイエンス社 (1975)
[9]: B. Meyer, ``オブジェクト指向入門'', アスキー出版局 (1990)
[11]: Dr. Alan Kay on the Meaning of "Object-Oriented Programming" | Userpage Freien Universität Berlin (20/07/02 閲覧)
実験課題1
Exercise 1(課題1) See the section 4.1.1. "About Class". Show the complete source code of Figure 3 and Figure 4, and its execution result as a screenshot. Follow the instruction below to show the result.
- create the Java application project named
chapter4kadai1. - select the project that you want to add new class and right-click it in the project pane of NetBeans.
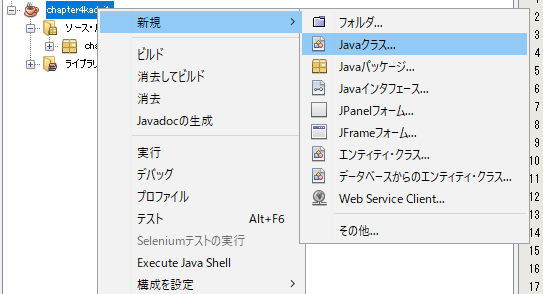
Figure:Right click on current project in the project pane - select
New > Java Class...from the rigth-click menu items - input
Useras Class Name andchapter4kadai1.recordsas Package Name inNew Java Classdialog, and selectFinishbutton.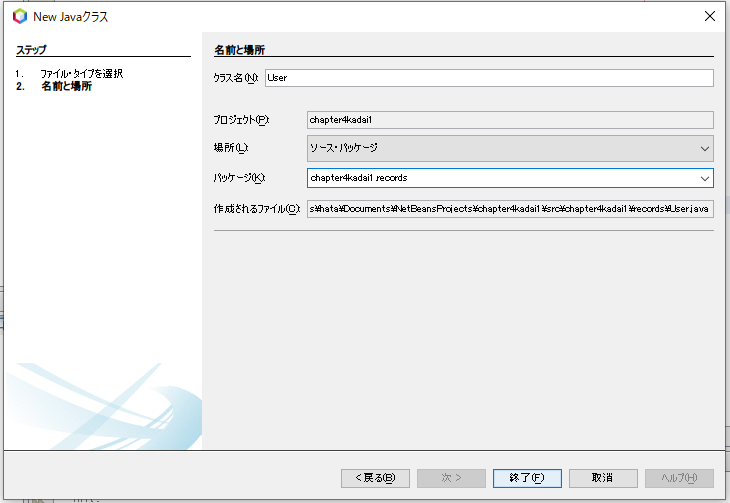
Figure:Add a class by using `New Java class` dialog - open
User.javainchapter4kadai1.recordsof source package, and modify the program of Figure 3 with proper step in the editor pane of NetBeans.
(4.1.1.節をよく読み、chapter4kadai1プロジェクトを作成し、図3と図4のプログラムを作成し、ソースコードと実行結果を示しなさい。なお、図3のプログラムの追加方法は上記の手順に則ること。)
クラスとは
この節の要点
- クラスとは関係する変数(フィールド)と手続きと操作(メソッド)からなるプログラム構造のことである。
- クラスそのものは、あくまでどんなフィールドを持ちどんなメソッドを持つかをソースコード上に定義したいわば設計図である。したがって、実際にプログラムで使う際は、その設計内容をメモリ上に形にしたものをプログラムが扱う。クラスを元に作成したメモリ上のプログラム構造をインスタンスあるいはオブジェクトと呼ぶ。
- クラスからオブジェクトを作成する際は**
new**キーワードを使う。- クラスを設計する際は、現実世界の概念と対応付けて設計させることが多く、その際はクラスが概念に、インスタンスやオブジェクトがその概念の実例に対応する。
static修飾子が付いていないメソッドをインスタンスメソッドと呼ぶ。インスタンスメソッドはオブジェクトを介して呼び出すメソッドである。- クラス内に定義されたフィールドやメソッドの定義時に前置された
publicをアクセス修飾子と呼ぶ。
\({\Huge``}\) Any useful concept has some degree of generality, i.e. it is a \({\it class}\) of specialised instances. In other words one tries to group phenomena occurring in a dynamic system into \({\it classes}\) of phenomena and to describe each class by a single piece of program. \({\Huge,\hspace{-0.4em},}\)
------ Ole-Johan Dahl, C. A. R. Hoare, III Hierachical Program Structures, p.177[7]
\({\Huge``}\) 有用な概念はどれも、ある程度の一般性をもつものである。すなわち、それは特殊な実例(instance)が集まったクラス(class)なのである。いい換えると、動的システムに現れる現象を、現象のクラスとしてひとまとめにし、それぞれのクラスをプログラム部分として記述しようというのである。\({\Huge,\hspace{-0.4em},}\)
------ オーレ・ヨハン・ダール, トニー・ホーア, III 階層的プログラム構造. p.199[7]
基本的にクラス構造は以下の2つのプログラム構造から成ります。
- 概念を表すために必要となるデータ構造(変数群)
- 概念の振る舞いを表すための手続き・関数群
このクラス構造はC言語で(強引に)例えるのであれば、ある構造体にその構造体に関係する手続きや関数を付け加えたものと考えてください。 このクラスを中心とした設計手法は、今日に至るまで様々な言語においてより設計が便利になるように概念が拡張と洗練がなされてきました。
クラスオブジェクトのみでプログラムが構成されるプログラミング言語であるSmalltalkや、初めての実用的なクラス設計が可能となった言語であるC++(とその前身であるC with Classes)は、特にSimula 67の大きな影響を受けています[12]。本演習で利用するJavaは、これら言語のうち、C++の設計思想上に位置します。
Javaにおけるクラスとはどのようなものか、クラスの解説は第1週で説明した内容と重複しますが、以降であらためて解説します。
public class User {

	public String familyName;
	public String firstName;

	public String getUserName() {

		return familyName + " " + firstName;
	}
}
public static void main(String[] args) {
	// クラス定義からオブジェクトの作成
	User u = new User();

	// クラスのフィールドへの代入
	u.familyName = "Tanaka";
	u.firstName = "Taro";

	// クラスのメソッドの利用
	String uname = u.getUserName();

	System.out.println(uname);
}
図3にクラスの例を示します。図3のUserクラスは、なんらかのユーザ情報の概念化した例です(図5)。

図4における3行目にて、図3で定義されたクラスUserに言及して図6のように書き下されています。
User u = new User();
これは、Userという概念(クラス)から、新しく実例(インスタンス)をnew することで作成し、変数uに作成した実例を割り当てた(図7)、と解釈できます。
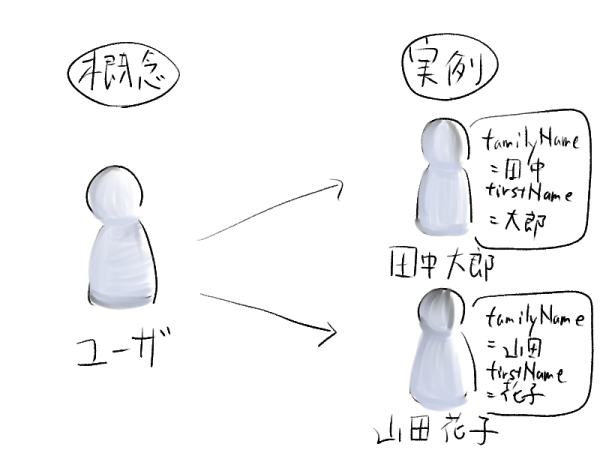
誤解を恐れずに例えるならば、クッキーの型をクラスとすると、その型を使って大きなクッキー生地(メモリ空間)から切り出した(newした)、型の形をしたクッキー生地(確保したメモリ領域)がインスタンスです。先に述べたオブジェクトは、このクラスの実例であるインスタンス1と同じ意味で使われることが多いです。
ここで、Userクラスは、int型やString型などと同じで、User型を表しており、基本的にUser型インスタンスはUser型変数にしか代入できません。
図3に定義されているクラスは変数(フィールド)と手続きや関数(メソッド)を中に含んでいます。
ここで定義されているメソッドは、これまでの各週のプログラムでクラス内に定義したメソッドと異なり、クラスメソッド(static修飾子が付けられたメソッド)ではありません。このようなメソッドをインスタンスメソッド と呼びます。
このインスタンスメソッドは、読んで字のごとく、オブジェクト(インスタンス)から呼び出すことができるメソッドです。従って、クラスから直接呼び出すことはできません。 例えば、図4の6行目、7行目、10行目に示すように、3行目で作成したオブジェクト(インスタンス)から、呼び出していることがわかります。
基本的にクラス構造を使ったプログラムは、以下の流れが入れ子構造になることで形作られることに注意してください。
- クラスからオブジェクト(インスタンス)作成
- オブジェクト(インスタンス)を介してメンバーやメソッドを呼び出す
ここで、図3のプログラムを見ると、3行目や4行目の変数や6行目のメソッドの前にpublicと呼ばれる修飾子がついていることが分かるはずです。この修飾子は図8で示すようなフィールドやメソッドのシグネチャで利用され、アクセス修飾子と呼ばれます。
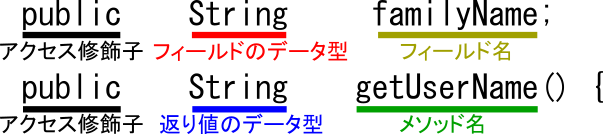
アクセス修飾子については、詳細は次の節で説明しますが、少なくともpublicとなっている変数やメソッドは、図9で示すように、クラス外の別メソッドから、作成したオブジェクト(インスタンス)に対して.(ピリオド)を介することで、C言語の構造体のメンバーと同様に、変数の値を取得したり、メソッドを呼び出したりしてメンバーを利用することができます。
// オブジェクトのフィールドへの代入
u.familyName = "Tanaka";
u.firstName = "Taro";

// オブジェクトのメソッドの利用
String uname = u.getUserName();
[7]: エドガー・ダイクストラ, トニー・ホーア, オーレ・ヨハン・ダール, ``構造化プログラミング'', サイエンス社 (1975)
[12]: B. Stroustrup, ``C++の設計と進化'', ソフトバンクパブリッシング (2005)
定義に揺れがありますが、オブジェクトはクラスから作り出した概念上のものを含む実例であり、インスタンスはクラスから作り出した実例の実際のメモリ上のデータ構造を指します。まとめるとオブジェクトのうち特にメモリ上にあるものを指し示したい時、インスタンスと呼びます。
実験課題2
Exercise 2(課題2) See the section 4.2.1. "Access Control for Members in Class". Show the execution result of modified Figure 3 of project chapter4kadai1 to Figure 10 and its error message as a screenshot. Further, explain the cause for the error.
(4.2.1.節をよく読み、プロジェクトchapter4kadai1の図3のプログラムを図10に改変し実行を行い、エラー内容を示し、なぜそのエラー内容となったか説明しなさい。)
メンバーのアクセス制御
この節の要点
- アクセス修飾子には主に
publicとprivateがある。public修飾子はそのメンバーがインスタンスの外部からアクセスできることを示す。private修飾子はそのメンバーがインスタンスの外部からアクセスできないことを示す。
アクセス修飾子を指定することで、クラスメンバー(クラスフィールドやクラスメソッド)の呼び出しができる範囲(アクセシビリティ)を決めることができます。 アクセス修飾子はいくつか存在しますが、もっぱら次の2つが使われます。
publicpublicが付けられたクラスメンバーは一番呼び出し範囲が広く、インスタンスを作成できれば、取得や呼び出すことができるメンバーを意味します。
privateprivateが付けられたクラスメンバーは一番呼び出し範囲が狭く、同じクラス内のメソッドからのみ、取得や呼び出すことができるメンバーを意味します。
図10に図3のクラスメンバーのフィールドのみprivateにしたプログラムを示します。
public class User {

	private String familyName;
	private String firstName;

	public String getUserName() {

		return familyName + " " + firstName;
	}
}
図10に改変したプログラムの場合、オブジェクトからピリオドを使ってメンバーが呼び出せないことが実行することで分かるはずです。
クラス構造においては、このメンバーに対するアクセス制御を適切に設定することで、変更に強いプログラムを作ることにつながります。
さて、これまでに、Javaのプログラムをいくつか作成してきましたが、クラス内に含まれるmainメソッドや、mainメソッドから呼び出されるメソッドにはすべてstatic修飾子がついていました。
static修飾子をもつメソッドをクラスメソッドと呼びましたが、より一般的に、static修飾子がついたメンバーを静的メンバーと呼びます。図11に静的メンバーの定義例を示します。
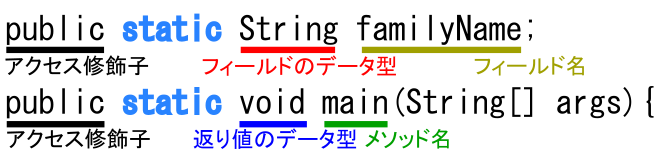
この静的メンバーは、プログラム中に1つしか存在しないことを保証されたメンバーです。よってnew演算子を使ってオブジェクトを作成せずとも、クラス名.メンバー名で呼び出すことができます。また、静的メンバーはオブジェクトをいくつ作成しても、メモリ上には新たに領域が確保されることはありません。このため、データを共有する際に使われることがありますが、静的フィールドはなるべく使うべきではありません。
なお繰り返しになりますが、静的メンバーは、外部のメンバーを参照する際に、同じ静的メンバーしか参照できません(インスタンスメソッドやフィールドに直接アクセスできません)。
実験課題3
Exercise 3(課題3) See the section 4.3.1. "Data Abstraction and Encapsulation". Show the modified source code of Figure 12 and its execution result as a screenshot. Follow instructions below to run the program.
- create the Java application project named
chapter4kadai3. - create
mainmethod to run the program. - take the screenshot of the execution result.
(4.3.1.節をよく読み、プロジェクトchapter4kadai3を作成し、図12に示すプログラムを作成し、課題1の実行結果と同じものになるようにmainメソッドを変更し、ソースコードとスクリーンショットを報告しなさい。)
データ抽象化とカプセル化
この節の要点
- 内部のデータ構造を意識せずに処理を利用できるようにすることをデータ抽象化と呼ぶ。
- アクセス修飾子を用いて、他のクラスから参照してほしくない箇所は
privateを設定する、メソッドを駆使してデータを受け取るなどして、内部処理やデータを意識しない状態にする(誤解を恐れずに言うのであれば、外部から参照できる箇所を適切に設定する)ことをカプセル化と呼ぶ。
図1のUserクラスを使う場合、図4の6行目、7行目のように作成したオブジェクトのフィールドを直接参照して値を代入していました。この場合、別モジュール(クラス)の内部データを直接編集していることになり、利用するクラス間でのモジュール結合度が高まります。
実際のところ、フィールドとメソッドの抽象度を比較すれば、明らかにフィールドの抽象度の方が低く具体的であり、メソッドの抽象度の方が高いわけです。例えば、図3のUserクラスでは、名前を姓familyNameフィールドと名firstNameフィールドに分割してより詳細な情報として保持しており、それらのなんらかの具体的な加工方法を考えなければなりません。
ですが、getUserNameメソッドが提供する機能はユーザ名を返却することであり、メソッドを呼び出す側からすればユーザ名が返却されることだけを考えるだけですみます。すなわちクラスを使う側からすれば内部データを気にする必要がなくなるわけです。従って、仮にfamilyNameフィールドの名称を変更したい、もしくはgetUserNameメソッドの内部処理を変更したいという要望が生まれたとしても、メソッドを介したやり取りを心がけていた場合、変更箇所が少なく済むことになるわけです。
フィールドを介するよりもメソッドを介することで構造化プログラミングにおいても要点であった抽象化が図られるわけです。
図3のUserクラスについて、フィールドを使ったデータ初期化を、setUserNameメソッドを使ったデータ初期化に変更したものを図12に示します。
public class User {

	private String familyName;
	private String firstName;

	public void setUserName(String name) {

		String[] nameParts = name.split(" ");

		familyName = nameParts[0];
		firstName = nameParts[1];
	}

	public String getUserName() {

		return familyName + " " + firstName;
	}
}
このように、内部構造を意識することなくデータ(オブジェクト)を扱うことができるようにクラスを設計することをデータ抽象化(Data Abstraction)と呼びます[13]。
このデータ抽象化の中でも特に、クラス内のデータ構造を直接利用できないようにアクセス制限し、その代わりにメソッドを介してやり取りすることで具体的な構造を包み隠すことをカプセル化(Encapsulation)と呼びます[14]。
[13]: L. Barbara, ``Keynote address – data abstraction and hierarchy'', ACM SIGPLAN Notices. ACM, 23 (1988)
[14]: A. Shalloway, and J.R. Trott, ``- デザインパターンとともに学ぶ - オブジェクト指向のこころ'', 丸善出版 (2014)
実験課題4
Exercise 4(課題4) See the section 4.3.1. "Data Abstraction and Encapsulation". Show the source code to use static member of below figure and its execution result as a screenshot. Follow instructions below to show the result.
- create the Java application project named
chapter4kadai4. - add the project
chapter4kadai3tochapter4kadai4. - create
Cacheclass such as below figure in the projectchapter4kadai4. - modify the source code of figure 12 to store the
familyNamedata to static memberCache.nameinsetUserNamemethod ofCacheclass - take the screenshot of the execution result.
public class Cache {

	public static String name = "";
}
(4.3.1.節をよく読み、図に示すCacheクラスをプロジェクトchapter4kadai3に追加し、図12のUserクラス内のsetUserNameメソッド内で、setUserNameメソッドを実行するたびにfamilyNameを、Cacheクラスの静的メンバーであるCache.nameフィールドに保存するように改変し、ソースコードを報告しなさい。)
実験課題5
Exercise 5(課題5) See the section 4.5.1. "About Constructor". Show the execution result of Figure 18 and Figure 19 as screenshot. Further, explain the difference between this program and Figure 12. Follow instructions below to run the program.
- create the Java application project named
chapter4kadai5. - add
Userclass to this project. - create
mainmethod to run the program. - take the screenshot of the execution result.
(4.5.1.節をよく読み、プロジェクトchapter4kadai5を作成し、図18および図19の実行結果をスクリーンショットで報告しなさい。また、図12のプログラムとの違いを説明しなさい。)
コンストラクタ
この節の要点
- クラスから
newを使ってオブジェクトを作成する時、コンストラクタとよばれる特殊なメソッドが呼び出される。- コンストラクタはオブジェクト内のフィールドの初期化などを目的としたメソッドである。
thisキーワードは、インスタンスメソッド内で、呼び出したオブジェクトそれぞれのフィールドやメソッドを指し示す際に使う。
クラスからオブジェクトを生成するにあたって、オブジェクト内のデータを初期化することを目的として用意されている特殊なメソッドをクラスに定義できます。このメソッドをコンストラクタと呼びます。
図13にコンストラクタを定義したクラス例を示します。 返り値の型が無いクラスと同じ名前のメソッドがコンストラクタです。
public class Hello {

	/**
	 * Helloクラスのコンストラクタ
	 */
	public Hello() {

		System.out.println("こんにちは");
	}
}
public static void main(String[] args) {

	System.out.println("オブジェクトの作成前");

	Hello echo = new Hello();

	System.out.println("オブジェクトの作成後");
}
図13に示すプログラムのコンストラクタを取り出すと、図15になります。
public Hello() {

	System.out.println("こんにちは");
}

コンストラクタは、図16に示す通り、new演算子を使ってクラスからオブジェクトを生成した直後に実行されます。つまり、図15における5行目の命令実行のタイミングでコンストラクタが実行されます。
この図13、図14のプログラムを実行すると、出力タブに図17のテキストが表示されます。
オブジェクトの作成前
こんにちは
オブジェクトの作成語
また、コンストラクタは図18の例のように、引数付きで定義することもできます。
public class User {

	private String familyName;
	private String firstName;

	public User(String familyName, String firstName) {

		this.familyName = familyName;
		this.firstName = firstName;
	}

	public String getUserName() {

		return this.familyName + " " + this.firstName;
	}
}
public static void main(String[] args) {

	User u = new User("Tanaka", "Taro");

	System.out.println(u.getUserName());
}
図18のUserクラスは、ユーザデータを表す概念です。この場合、図19の3行目のようにオブジェクト生成をする際に引数を渡す必要があります。
public User(String familyName, String firstName) {

	this.familyName = familyName;
	this.firstName = firstName;
}
ここで、図17のコンストラクタ定義を見ると、this キーワードを使っています。thisキーワードは、クラスのメソッド内で使うことができる特殊なキーワードです。
このthisキーワードは、個々にnewで作成したオブジェクトそのものを示します。従って、図20のようにオブジェクトが持つメソッドやフィールドをthisキーワードにピリオドを介して呼び出すことができます。
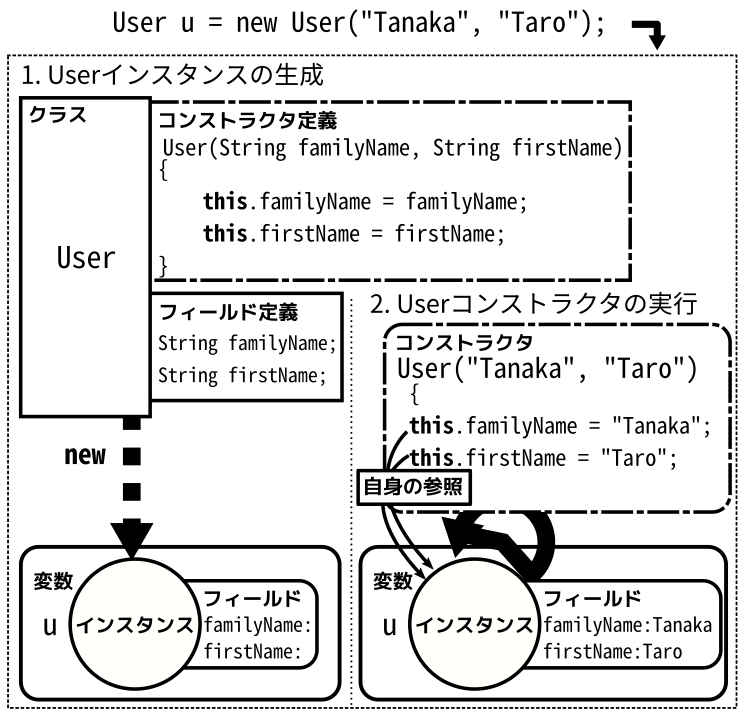
ここで、thisキーワードを省略した場合も同様にオブジェクトが持つメソッドやフィールドを呼び出すことになります。しかし、メソッド引数名とフィールド名が重複していた場合、メソッド引数の呼び出しが優先されるため、同名のフィールドを呼び出す場合はthisキーワードを介して呼び出す必要があります。
実験課題6
Exercise 6(課題6) See the section 4.6.1. "Class of List Structure". Show the complete source codes of Figure 22, Figure 24, Figure 25, and Figure 26 and its execution result as a screenshot. Follow instructions below to run the program.
- create the Java application project named
chapter4kadai6. - create
mainmethod to run the program that display the list structure with for loop. - take the screenshot of the execution result.
(4.6.1.節をよく読み、プロジェクトchapter4kadai6を作成し、図22、図24、図25、図26とfor文を組み合わせて、リスト構造の中身を表示するプログラムを作成し、ソースコードと実行結果をスクリーンショットで示しなさい。)
リスト構造のクラス
この節の要点
- Javaでリスト構造を表現したクラスとしてjava.utilパッケージにあるArrayListクラスがある。
- リスト構造は、メモリが許す限り、データを連結しつづけることができるデータ構造である。
これまでによく使ってきたデータ構造として、配列がありました。
配列はメモリ消費が少なく簡潔なデータ構造ですが、データ抽象化の観点において問題がありますし、なにより配列サイズを動的に増やすにあたって既存のメモリ領域を拡張して増やすのではなく、新しくメモリ領域を確保しなおして増やすことになるため非効率です。
配列構造と似たデータ構造としてリスト構造があります。
現代的なプログラミング言語においては、一般的に配列よりもリスト構造を使うことが多いです。
配列が、変数宣言をした際にデータ構造の大きさ(すなわち配列の長さ)が固定される静的なデータ構造であることと対照的に、リスト構造は、変数宣言した際にデータ構造の大きさを指定する必要がない動的なデータ構造です。
リスト構造には様々な種類があるもののJavaにおいてはリスト構造はクラスとしてjava.utilパッケージに用意されており、最もよく使われるリスト構造のクラスとしてArrayListクラスが有名です。ArrayListクラスは図23でパッケージを読み込んだ後、図22のようにオブジェクトを作成して使うことが多いです。
ArrayList<Integer> sampleList = new ArrayList<Integer>();
import java.util.ArrayList; // 先頭からクラス定義が始まる前までに記述される
ArrayList<T>クラス型におけるTは内部で保持するデータ型であり、プリミティブ型の指定ができません。プリミティブ型にはそれに対応する参照型が存在するため、プリミティブ型を指定したい場合は対応した参照型を指定する必要があります。典型的な対応例を次に示します。
int型(プリミティブ型) <->Integer型(参照型)double型(プリミティブ型) <->Double型(参照型)
つまり、もしdouble型のデータを保持するリストを使う場合は、図22をArrayList<Double>として指定してあげなければなりません。
ArrayListオブジェクトへデータを新しく追加するためには、boolean add(T e)メソッドを使います。addメソッドは、引数で与えられたデータを、リスト構造の末尾に付け加えます(図24)。
sampleList.add(3);
sampleList.add(1);
sampleList.add(4);
sampleList.add(1);
sampleList.add(5);
また、リストに格納されたデータは、図25のようにT get(int i)を使ってインデックスiを指定することで、取得できます。
System.out.println(sampleList.get(0));
リストが持つ要素数は図26に示すようにint size()メソッドを使うことで取得できます。
System.out.println(sampleList.size());
実験課題7
Exercise 7(課題7) See the section 4.6.1. "Class of List Structure". Show the execution result of below figure. Further modify the source code of below figure to use array structure, and show its execution result as a screenshot and source code. Follow instructions below to run the program.
- create the Java application project named
chapter4kadai7. - create
mainmethod to run the program. - take the screenshot of the execution result.
- modify the program to use array structure with same execution result.
- take the screenshot of the execution result.
public static void main(String[] args) {
	ArrayList<Integer> nums = new ArrayList<Integer>();

	Scanner scan = new Scanner(System.in);

	String input = scan.nextLine();

	String[] terms = input.split(" ");

	for (int i = 0; i < terms.length; i = i + 1) {

		nums.add(Integer.parseInt(terms[i]));
	}

	int sum = 0;
	for (int n: nums) {

		sum = sum + n;
	}

	System.out.println(sum);
}
(4.6.1.節をよく読み、プロジェクトchapter4kadai7を作成し、図に示すArrayListクラスを使った総和を求めるプログラムを作成し実行結果を報告しなさい。また、ArrayListクラスではなく配列を使うように実行結果が変わらないようにプログラムに変更してソースコードと実行結果を報告しなさい。)
実験課題8
Exercise 8(課題8) See the section 4.8.1. "Inheritance". Show the execution result of Figure 27 and Figure 28 as a screenshot. Further, explain the execution order of each constructor in classes. Follow instructions below to show the result.
- create the Java application project named
chapter4kadai8. - create
mainmethod to run the program. - take the screenshot of the execution result.
(4.8.1.節をよく読み、プロジェクトchapter4kadai8を作成し、図27、図28のプログラムとコンストラクタを呼び出すmainメソッドを作成した上で実行し、コンストラクタの実行順序を説明した上でスクリーンショットを報告しなさい。)
継承とは
この節の要点
- 既にあるクラスを元に別のバリエーションのクラスを作る方法を継承と呼ぶ。
\({\Huge ``}\)... we develop a method by which more elaborate concepts can be constructed on the basis of simpler ones. This will establish potential hierarchies of concepts, with complex concepts subordinate to the more simple ones in terms of which they are defined. \({\Huge,\hspace{-0.4em},}\)
----- Ole-Johan Dahl, C. A. R. Hoare, III Hierachical Program Structures, p.202[7]
\({\Huge``}\)単純な概念をもとにして、もっとこみ入った概念を構成する方法を開発することにしよう。これにより、複雑な概念はそれを定義する単純な概念に従属する、という意味で、概念に階層をつけることになる。\({\Huge,\hspace{-0.4em},}\)
------ オーレ・ヨハン・ダール, トニー・ホーア, III 階層的プログラム構造. p.226[7]
構造化プログラミングにおいて、ダイクストラが主張するプログラムの階層化は、(当時のプログラミング言語の仕様上)プログラム構造のテキスト的・順序的・文脈的な構造化で実現されていたこと対し、オブジェクト指向プログラミングにおいては、テキスト(モジュール)の階層化ではなく概念(クラス)の階層化をします。この概念の階層化によって、モジュールの独立性を高めることを目指すわけです。
オブジェクト指向プログラミングにおける概念の階層化する方法として継承(inheritance) 1 があります。具体的には、あるクラス(上位の概念)からサブクラス(従属する下位の概念)を構成することを継承と呼びます。ここで、継承元クラスをスーパークラスあるいは基底クラスとも呼びます。
下位の概念は、上位のより一般性を持った概念と振る舞いを共有することは容易に想像できます。サブクラスでは、スーパークラスのメソッドやフィールドを再定義することなく利用することができます。よって、下位の概念を新たに作成する際には、既存の概念の定義を流用する形で拡張機能のみを追加定義することになり、拡張性が高まることになります。
図28に継承の例として、図27のHelloクラスを継承したIntroductionクラスを示します。
public class Hello {

	public Hello() {

		System.out.println("こんにちは");
	}
}
public class Introduction extends Hello {

	public Introduction(String name) {

		super();	// スーパークラスのコンストラクタ呼び出し
		System.out.println("私の名前は" + name + "です");
	}
}
継承を行う際には、図29に示すように、クラス名(ここではIntroductionクラス)の宣言直後のセミコロンに続いて、継承するクラスであるスーパークラス名(ここではHelloクラス)を記述することで、クラスの継承関係(IntroductionクラスはHelloクラスを継承する)を定義しなければなりません。
public class Introduction extends Hello {

サブクラスのインスタンス生成にあたって初期化を行う上で、同時に継承元の基底クラス(スーパークラス)を表現するためのデータの初期化も行わなければならない(そうでなければ基底クラスの振る舞いに対する用意ができない)。
図31に示すように、コンストラクタの内で、superキーワードをメソッドのように呼び出しています。superキーワードは、スーパークラスそのものを表していて、コンストラクタとして呼び出したり、あるいは、thisキーワードと同様にスーパークラスのフィールド・メソッド呼び出しとしても利用できます。
図30にスーパークラスのコンストラクタ呼び出しのイメージを示します。サブクラスのコンストラクタを呼び出した際には、サブクラスの初期化処理を実行する前に、superキーワードを使ってスーパークラスのコンストラクタを呼び出すことになります。
public Introduction(String name) {

	super();	// スーパークラスのコンストラクタ呼び出し
また、他の継承の例として、図32のUserクラスを継承したStudentクラスを示します。Studentクラスは学生データを表す概念であり、ユーザデータの概念の下位の概念に相当する。ここでは学籍番号の取得のためのメソッドであるgetIDメソッドが追加されている。
public class Student extends User {

	private String studentID;
	private int entryYear;
	private int no;

	public Student(int no, int entryYear, String familyName, String firstName) {

		super(familyName, firstName);
		this.no = no;
		this.entryYear = entryYear;
		this.studentID = "u" + familyName.charAt(0) + firstName.charAt(0) + (entryYear - 100 * (entryYear / 100)) + String.format("%02d", no);
	}

	public String getID() {

		return this.studentID;
	}
}
public static void main(String[] args) {

	Student s = new Student(1, 2019, "Tanaka", "Taro");

	System.out.println(s.getID());
	System.out.println(s.getUserName());
}
図32のコンストラクタの宣言(図34)を見れば分かるように、スーパークラスのコンストラクタが引数を必要としている場合は、自コンストラクタの引数を渡すことで対応しなければなりません。また、図33のソースコードを見れば分かるように、Studentクラスに定義していないスーパークラスに定義されているgetUserNameメソッドが呼び出すことができます。
このように、少なくともスーパークラスでpublicなアクセス修飾子が設定されているメンバーであれば、サブクラスから呼び出すことが可能です。
public Student(int no, int entryYear, String familyName, String firstName) {

	super(familyName, firstName);
[7]: エドガー・ダイクストラ, トニー・ホーア, オーレ・ヨハン・ダール, ``構造化プログラミング'', サイエンス社 (1975)
継承は、最初期(特にSimula 67)においては連接(concatenation)と呼ばれていました[7]。Simula 67においてはクラスとクラスの連接だけでなく、クラスとブロックの連接が用意されており、厳密には今日の継承とは異なっていたことも関係しています。
実験課題9
Exercise 9(課題9) See the section 4.8.1. "Inheritance". Explain the ID rule of getID method. Further, show the execution result and complete source code of Figure 18, Figure 32, and Figure 33. Follow instructions below to show the result.
- create the Java application project named
chapter4kadai9. - add
Userclass andStudentclass to this project. - create
mainmethod to run the program such as Figure 33. - take the screenshot of the execution result.
(4.8.1.節をよく読み、プロジェクトchapter4kadai9を作成し、図18のUserクラスを追加した後、図32のStudentクラスを作成して、図33のようにmainメソッドから実行しなさい。またソースコードとスクリーンショットを報告しなさい。また、getIDメソッドが返すIDのルールを説明しなさい。
なお、図に示す、文字列オブジェクトが持つchar charAt(int i)メソッドは、文字列オブジェクトのi+1番目の文字を返却するメソッドである。
System.out.println("Hello,World.".charAt(4)); // oが表示される。
また、C言語におけるsprintfのような整形した文字列を作成するメソッドとしてString String.format(String formatStr, Object... args)メソッドがある。引数のformatStrがフォーマット文字列である。)
System.out.println(String.format("%02d", 3)); // 03が表示される。%02dとは整数型(d)として2桁まで0埋めした文字列を返すフォーマット文字列である。
レポート課題
Homework 1(調査課題1) Show three examples of the concept and instance pairing in the real world with such as Figure 7.
(図7の様な、現実世界における概念と実例(2つ)の組み合わせを3つ述べなさい。)
Homework 2(調査課題2) Explain why the use of static member is not better in the class such as Cache of Exercise 4.
(実験課題4のCacheクラスのnameのような静的メンバーを使うべきでない理由を調べ報告しなさい。)
Homework 3(調査課題3) Explain the encapsulation in the object oriented programming.
(オブジェクト指向プログラミングにおけるカプセル化について説明しなさい。)
Homework 4(調査課題4) Show three examples of the pairings between inheritanced concept and each original concept that you show in Homework 1.
(調査課題1で示した現実世界における概念と実例に対応する(オブジェクト指向におけるクラスと継承したクラスの関係として対応付けることが出来る)継承した概念をそれぞれについて3つづつ述べなさい。)
多態性と抽象型
ここまで、目的の処理を正しく実現するプログラムを記述するための方法として、構造化プログラミングとはどういうものかについて触れ、 仕様変更に強いプログラム(再利用性・保守性が高いプログラム)を作成するための方法として、クラスと呼ばれるプログラミング構造を触れてきました。
前の節では、クラス構造は継承を使うことで、上位と下位の概念の階層を定義できることを示しました。 ですが、単に概念の階層化を定義しただけで、保守性や再利用性を高めることに繋がるとは限りません。 保守性や再利用性を高めるためには、多態性と呼ばれる階層化した概念が持つ性質を活かす必要があります。
多態性(Polymorphism)とは、継承を軸としたクラスとオブジェクトを駆使するオブジェクト指向プログラミングにおける最も根幹となる仕組みです。
この節では、多態性とはどのようなものか、継承によって定義されるスーパークラス、サブクラスといった概念の階層をより抽象的に実現するための仕組みである、抽象クラス(Abstract class)、インタフェース(Interface)に触れていきます。
実験課題1
Exercise 1(課題1) See the section 5.1.1. "About Polymorphism". Show the execution result of Figure 3 and 4 and its complete source codes by the import of external project chapter4kadai9. Follow instruction below to show the result.
- create the Java application project named
chapter5kadai1. - import external project named
chapter4kadai9to this project by using the way of 2.1.2.節の方法. - create main method to run this program.
- take a screenshot of the execution result.
(5.1.1.節をよく読み、プロジェクトchapter5kadai1を作成し、2.1.2.節の方法を使って、プロジェクトchapter4kadai9を参照しなさい。その後、図3および図4を実行し、実行結果をスクリーンショットで報告しなさい。)
多態性とは
この節の要点
- 継承した子クラスオブジェクトを親クラスオブジェクトとして扱うことができる言語機能を使って、どんな子クラスオブジェクトでも1つの親クラスオブジェクトの処理としてまとめることができる性質を多態性と呼ぶ。
オブジェクト指向プログラミング言語において、継承関係にあるクラスのオブジェクトは上位クラスのオブジェクトとして扱うことができます。
このようなある型(クラス)から生成されたオブジェクトを、本来の型(クラス)ではない別の型(クラス)のオブジェクトとして扱うことを型キャスト と呼びます。例えば、C言語などでは、ある型から別の型にキャストをする際に、図1のように明示的にキャスト演算子、ここでは(int)を使う必要があります。
float fx = 1.5;
int ix = (int)fx;	// float型をint型としてキャスト
Javaにおいて、スーパークラスと継承関係にあるサブクラスには、代入互換性(Assignment compatibility)があります。この代入互換性とは、キャスト演算子を使うことなく別の型に代入することができる性質です。 つまり、スーパークラスの変数にサブクラスのオブジェクトをキャスト演算子なしで代入することができます。型キャストすることで下位の概念を上位の概念として扱うことができるわけです。
ここで、上位の概念(スーパークラス)の振る舞いは下位の概念(サブクラス)でも同様に再現できるはずですが、下位の概念を上位の概念として捉えた時、その振る舞いは下位の概念のごとに異なるはずです。
例えば、自動車という概念は、軽自動車やスポーツカーなどの下位の概念を持ちます。ここで自動車の概念には、下位の概念を包括する振る舞いが存在するはずです。例えば、図2に示すように、ドアを開ける振る舞いであったり、エンジンを動かす振る舞いなどです。これら振る舞いは、軽自動車やスポーツカーなどの下位の概念が与えられた際には、下位の概念ごとの個別の振る舞い(ドアの開け方であったりエンジンの動かし方は下位の概念ごとに異なるため)に依存しています。
すなわち、プログラム的には、サブクラスのオブジェクトをスーパークラスのオブジェクトとして扱った際に、スーパークラスのメソッドを実行すると、サブクラスの実装が反映されたメソッドが実行された方が自然です。
図3に、具体例を示します。図3は、ユーザデータを表すUserクラス(第4週の図18参照)を継承した教員データを表すTeacherクラスの例です。Teacherクラスにおいては、getUserNameメソッドにて名前文字列を取得する際に、役職文字列を追加する拡張を行っています。
public class Teacher extends User {

	private String role;

	public Teacher(String role, String familyName, String firstName) {
		super(familyName, firstName);	// スーパークラスのコンストラクタ呼び出し

		this.role = role;
	}

	@Override
	public String getUserName() {

		return this.role + super.getUserName();
	}
}
public static void main(String[] args) {

	Teacher t = new Teacher("Prof.", "Yukawa", "Hideki");
	User u = t; //Teacher型(サブクラス)をUser型(スーパークラス)として扱う(キャスト)

	System.out.println(u.getUserName());
	System.out.println(t.getUserName());
}
先に述べた上位概念と下位概念の関係性からして、図4を実行した際に、6行目の結果と7行目の結果が同じにならなければなりません。ここで、Javaではスーパークラスの特定のメンバーの実装をサブクラスで改変したことを示す注釈(annotation) を追加する必要があります。
@Override	// 追加した注釈
public String getUserName() {
図5においては、@Override 注釈をメソッドの上部に追加しました。@アットマークから始まるキーワードをJavaでは注釈と呼び、クラス内のメンバーがどのように動作するか説明するための補助的な情報のことを言います。@Override注釈は、続くメソッドが、スーパークラスで定義されているメソッドの実装を、別の実装で上書きした(オーバーライド した)ものであることを示します。
このように、下位の概念の実例を、上位の概念として振る舞わせた時、下位の概念の振る舞いをそのまま引き継ぐ性質を多態性(Polymorphism) と呼びます。
つまり、下位の概念である「スポーツカー」を上位の概念である「車」として扱っても、「車」の振る舞いは「スポーツカー」として定義されている振る舞いそのものになる、ということです。多態性が導入されることで、特定の下位の概念かどうかを判断する制御構造を導入する必要がなくなり、結合度や凝集度を高めることにつながります。
[an error occurred while processing the directive]実験課題2
Exercise 2(課題2) See the section 5.1.1. "About Polymorphism". Explain the polymorphism on the program of below figures. Further, show the execution result of below figures by importing external projects chapter4kadai9 and chapter5kadai1, and its source code. Follow instruction below to show the result.
- create the Java application project named
chapter5kadai2. - import external projects named
chapter4kadai9andchapter5kadai1to this project by using the way of 2.1.2.節の方法. - create the main method to run this program as below figures.
- take a screenshot of the execution result.
public static void helloUser(User u) {

	System.out.println("Hello " + u.getUserName() + '!');
}

public static void main(String[] args)
{
	Student s = new Student(1, 2030, "Tanaka", "Taro");
	Teacher t = new Teacher("Prof.", "Tsuyama", "Taro");

	helloUser(s);
	helloUser(t);
}
(5.1.1.節をよく読み、プロジェクトchapter5kadai2を作成し、プロジェクトchapter4kadai9とchapter5kadai1を参照しなさい。その後、上図のプログラムを作成し、実行後スクリーンショットを報告しなさい。また、プログラム中で多態性が機能している箇所を説明しなさい。)
実験課題3
Exercise 3(課題3) See the section 5.3.1. "Abstract Class", the section 5.3.2. "Propagation simulation: Life class," and the section 5.3.3 "Propagation simulation: Space class". Show the execution result of simulation program described before this and its complete source code. Follow instruction below to show the execution result.
- create the Java application project named
Simulation01. - create some classes of the simulation program before this exercise.
- modify
mainmethod to fit Figure 31 toSimulation01class. - take a screenshot of the execution result.
(5.3.1.節、5.3.2節、5.3.3節をよく読み、プロジェクトSimulation01を作成しなさい。その後、図31のmainメソッドをSimulation01クラスに作成し、ここまで示してきたシミュレーションプログラムを完成させなさい。その後、実行結果をスクリーンショットで報告しなさい。)
抽象クラス
この節の要点
- 抽象的な概念を表現するためのクラスを抽象クラスと呼ぶ。
- 抽象クラスは少なくとも1つの抽象的な振る舞いを表現する実装がない抽象メソッドを持つ。
- 抽象クラスはオブジェクトを作ることができない。関係するオブジェクトを作る場合は、継承して子クラスを作り、そのクラスに対してオブジェクトを作る必要がある。
概念(クラス)による階層化を行う上で、概念が抽象的であるがゆえに振る舞いを定義できない場合がよくあります。
例えば、「動物」の概念を想像してみましょう。このとき、「猫」や「犬」は明らかに下位の概念です。ここで、「動物」の普遍的な振る舞いとして、「鳴く」という振る舞いが定義できると思います。すると、下位の概念である「猫」や「犬」では「鳴く」ときの振る舞い、例えば「ニャーニャーと発声する」「ワンワンと発声する」を定義できるはずです。しかし、上位の概念である「動物」において、「鳴く」という具体的な振る舞いを定義することは困難です(図6)。これは、あまりに普遍的な概念であることが原因であると言えます。仮に無理に定義を試みようとしても、せいぜい「発声する」というあまり具体的でない共通した振る舞いを定義できる程度であり、あえて定義したとしてもその振る舞いとして利用する意味が見いだせない、と言ったことが考えられます。
(この場合は便宜的に典型的な共通認識を「猫」や「犬」として定義していますが、厳密には種として例えば「ヨーロッパヤマネコ」や「タイリクオオカミ」などの下位の概念において振る舞いが定義されるべきです)
プログラムにおいても、継承を前提としたクラス階層を定義する際、定義することが困難な上位クラスが持つ抽象的な振る舞いを、例外的な処理を定義することで無理に実装することは、クラスの凝集度を下げることになります。
こうした抽象的な概念を自然に表現するためのプログラム構造として抽象クラス(Abstract class) があります。
抽象クラスは、抽象的な振る舞いを実現する抽象メソッド(Abstract method) を少なくとも1つ持ちます。この抽象メソッドは 上書きを前提としたメソッド です。抽象クラスを継承したサブクラスにて抽象メソッドの実装を具体的に定義することで上書きすることになります。抽象クラスおよび抽象メソッドはそれぞれアクセシビリティを表す修飾子の次にabstractの修飾子が付けることで表すことができます。図7に抽象クラスの定義(シグネチャ)例、図8に抽象メソッドの定義(シグネチャ)例を示します。
/**
 * 動物を表します。
 */
public abstract class Animal {

	private String name;

	/**
	 * 名前を与えます。
	 */
	public Animal(String name) {

		this.name = name;
	}

	/**
	 * 名前を返却します。
	 * @return 名前。
	 */
	public String getName() {

		return this.name;
	}

	/**
	 * 鳴きます。
	 */
	public abstract void cry();
}
/**
 * 鳴きます。
 */
public abstract void cry();
抽象クラスは、自身そのものからオブジェクトを作ることはできません。なぜならば、振る舞いが抽象化されたままで、どのような振る舞いなのか具体的な処理の実装がなされていないためです。また抽象メソッドは実装を持ちません。あくまでどんなオブジェクトを引数として渡す必要があるか、どんなオブジェクトが返却されるのかという情報だけしか定義しません。
よって、抽象クラスの目的は、継承することを前提として下位概念の自然な定義を行うことを目的としています。
繁殖シミュレーション/生物クラス
この節の要点
- プログラムを構成するクラスをどの様に作ればよいか、確認するための図式記法としてクラス図がある。
final修飾子をつけた変数は、変更できないデータを表し、特にstatic final修飾子は定数を定義する際に利用される。
ここからは、抽象クラスをどのように利用していくか見ていくために、図9のような生物の繁殖シミュレーションプログラムを作成していきましょう。
繁殖シミュレーションとは
シミュレーションプログラムは基本的に図10に示す処理の流れに則って形作られます。
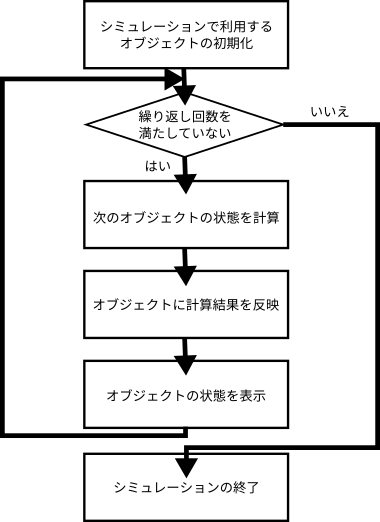
図10のように、シミュレーションとは、先にオブジェクトごとに定められたルールに則って次状態を全て計算し、その後全オブジェクトを次状態へと更新する、といった繰り返し処理を規定回数行い、その結果を示すこと指します。 つまり、繰り返し処理をいかに後から改変可能なプログラム構造にするか、がシミュレーションプログラムにおいては仕様変更に強いプログラムを作るコツになるわけです。
ここで、今回作成するシミュレーションを行う上での仮定、すなわちシミュレーションプログラムの要件を示しておきましょう。
- セルが並べられた1次元の空間に生物を配置する。
- 1次元の空間は左端と右端が繋がっている環状構造とする。
- 生物は設定された寿命になると死滅する。
- 生物が死滅した場合、空間から取り除かれる。
- 生物は1ヶ月ごとに隣接するセルに対して繁殖を行う。
- 1ヶ月ごとに空間の生物の配置状態を表示する。
では、これら仮定を満たすためにどのようなクラスを定義すればよいか考えてみましょう。
生物クラスの実装
はじめに、生物をどのように実現するか、を考える必要があります。要件を見る限り、生物ごと個体ごとに独立した状態を持ち、それぞれが個別に繁殖を行わなければなりません。 従って、直感的に1オブジェクトが1個体となるクラスを定義すれば良さそうです。
シミュレーションプログラムの今後のことを考えると、さまざまな生物をシミュレーションできるように新たな生物を追加しやすいプログラム構造の方が良い(拡張性が高いほうが良い)です。 さまざまな生物を同一の枠組みで実現するためには、その元となる生物クラスはなるべく抽象的である必要があります。 そのためには、先に述べた概念の階層を使って、生物と呼ぶために最低限必要となる抽象的な振る舞いを持った抽象的な生物クラスを作り、そのクラスを継承する形で、具体的な生物の固有の振る舞いを実装したクラスを生物種ごとに定義していく方針が良さそうです。
シミュレーションにおいて最低限必要となりそうな生物の振る舞いを抽出すると、以下になります。
- 成長する。
- 新しい個体を生み出す。
- 個体を何らかの方法で表す。
- 歳を取る。
- 年齢を取得する。
- 死ぬ。
- 死んでいるかどうか判定する。
ここで、「個体を何らかの方法で表す」振る舞いは、例えば「個体の画像として表す」であったり「個体を文字として表す」など考えられます。今回は、ターミナルを使ったプログラムのため、「1文字として個体を表す」振る舞いとします。
さて、これら抽象的な生物クラスのために抽出した不可欠な振る舞いは、すべて抽象的でしょうか。
答えはそうとは限りません。例えば、生物的な死については種ごとに特に違いがあるとは言えず、生物としてみても共通した具体的な同一の状態・振る舞いであると言えます。また、年齢に関する振る舞いついても同様です。抽象の対義語として、具体的に定義できることを具象と呼びます。これら振る舞いは具象的であると言えます。一方、それ以外については、明らかに種ごとに異なる振る舞いです。従って抽象的であると言えます。
なお、空間で隣り合うセルを参照して繁殖を行う都合上、生物自身が自分の位置を把握しておく必要があります。よって、以下の2つの具象的な振る舞いも出来なければなりません。
- 自分の座標を記録する。
- 記録した自分の座標を取得する。
以上を踏まえると、生物の振る舞いを改めて以下にまとめることができます。
- 成長する。(抽象的)
- 新しい個体を生み出す。(抽象的)
- 個体を何らかの方法で表す。(抽象的)
- 歳を取る。(具象的)
- 年齢を取得する。(具象的)
- 死ぬ。(具象的)
- 死んでいるかどうか判定する。(具象的)
- 自分の座標を記録する。(具象的)
- 記録した自分の座標を取得する。(具象的)
ここまでの考察から、以上の振る舞いを、抽象的な生物クラスは持たなければなりません。 ここまで設計したクラス間の関連性をクラス図(Class diagram) で示しましょう。図11に生物クラスのクラス図を示します。オブジェクト指向プログラミングにおいては、クラスとクラスの関連構造を示すためにクラス図が利用されます。
生物クラスが持つべき振る舞いをまとめると図11のように記述できます。クラス図では、そのクラスがどのようなフィールド、メソッドを持つのか明示します。
さて、生物クラスは抽象クラスであり、このクラスを継承して具体的な種のクラスを作成することを検討しました。これまでの検討結果をクラス図で示すと、図12のようになります。
図12では、草と羊を具体的な種クラスとして生物クラスを継承して定義しています。クラス図においては、白抜き三角矢印が継承関係を表します。
図12のクラス図をJavaの実装で書き直すと、例えば、図13になります。
クラス図のメソッドは実装として書き下すとき、図14のルールに則って記述します。
アクセシビリティ記号 メソッド名(引数名: 引数の型): 返り値の型
ここでアクセシビリティは表1のアクセシビリティ記号と対応しています。
| アクセシビリティ | アクセシビリティ記号 |
|---|---|
public | + |
private | - |
なお、 抽象クラスはクラス名を斜体 に 抽象メソッドはメソッド名を斜体 にします。
図13に基づいて、生物クラス Life をプログラムで定義すると図15になります。
ここで、クラス Life は、次の具体的な振る舞いをすることを補足しておきます。
- コンストラクタで寿命(月齢)と初期の空間上のインデックスを設定します。
growOldメソッドを月齢寿命回呼び出すと、死亡状態を判定するisDeadメソッドがtrueを返すようになります。dieメソッドを呼び出すと、isDeadメソッドがtrueを返すようになります。
/**
 * 生物を表します。
 * @author Me
 */
public abstract class Life {

    /**
     * 寿命(月齢)を表します。
     */
    private int lifetime;

    /**
     * 月齢を表します。
     */
    private int month;

    /**
     * 死んでいるかどうかを表します。
     */
    private boolean death;

    /**
     * 空間オブジェクト中の位置を表すインデックスです。
     */
    private int spaceIndex;

    /**
     * 生物個体を初期化します。
     * @param lifetime 月齢で表された寿命。
     * @param spaceIndex 空間配置のインデックス。
     */
    public Life(int lifetime, int spaceIndex) {

        this.lifetime = lifetime;
        this.month = 0;

        this.death = false;

        this.spaceIndex = spaceIndex;
    }

    /**
     * 年齢をヶ月(月齢)で返却します。
     * @return 月齢。
     */
    public int getMonth() {

        return this.month;
    }

    /**
     * 年齢を1ヶ月進めます。
     */
    public void growOld() {

        if (this.month >= this.lifetime) {

            this.death = true;

        } else {

            this.month = this.month + 1;
        }
    }

    /**
     * 死んでいるかどうか判定します。
     * @return trueならば死んでいます。falseならば生きています。
     */
    public boolean isDead() {

        return this.death;
    }

    /**
     * 強制的に死にます。
     */
    public void die() {

        this.death = true;
    }

    /**
     * 空間オブジェクト中で設定されているであろうインデックスを返却します。
     * @return 空間オブジェクト中のインデックス。
     */
    public int getIndex() {

        return this.spaceIndex;
    }

    /**
     * 空間オブジェクト中で設定されているであろうインデックスを設定します。
     * @param index 空間オブジェクト中のインデックス。
     */
    public void setIndex(int index) {

        this.spaceIndex = index;
    }

    /**
     * 1ヶ月間の成長をします。
     */
    public abstract void grow();

    /**
     * 繁殖して、新たな個体を作り出します。
     * @return 新たな個体。
     */
    public abstract Life reproduce();

    /**
     * 個体を文字列で表現します。
     * @return 文字列で表現された個体。
     */
    @Override
    public abstract String toString();
}
草クラスの実装
種の枠組みが出来たので、つぎに具体的な生物クラスを定義してみましょう。ここでは、草クラスを作ってみたいと思います。
具体的な生物クラスは、 grow メソッド、 reproduce メソッド、そして toString メソッドを実装しなければなりません。
草クラスではどのような振る舞いにするべきか、簡潔に以下のように仮定します。
growメソッド(1ヶ月成長する)- 単に1ヶ月分加齢する。
- 親クラスの
growOldメソッドを呼び出すだけ。
- 親クラスの
- 単に1ヶ月分加齢する。
reproduceメソッド(新しい別個体を生み出す)- 30%の確率で、新たな
草オブジェクトを返却する。
- 30%の確率で、新たな
toStringメソッド(1文字として個体を表す)- 文字列
Wを返却する。
- 文字列
ここで、reproduceメソッドは確率に基づいた振る舞いをします。プログラムにおいては、擬似乱数を使うことで確率的な振る舞いを定義できます。
Javaのjava.util.Randomクラスは、現れる数値のばらつきに問題があるものの高速に乱数を生成できる擬似乱数生成器です。図16のように使うことで、乱数を生成できます。
Random rng = new Random(); // 擬似乱数生成器オブジェクトを生成します。
double d = rng.nextDouble(); // 0.0以上1.0未満の範囲でランダムに浮動小数点型のデータを返します。

if (d < 0.4) {

	System.out.println("40%の確率で表示されます。");

} else {
	System.out.println("60%の確率で表示されます。");
}
reproduceメソッドでは、図16のようにRandomクラスオブジェクトを使って、繁殖成功率30%の確率で新たな草オブジェクトを作成するようにします。
ここで、繁殖失敗した場合、reproduceメソッドは何を返却すべきでしょうか。
Cのプログラムなどでは、失敗・例外値としてNULLを返却することがよくあります。
Javaにおいても、参照型の初期値であるnullはどのような参照型変数にも代入できるため、失敗・例外値としてnullを返却することがあります。
しかし、誤ってnullが入った参照型変数を介してメソッドなどのメンバー呼び出しを行うと、例外NullPointerExceptionが発生してしまいます。これでは処理が中断してしまうため、なるべく失敗・例外値としてnullは使うべきではありません。
従って、失敗・例外値となる種を新たに定義してあげることでこれを回避してみましょう。図17のように空の状態を表すEmptyクラスを Life クラスを継承して定義します。
図18にEmptyクラスの実装例を示します。Emptyクラスは基本的に何もしません。 従って、どのような振る舞いにするべきか、簡潔に以下のように仮定します。
growメソッド(1ヶ月成長する)- なにもしない。
reproduceメソッド(新しい別個体を生み出す)- 自分自身を返却する。
toStringメソッド(1文字として個体を表す)- 文字列
.を返却する。
- 文字列
空の状態は不変です。死の状態を持ちません。しかし、便宜的に、空の状態が死んでいる状態か、あるいは生きている状態か、定義しておく必要があります。ここでは、生物が存在していない状態を表すということはすなわち死んでいる状態であると仮定して、isDeadメソッドは常にtrueを返却するとしておきます。
/**
 * 空(から)の状態を表します。
 * @author Me
 */
public class Empty extends Life {

    /**
     * 空間インデックスを持つ空の状態を生み出します。
     * @param spaceIndex 空間の配置を表すインデックスです。
     */
    public Empty(int spaceIndex) {

        super(0, spaceIndex);

        this.die();
    }

    /**
     * 1ヶ月間の成長をします。
     */
    @Override
    public void grow() {

    }

    /**
     * 繁殖して、新たな個体を作り出します。しかし、新たに生み出す必要がないので、自分自身を返します。
     * @return 自分自身を返却します。
     */
    @Override
    public Life reproduce() {

        // 新たに生み出す必要がないので、自分自身を返す。
        return this;
    }

    /**
     * 空の状態を表す記号を返却します。
     * @return 空の状態を表す記号。
     */
    @Override
    public String toString() {

        return ".";
    }
}
以上を踏まえると、図19のような草クラスを定義できます。
import java.util.Random;

/**
 * 草を表します。
 * @author Me
 */
public class Grass extends Life {

    /**
     * 乱数生成オブジェクトです。
     */
    private Random rng;

    /**
     * 草の繁殖成功率です。0.0~1.0で表します。
     */
    public static final double REPRODUCTIVE_RATE = 0.3;

    /**
     * 月齢による種の寿命を表します。
     */
    public static final int LIFETIME = 12;

    /**
     * 指定された空間インデックスを持つ、草を生み出します。
     * @param index 空間インデックス。
     */
    public Grass(int index) {

        // 寿命を月齢で12として設定
        super(LIFETIME, index);

        // 乱数生成オブジェクトを作成
        this.rng = new Random();
    }

    /**
     * 1ヶ月間の成長をします。
     */
    @Override
    public void grow() {

        this.growOld();
    }

    /**
     * 繁殖して、新たな個体を作り出します。新たな個体が作成される条件は、繁殖する個体が死んでいないこと、乱数が繁殖成功率の範囲内に収まること、です。
     * @return 新たな個体。作成できなかった場合は空(から)のオブジェクト。
     */
    @Override
    public Life reproduce() {

        int index = this.getIndex();

        if (this.rng.nextDouble() < REPRODUCTIVE_RATE && ! this.isDead()) {

            return new Grass(index);
        }

        return new Empty(index);
    }

    /**
     * 草を表す記号を返却します。
     * @return 草を表す記号。
     */
    @Override
    public String toString() {

        return "W";
    }
}
図19のGrassクラスにおいて、繁殖成功率を表すREPRODUCTIVE_RATEフィールドはstatic修飾子が付いた静的メンバーですが、さらに final修飾子 が付けられていることがわかると思います。
変数定義においてfinal修飾子は、その変数が値の再代入できないものであることを表します。つまり、final修飾子が付いた変数は初期化しかできません。
従って、static finalが付いたフィールドは定数(Constants) と呼ばれます。プログラム上で変更することがない0や1以外の決まりきった値、例えば、成功率や寿命などは定数として定義することが一般的です。
繁殖シミュレーション/空間クラス
空間クラスの設計
次に、空間をどのように実現するか、を考えましょう。要件から、図20のように空間はセルが並べられた1次元の列で左端と右端が繋がっている必要があります。
セルの列は、配列やリスト構造を使えば実現できます。
セルの列では、列の長さを動的に変更する必要が特に無いので、配列が良さそうです。 配列には、先に考えた生物オブジェクトをそのまま格納すればよいでしょう。
前述した、Emptyオブジェクトが空の状態を表しますから、配列の各要素は基本的にEmptyオブジェクトで初期化されているとすれば素直な割り当て方となります。
左端と右端が繋がっている構造は、例えば配列aであれば、図21のように、a[-1]のときa[a.length-1](逆にa[a.length]のときならばa[0])となるように、配列の長さによる剰余を求めることで、インデックス値の修正を参照するたびにしてあげれば良いでしょう。この修正インデックスは図22に示す方法で計算できます。
if (インデックスが正の値であれば) {

    return インデックス値 % 空間サイズ;

} else {
    // インデックス値が負のとき、負の剰余は例えば-4 % 3 = -1となります
    return (空間サイズ + インデックス値 % 空間サイズ) % 空間サイズ;
}
よって、これら機能を満たす空間クラスを作れば良さそうです。ここで、1つの空間オブジェクトが1ヶ月ごとの空間を表現するとすれば、より自然な定義になります。
これまで考察してきた空間について必要最低限の振る舞いを抽出すると、以下になります。
- インデックス値を周期的インデックス値に補正する。
- 空間に生物を配置する。
- 空間から生物を取得する。
- 1ヶ月後の空間を計算する。
- 空間の状態を表示する。
ここで、空間の概念が抽象的かどうかについて議論する必要があります。
明らかに空間は抽象的な概念ですが、今回のようにたとえば2次元の空間に拡張する予定がない場合、無理に抽象化する必要はありません。
\({\Huge``}\) 柔軟で複雑な設計というものは、ほとんどの場合、 必要とされないことが多いのです 。
\(\hspace{1pc}\) As for the flexible, complex design, most of the time you aren't going to need it .\({\Huge,\hspace{-0.4em},}\)
------ Martin Fowler, リファクタリング: プログラミングの体質改善テクニック. p.68[15]
抽象化を推し進めた結果、出来上がった柔軟すぎるプログラムは過度に複雑化し、保守が難しくなります。過度な機能(ここでは抽象化)は必要とされないことが多いのです。必要な機能と判断されるまでなるべく機能を持たせない(抽象化しない)、なるべくシンプルに設計するというスローガンはYou Aren't Going to Need Itの頭文字から取って YAGNI と呼ばれます。
以上の検討から、ひとまず空間の振る舞いは全て具象メソッドとし、空間クラスOneDimensionalSpaceを図23のように定義します。
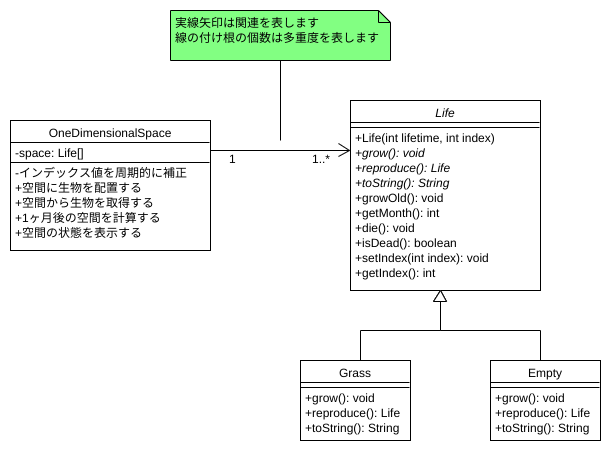
クラス図のフィールドは実装として書き下す時、図24のルールに則って記述します。
アクセシビリティ記号 フィールド名: フィールドの型
なお、図23のクラス図中にある実線矢印は 関連(Association) を表します。関連とは、クラス間にクラスやオブジェクトの参照関係がある場合、結ぶことができます。矢印の方向は、その方向にのみ関連がある場合に引かれます。このような関係を knows-a 関係と呼びます。
線の付け根に割り当てられている数字は、オブジェクト間の関連の数(いくつ参照・保持しているか)で、多重度(Cardinarity) を表します。具体的な数値以外にも、0..*(0以上)、1..5(1以上5以下)のように任意の範囲を指定できます。図22においては、OneDimensionalSpaceオブジェクト1つにつき、1以上の Life オブジェクトが関連していることを表します。
冒頭で空間を表すセルの列を生物クラスの配列として表すことに決めたと思います。つまり、OneDimensionalSpaceクラスは、 Life オブジェクトを配列でまとめて持つわけです。
このように、独立して存在できるオブジェクトをリストや配列などでまとめて保持することを 集約(Aggregation) と呼びます。また、このような関係を has-a 関係と呼びます。
OneDimensionalSpaceクラスと Life クラスの関係をより的確に示すのであれば、knows-a関係と言うよりはhas-a関係となるはずです。したがって、図25のように集約としてクラス図で表したほうが良いです。
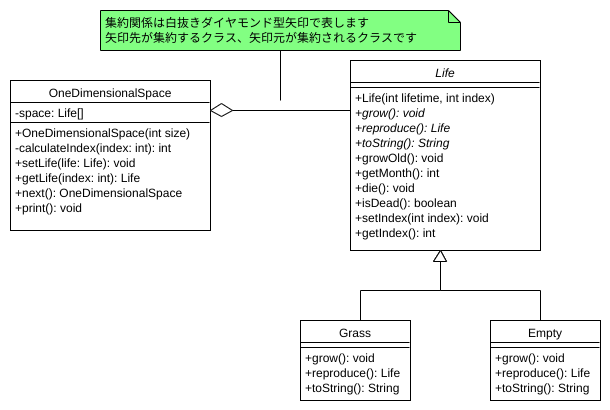
クラス図において集約は白抜きダイヤモンド矢印で表されます。例えば、図25では、OneDimensionalSpaceオブジェクトは Life オブジェクトを集約している(Life オブジェクトはOneDimensionalSpaceオブジェクトの一部である)、ことを表しています。
ここで図25で示しているように、空間の必要最低限の振る舞いを以下のメソッドに割り当てています。
- インデックス値を周期的インデックス値に補正する。
calculateIndexメソッド
- 空間に生物を配置する。
setLifeメソッド
- 空間から生物を取得する。
getLifeメソッド
- 1ヶ月後の空間を計算する。
nextメソッド
- 空間の状態を表示する。
printメソッド
1ヶ月後の空間の計算
ここまで、空間クラスの振る舞いを具体的に抽出して、OneDimensionalSpaceクラスとしてメソッドのシグネチャやデータ構造までは設計できました。次に、OneDimensionalSpaceオブジェクトが1ヶ月後の空間をnextメソッドでどのように計算すればよいか考えてみましょう。
まず、1ヶ月後の空間を作るためには、各セルの状態を全て同時に計算しなければなりません。なぜならば、各セルに居るであろう生物は、自分の1ヶ月後の状態を、現在の自分の状態および両隣のセル(にいる生物)の状態を元に決定します。
仮に、順に生物の状態を計算していくと、図26に示すように、1ヶ月後を計算済みの生物を元に、1ヶ月後を計算してしまう生物が現れてしまいます。これでは、正確な1ヶ月後の空間の計算ができません。
では、どのように各セルの状態を全て同時に計算させるべきでしょうか。OneDimensionalSpaceクラスのspaceフィールドに対して計算結果を反映させながら同時に計算することは、先の問題によってできません。
しかし、1ヶ月後の状態を保持する新たな空間としてOneDimensionalSpaceオブジェクトを別に作成しておき、その空間オブジェクトに対して、図27のように現在の状態を元に計算した1ヶ月後の状態を順に割り当てていくことはできます。
全生物オブジェクトの1ヶ月後の状態を別途用意した空間オブジェクトに割り当てることができれば、図10におけるフローチャート中の次のオブジェクトの状態を計算したことになり、1ヶ月後の空間オブジェクトを現在の空間オブジェクトに置き換えることでオブジェクトに計算結果を反映したことになります。
次に、各生物の1ヶ月後の状態をどのように決定するか、を考えなければなりません。冒頭の繁殖シミュレーションの要件のうち、次の3項目が状態決定に関係します。
- 生物は設定された寿命になると死滅する。
- 生物が死滅した場合、空間から取り除かれる。
- 生物は1ヶ月ごとに隣接するセルに対して繁殖を行う。
草クラスの状態更新
現時点では草クラスGrassと空の状態クラスEmptyのみ、具体的な生物クラスとして図19と図18のように実装しています。まずGrassオブジェクトを元に上記要件をどのように満たしていくべきか考えましょう。
生物は設定された寿命になると死滅する。
前述した草であるGrassクラスの振る舞いを検討した際に、growメソッドを実装しました。growメソッドは、成長を表していて、年齢(月齢)をインクリメントします(1ヶ月だけ年齢を加算します)。growメソッドによって事前に設定されている寿命を年齢が超えると、死んでいるかどうか判定するisDeadメソッドの結果がtrueを返すようになります。
したがって、オブジェクトごとの状態計算をするたびに1回growメソッドを呼び出して1ヶ月成長させればよいです。
生物が死滅した場合、空間から取り除かれる。
次に、isDeadメソッドを使って、成長させたオブジェクトが死んでいるかどうか判定します。isDeadメソッドの結果に応じて、次状態の空間に対して成長させた生物オブジェクトを割り当てるか割り当てないかを判断すれば良いです。
オブジェクトが死んでいれば、空の状態を表すEmptyオブジェクトを新たに作成し、次状態の空間として別に用意したOneDimensionalSpaceオブジェクトの同じ位置に割り当てます。逆に死んでいなければ、成長させたオブジェクトを代わりに割り当てればよいです。
生物は1ヶ月ごとに隣接するセルに対して繁殖を行う。
Grassクラスでは、同様にreproduceメソッドを実装しました。繁殖成功率に基づいて、新たなGrassオブジェクトか、Emptyオブジェクトを返却します。
よって、オブジェクトが生きている時に、現在の空間と次状態の空間において隣接するセルが空であれば、次状態の空間オブジェクトの対応する隣接セルにreproduceメソッドの結果を割り当てればよいです。
ここで、セルが空であることをどのように判断するかというと、Emptyオブジェクトが割り当てられていれば空、それ以外のオブジェクトが割り当てられていれば非空であるとわかります。
Javaでは、クラスがある上位クラスを継承または実装しているかどうか判定する演算子instanceofがあります。例えば、a instanceof Bは、変数aに割り当てられているオブジェクトがクラスBを継承または実装しているのならば、trueを返却し、そうでなければ、falseを返却します。図28に利用例を示します。
instanceof演算子を活用することで、あるオブジェクトがEmptyクラスかどうか判断できます。
public void check(Life a) {

	if (a instanceof Empty) {

		System.out.println("オブジェクトは空の状態です。");
	}
}
空(から)状態のクラスの状態更新
次に、図18のEmptyオブジェクトが上記要件をどのように満たしていくべきか考えなければなりません。
生物は設定された寿命になると死滅する。
空の状態は不変です。死滅することはありません。Emptyクラスで実装したgrowメソッドは何もしません。
したがって、Grassオブジェクトと同様に、状態計算のたびに実装させれているgrowメソッドを呼び出したとしても問題ありません。
生物が死滅した場合、空間から取り除かれる。
Emptyクラスの検討において、空の状態は死んでいる状態と仮定しました。つまり、isDeadメソッドは常にtrueを返却します。
したがって、Grassオブジェクトの時と同じで死んだ状態のセルには、空の状態を表すEmptyオブジェクトを新たに作成して、次状態の空間オブジェクトに割り当てるだけで良いです。
ただ、他の具体的な生物オブジェクトが隣接していた場合、そのオブジェクトの繁殖によって次状態の空間にすでに新個体が割り当てられている可能性があります。よって、次状態の空間が空の状態であることを確認した上で、空であれば自身を割り当て直す、空でなければなにもしない、とすればよいです。
生物は1ヶ月ごとに隣接するセルに対して繁殖を行う。
空の状態はダミー生物のようなものです。繁殖できません。Emptyクラスで実装したreproduceメソッドは、自身を返却します。
Emptyオブジェクトは常に死んだ状態です。つまり、Grassオブジェクトのように生きている状態に繁殖するといった、生きている状態の処理を考慮する必要がありません。ですから、特に何もしなくて良いです。
上記で考察した2つの生物クラスにおける振る舞いを統合すると、図29のフローチャートになります。
空間クラスの実装
それでは、これまでの検討から、空間クラスOneDimensionalSpaceの振る舞いを以下にまとめます。
calculateIndexメソッド(インデックス値を周期的インデックス値に補正する)- 図22のアルゴリズムに則って、与えられたインデックス値を補正し、その値を返却する。
setLifeメソッド(空間に生物を配置する)- フィールドの配列
spaceに対して、引数として与えられたインデックス値が指し示す位置に、引数として割り当てられた生物オブジェクトを割り当てる。- 引数で与えられたインデックス値は、
calculateIndexメソッドによって補正後返却された値を利用する。
- 引数で与えられたインデックス値は、
- フィールドの配列
getLifeメソッド(空間から生物を取得する)- フィールドの配列
spaceにおいて、引数として与えられたインデックス値が指し示す位置にある生物オブジェクトを返却する。- 引数で与えられたインデックス値は、
calculateIndexメソッドによって補正後返却された値を利用する。
- 引数で与えられたインデックス値は、
- フィールドの配列
nextメソッド(1ヶ月後の空間を計算する)- 新しい空間オブジェクトを作成して1ヶ月後の空間オブジェクトとし、図28のフローに則って、その空間オブジェクトを更新し、更新した空間オブジェクトを返却する。
- フィールドの配列
spaceに割り当てられている全ての生物オブジェクトを、getLifeメソッドを使ってインデックスを先頭から順に変更しながら取得し、1ヶ月後の空間オブジェクトの同一インデックス値の位置に、更新した生物オブジェクトをsetLifeメソッドを使って割り当てる。
- フィールドの配列
- 新しい空間オブジェクトを作成して1ヶ月後の空間オブジェクトとし、図28のフローに則って、その空間オブジェクトを更新し、更新した空間オブジェクトを返却する。
printメソッド(空間の状態を表示する)- フィールドの配列
spaceの要素を1つづつ取り出し、全て標準出力する。
- フィールドの配列
また、補足すべき振る舞いとして、以下が挙げられます。
- コンストラクタで、空間のセル列の長さを設定する。
- 引数で与えられた長さの
Lifeクラスの配列を作り、全てのインデックスをEmptyオブジェクトで初期化する。
- 引数で与えられた長さの
以上を踏まえると、空間クラスは、図30のように実装できます。
/**
 * 生物が存在する1次元空間です。
 * @author Me
 */
public class OneDimensionalSpace {

    /**
     * 空間構造の元となる配列です。
     */
    private Life[] space;

    /**
     * 1次元空間を作ります。
     * @param size 整数で表される1次元空間の大きさ。
     */
    public OneDimensionalSpace(int size) {

        this.space = new Life[size];

        // 空間をEmptyオブジェクトで初期化する。
        for (int i = 0; i < size; i = i + 1) {

            this.space[i] = new Empty(i);
        }
    }

    /**
     * 環状の1次元空間を表すためのインデックスを計算します。
     * @param x 補正前のインデックス。
     * @return 環状になるように補正したインデックス。
     */
    private int calculateIndex(int x) {

        if (x >= 0) {

            return x % this.space.length;

        } else {

            return (this.space.length + x % this.space.length) % this.space.length;
        }
    }

    /**
     * 生物を空間に配置します。
     * @param life 配置する生物。
     */
    public void setLife(Life life) {

        int index = life.getIndex();

        // 指定されたインデックスを環状に補正します。
        int fixi = this.calculateIndex(index);

        this.space[fixi] = life;
    }

    /**
     * 指定された空間インデックスに配置された生物を取得します。
     * @param i 空間インデックス。
     * @return 空間インデックスに割り当てられている生物オブジェクト。
     */
    public Life getLife(int i) {

        return this.space[this.calculateIndex(i)];
    }

    /**
     * 1ステップ後の空間を計算します。1ステップは1ヶ月として換算します。
     * @return 求められた1ステップ後の空間オブジェクト。
     */
    public OneDimensionalSpace next() {

        // 新たな空間オブジェクトを作成します。
        OneDimensionalSpace nextSpace = new OneDimensionalSpace(this.space.length);

        // 現在の空間にいる生物の状態から次の状態を決定するために、全ての空間インデックスについて見ていきます。
        for(int i = 0; i < this.space.length; i = i + 1) {

            // 生物オブジェクトを取得します。
            Life center = this.getLife(i);
            // 1ヶ月生物オブジェクトを成長させます。
            center.grow();

            int leftIndex = i - 1;
            int rightIndex = i + 1;

            Life left = this.getLife(leftIndex);
            Life right = this.getLife(rightIndex);

            // 次の空間オブジェクトのこの植物オブジェクトが居るインデックスが空のとき
            if (nextSpace.getLife(i) instanceof Empty) {
                // 生殖フェーズ
                if (center.isDead()) {
                    // 生物オブジェクトが死んでいた場合。

                    // 次の空間では空(から)の状態にします。
                    nextSpace.setLife(new Empty(i));

                } else {
                    // 生物オブジェクトが生きていた場合。

                    nextSpace.setLife(center);

                    Life leftNext = nextSpace.getLife(leftIndex);
                    Life rightNext = nextSpace.getLife(rightIndex);

                    if (left instanceof Empty && leftNext instanceof Empty) {
                        // 現在の空間インデックスの左側の生物オブジェクトを繁殖させます。
                        Life leftNew = center.reproduce();

                        // 生物オブジェクトに左側のインデックスを設定します。
                        leftNew.setIndex(leftIndex);

                        // 空間に生物オブジェクトを配置します。
                        nextSpace.setLife(leftNew);
                    }

                    if (right instanceof Empty && rightNext instanceof Empty) {
                        // 現在の空間インデックスの右側の生物オブジェクトを繁殖させます。
                        Life rightNew = center.reproduce();

                        // 生物オブジェクトに右側のインデックスを設定します。
                        rightNew.setIndex(rightIndex);

                        // 空間に生物オブジェクトを配置します。
                        nextSpace.setLife(rightNew);
                    }
                }
            }
        }
        return nextSpace;
    }

    /**
     * 空間の中身を表示します。
     */
    public void print() {

        for (int i = 0; i < this.space.length; i = i + 1) {

            System.out.print(this.space[i].toString());
        }
        System.out.println();
    }
}
シミュレーションの実装
図10のシミュレーションのフローを元に、OneDimensionalSpaceクラスと具体的な種クラスGrassを使って、シミュレーションを実装してみましょう。
図31に実装したmainメソッドの例を示します。
この例では、セル列の長さが50である空間を仮定し、インデックス0に草オブジェクトを初期配置して、4年間分48ヶ月の各月ごとの空間の様子を表示させます。
public static void main(String[] args) {

    // 初期空間を生成します。
    int size = 50;

    OneDimensionalSpace space = new OneDimensionalSpace(size);

    // 草をインデックス0に配置します。
    space.setLife(new Grass(0));
    // 初期空間を表示します。
    space.print();

    // 12ヶ月 * 4 = 4年間
    int iteratedMonth = 12*4;

    // シミュレーションを行います。
    for (int i = 0; i < iteratedMonth; i = i + 1) {

        // 次の世代の空間を計算します。
        space = space.next();
        // 作成した世代の空間を表示します。
        space.print();
    }
}
[15]: M. Fowler, ``リファクタリング: プログラミングの体質改善テクニック'', ピアソン・エデュケーション社 (2000)
実験課題4
Exercise 4(課題4) Show the execution result of the simulation program with new Mustard class and its complete source code. In this simulation, Mustard supposes to satisfy following constraints:
- the reproductive rate is 52 percent,
- the string symbol is
*, - the other properties are same to
Grassclass.
Follow instruction below to modify the simulation program.
- create new class named
Mustardclass in the projectSimulation01by inheritingLifeclass. - modify
Mustardclass to fit above constraints. - modify
mainmethod to locateMustardobject with index 25 in initial space. - modify
mainmethod to change simulation periods to 20 years (240th months) - take a screenshot of the execution result.
(課題3のプロジェクトSimulation01に対して、Life クラスを継承して、以下の要件を満たした菜の花を表すMustardクラスを作成し、作成したMustardオブジェクトを初期空間のインデックス25に配置させて、20年間シミュレーションさせなさい。その後、Mustardクラスとmainメソッドのソースコードと実行結果のスクリーンショットを報告しなさい。
- 繁殖成功率は52%とする。
- 菜の花を表す文字列は
*とする。 - それ以外の振る舞いは、
Grassクラスと同じである。)
実験課題5
Exercise 5(課題5) See the section 5.5.1. "Interface" and the section 5.5.2 "Propagation simulation: Abstraction". Show the execution result of the modified project Simulation01 to correspond with Figure 44 by using classes from Figure 39 and complete GenerationPrinter class. Following instruction below to create the program.
- add interface
Space,Printerby right-clicking the project and selecting新規 > Javaインタフェース...in the right-click menu.- Right click on the target project.
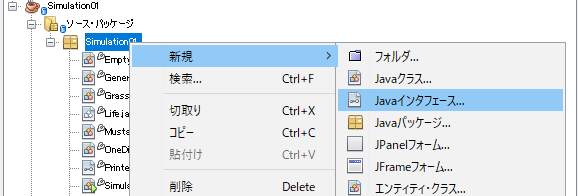
Figure:Right click menu for adding Interface in project pane - Complete in
New Javaインタフェースdialog and click終了(F).
Figure:Specify Interface parameters in ``New Javaインタフェース'' dialog
- Right click on the target project.
- add class
GenerationPrinterby the same way. - modify the source code to run this program.
- take a screenshot of the execution result.
(5.5.1.節と5.5.2.節をよく読み、課題4の変更を加えたプロジェクトSimulation01に対して、mainメソッドを図50の定義に書き換え、図44の実行結果となるように図39から記載されているクラス・インタフェースを追加・変更して、プログラムを作成しなさい。ここでクラスの継承・実装関係はクラス図である図47に従いなさい。なお、図49に示すGenerationPrinterクラスは不完全のため、各自中略部分を改良すること。その後、GenerationPrinterのソースコードを報告しなさい。また実行結果もスクリーンショットで報告しなさい。なお、インタフェースの追加方法は以下の手順に則ること。
ここでは、インタフェースSpaceを追加する際の手順例を示す。
- プロジェクトペインから新たに追加するプロジェクトを選択して、右クリックする。
- 右クリックメニューの
新規 > Javaインタフェース...を選択する。 New Javaインタフェースダイアログで、クラス名をSpace、パッケージ名をSimulation01として、終了を選択する。- パッケージ
Simulation01にあるSpace.javaを開いてエディタペインに表示させ、図39のプログラムを適宜変更および追加する。
)
インタフェース
この節の要点
- 実装を一切持たない抽象クラスをインターフェースと呼ぶ。
- Javaでは複数の概念を親として継承させたいとき、各概念をインタフェースとして定義することで多重継承することができる。
ある概念の上位の概念は独立して複数存在することが一般的です。
例えば、「イルカ」の上位概念は、「哺乳類」や「海洋生物」などが、「高専寮生」の上位概念は、「寮生」や「高専生」などがあります。
複数の概念を継承することを多重継承(multiple inheritance) と呼びます。多重継承は、パフォーマンスの問題やひし形継承問題を引き起こします。これら問題を避けるために、Javaでは継承の仕組みにおいて複数の概念(スーパークラス)を元に下位の概念(サブクラス)を作ることはできません。しかしながら、インターフェース(Interface) と呼ばれる抽象クラス構造を使うことで、(インターフェース間の)多重継承を実現できます。
インターフェースは 抽象メソッドのみ からなる純粋な抽象クラス構造です。すなわち、純化した抽象概念と見なすことができます。つまり抽象クラスと同様に、インターフェース自身からオブジェクトを作成することはできません。また、インターフェースは抽象クラスとは異なり、インスタンスフィールドや具体的な振る舞い(実装)を含めることはできません。
インターフェースを駆使することで、オブジェクト指向プログラミングにおいて再利用性および保守性を高めつつ階層化したプログラムを作成することができます。
インターフェースを元に新たにクラスを作成することを実装(Implementation) と呼びます。図32、図33、図34にインターフェースの実装例を示します。
/**
 * 高専生です。
 */
public interface KosenStudent {
	/**
	 * IDを取得します。
	 * @return IDです。
	 */
	public String getID();
}
/**
 * 寮生です。
 */
public interface Ryousei {
	/**
	 * 在寮しているか判定します。
	 * @param date 日付です。
	 * @return 材料していればtrue、していなければfalse。
	 */
	public boolean isStayed(DateTime date);
}
/**
 * R02年度の津山高専寮生です。
 */
public class TsuyamaR02 implements Ryousei, KosenStudent  {

	/**
	 * 名前と番号を設定します。
	 * @param name 名前です。
	 * @param num 番号です。
	 */
	public TsuyamaR02(String name, int num) {
		/* 中略 */
	}

	@Override
	public boolean isStayed(DateTime date) {
		/* 中略 */
	}

	@Override
	public String getID() {
		/* 中略 */
	}
}
図34における、実装の指定を抽出すると図35になります。Javaではimplementsキーワードを使うことで実装インタフェースを指定できます。
public class TsuyamaR02 implements Ryousei, KosenStudent {
インターフェースにおいては、abstract修飾子を記述する必要はなく、定義されたメソッドは全てabstractになります。また、インタフェースの実装クラスはそのインタフェース型に代入互換性があります。つまり、クラスの継承関係と同様に、インタフェースを実装したクラスオブジェクトは、その実装したインタフェース型の変数に代入することができます。従って、同様に多態性を実現することができます。
インタフェースをクラス図で表す際は、図35のように、名称の上部に<<interface>>を付ける必要があります。また実装関係を表すために、白抜き三角矢印の破線を使います。

繁殖シミュレーション/抽象化
この節の要点
- インタフェースや抽象メソッドなど(完全に)抽象的な振る舞いや概念は、クラスや抽象でないメソッドなど具体的な振る舞いや概念に依存すべきではなく、具体的な振る舞いや概念が抽象的な振る舞いや概念に依存すべきであるクラスの設計方針を依存性の逆転原則と呼ぶ。
- オブジェクト思考プログラミングにおいて、抽象化と多態性を駆使することで保守性・再利用性が高まるプログラム設計が可能となる。
ここからは、インタフェースをどのように利用していくか、引き続き、生物の繁殖シミュレーションプログラムを拡張していきながら見てきましょう。
抽象化と多態性を活用した制御構造の分離
実は、ここまでのプログラムにおいて、問題点が1つあります。
それは、具体的な生物クラスを新たに作るたびに、OneDimensionalSpaceクラスのnextメソッドに、条件分岐などを追加して種の1ヶ月後の状態計算の処理を追加していかなければならない、という点です。
現時点では、具体的な生物クラスが2種類のみなので、問題がなさそうに感じるかも知れませんが、数十種類になってくると話が変わります。nextメソッドは肥大化し、さらにOneDimensionalSpaceクラスと具体的な生物種クラスとの結合度が高まって、保守性・再利用性が著しく低下します(図37)。
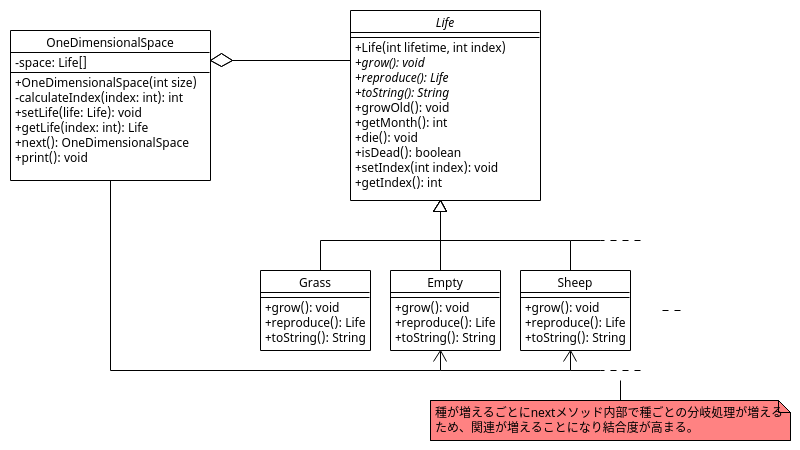
この状況は、状態計算の処理がうまく抽象化されずOneDimentionalSpaceクラスの振る舞いとして定義されているため起こっていることです。従って、各生物ごとの1ヶ月後の状態を計算する振る舞いをOneDimentionalSpaceクラスから各生物クラスに分離して追加しましょう。各生物クラスに次の抽象的な振る舞いを検討します。
strategyメソッド(1ヶ月後の状態を計算する)- 現在の自身の状態と空間の状態から、次の1ヶ月後の状態を計算し、空間に生物オブジェクトを割り当てる。
明らかに、1ヶ月後の状態を計算する振る舞いでは、現在の空間オブジェクトと、1ヶ月後の空間オブジェクトを参照できなければなりません。従って、OneDimensionalSpaceオブジェクトを渡す必要があるわけですが、これは抽象メソッドstrategyが、具体的なクラスであるOneDimensionalSpaceクラスに依存することになります。
よいプログラムの設計において、 抽象的な振る舞いや概念が具象的な概念・実装に依存すべきではありません 。この原則を 依存性の逆転原則(Dependency Inversion Principle) [14]と呼びます。
依存(Dependency) とは、クラス間で、一方のクラスのフィールド・メソッドが他方のクラス実装で利用されている関係を指します。このような関係を uses-a 関係と呼びます。
例えば、OneDimensionalSpaceクラスはsetLifeメソッドを持ちますが、setLifeメソッドは引数で他クラスである Life クラスを利用しています。このとき、OneDimensionalSpaceクラスは Life クラスに依存している、と言えます。
これは具体的な概念・実装は、再利用や保守を行う際に、既に述べた通り、プログラムの変更の影響を直接受けることが大きく関わっています。 この影響は抽象化・多態性を用いることで、分離することができます。しかしながら、抽象クラスや抽象メソッドと言ったプログラム構造の内部が具象クラスに依存していた場合、その具象クラス変更の影響が波及します。したがってなるべく抽象クラスは具象クラスには依存しないほうが良いのです。
それではどのようにすべきかというと、インタフェースを使って、空間クラスを抽象化します。そして、抽象化したインタフェースに抽象メソッドstrategyが依存するようにしましょう。
空間と呼ばれる概念は抽象度が高いため、抽象的な振る舞い以外の具体的な振る舞いを定義しにくいです。よって、抽象クラスよりもインタフェースを使った抽象化をすべきです。空間インタフェースSpaceを考えてみましょう。
空間の抽象的な振る舞いを抽出すると以下になります。
- 空間に生物を配置する。
- 空間の座標から生物を取得する。
ここまでの議論をまとめると、図38の関係を示すことができます。
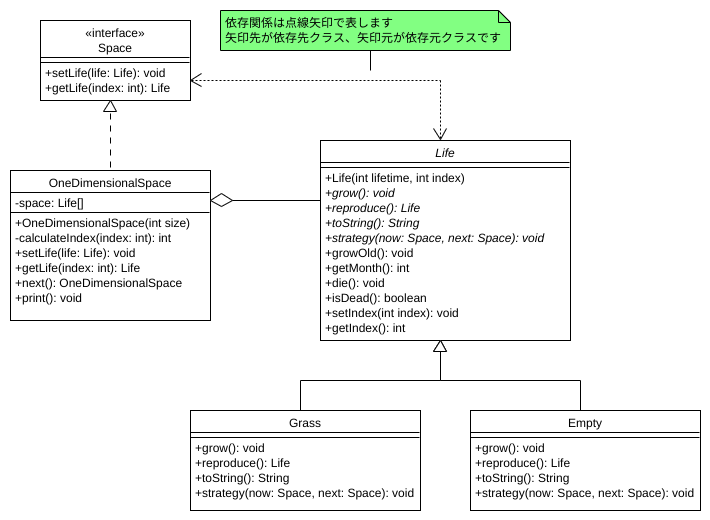
図38における点線矢印が依存関係を表しています。ここでは、インタフェースSpaceと 抽象クラス Life が相互に依存することが解ると思います。
以上を踏まえて、図39のようなSpaceインタフェースを定義してみましょう。
/**
 * 空間を表します。
 * @author Me
 */
public interface Space {

    /**
     * 生物を空間に配置します。
     * @param life 配置する生物。
     */
    public void setLife(Life life);

    /**
     * 指定された空間インデックスに配置された生物を取得します。
     * @param i 空間インデックス。
     * @return 空間インデックスに割り当てられている生物オブジェクト。
     */
    public Life getLife(int i);
}
既に、図30で示したOneDimensionalSpaceクラスには同じシグネチャのsetLifeメソッドとgetLifeメソッドが存在するため、新たに追加でこれらを実装する必要はなく、実装先インタフェースを指定するだけで良いです。
さて、肝心の生物クラスが持つstrategyメソッドですが、図38、図39で定義したSpaceインタフェースを利用して、図40のように定義できます。
/**
 * 繁殖戦略を行います。これまでの空間に配置された生物を元に、自身が次の世代の空間を生み出します。
 * @param now 今の空間。
 * @param next 次の空間。
 */
public abstract void strategy(Space now, Space next);
strategyメソッドの引数は2つのSpaceインタフェースが指定されており、依存性の逆転原則が満たされていることがわかります。このstrategyメソッドを生物クラス Life に追加します。
抽象クラス Life に抽象メソッドstrategyを追加すると、そのサブクラスであるGrassクラス(そしてMustardクラス)とEmptyクラスにおいて、strategyメソッドを実装しなければなりません。
ですが、この実装内容は、過去にこれらクラスの振る舞いの処理フローを図29のように統合したことからもわかるように、OneDimensionalSpaceクラスにて実装したnextメソッドの処理内容から分離すればよいだけです。
Grassクラスのstrategyメソッドに分離した処理を図41に、Emptyクラスへ分離した処理を図42に示します。
/**
 * 繁殖戦略を行います。これまでの空間に配置された生物を元に、自身が次の世代の空間を生み出します。自身が死亡状態であれば、空間から取り除きます。自身の左側、あるいは右側が空の状態であれば、reproduceメソッドに基づいて新たに植物を生み出します。
 * @param now 現在の空間。
 * @param next 次の空間。
 */
@Override
public void strategy(Space now, Space next) {

    int spaceIndex = this.getIndex();
    int leftIndex = spaceIndex - 1;
    int rightIndex = spaceIndex + 1;

    // 生物オブジェクトを取得します。
    Life center = now.getLife(spaceIndex);
    Life left = now.getLife(leftIndex);
    Life right = now.getLife(rightIndex);

    // 次の空間オブジェクトのこの植物オブジェクトが居るインデックスが空のとき
    if (next.getLife(spaceIndex) instanceof Empty) {
        // 生殖フェーズ
        if (center.isDead()) {
            // 生物オブジェクトが死んでいた場合。

            // 次の空間では空(から)の状態にします。
            next.setLife(new Empty(spaceIndex));

        } else {
            // 生物オブジェクトが生きていた場合。

            next.setLife(center);

            Life leftNext = next.getLife(leftIndex);
            Life rightNext = next.getLife(rightIndex);

            if (left instanceof Empty && leftNext instanceof Empty) {
                // 現在の空間インデックスの左側の生物オブジェクトを繁殖させます。
                Life leftNew = this.reproduce();
                leftNew.setIndex(leftIndex);

                next.setLife(leftNew);
            }

            if (right instanceof Empty && rightNext instanceof Empty) {
                // 現在の空間インデックスの右側の生物オブジェクトを繁殖させます。
                Life rightNew = this.reproduce();
                rightNew.setIndex(rightIndex);

                next.setLife(rightNew);
            }
        }
    }
}
/**
 * 繁殖戦略を行います。これまでの空間に配置された生物を元に、自身が次の世代の空間を生み出します。
 * @param now 現在の空間。
 * @param next 次の空間。
 */
@Override
public void strategy(Space now, Space next) {

    int spaceIndex = this.getIndex();

    if (next.getLife(spaceIndex) instanceof Empty) {

        next.setLife(this);
    }
}
さて、ここまでOneDimensionalSpaceクラスの今後の肥大化を防ぐためにnextメソッドを分離してきましたが、nextメソッド自体はどのように書き換えるか、感の良いひとならばもうわかったかも知れません。
答えは、各セルに対する繰り返し文でstrategyメソッドを呼び出すように直すだけです。図43にその修正例を示します。
/**
 * 1ステップ後の空間を計算します。1ステップは1ヶ月として換算します。
 * @return 求められた1ステップ後の空間オブジェクト。
 */
public OneDimensionalSpace next() {

    // 新たな空間オブジェクトを作成します。
    OneDimensionalSpace nextSpace = new OneDimensionalSpace(this.space.length);

    // 現在の空間にいる生物の状態から次の状態を決定するために、全ての空間インデックスについて見ていきます。
    for(int i = 0; i < this.space.length; i = i + 1) {

        Life target = this.getLife(i);

        // 生物オブジェクトを1ヶ月分成長させます。
        target.grow();
        // 今の空間の状態を元に、繁殖戦略を行って、次の空間の状態を決めます。
        target.strategy(this, nextSpace);

    }

    return nextSpace;
}
図30のnextメソッドと図43を見比べると、個別の処理が分離され、抽象化された処理のみの記述となり明らかに見やすくなったと思います。ここで、図43の16行目と18行目にて、多態性の効力が発揮されている、と言えるでしょう。オブジェクト指向プログラミングにおいて、このような抽象化と多態性を組み合わせた設計が保守性・再利用性を増加させることが感覚としてわかったでしょうか。
今後、具体的な生物種についての1ヶ月後の状態を計算する処理は、その種のstrategyメソッドに記述することになります。
インタフェースを駆使した役割の追加
前節にて、多態性を駆使した抽象化を行いましたが、最後に、表示機能を拡張してみましょう。現状では、空間オブジェクトのセルの状態が標準出力に表示されるだけです。ここに、図44のように各空間オブジェクトの世代を表示できるようにしてみましょう。
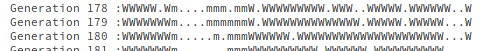
ここでのポイントは、既存のクラスをあまり改変することなく拡張していくために、インタフェースを使う点です。
さて、そもそも今回のシミュレーションプログラムでは、図10のフローチャートで示されている通り、オブジェクトの次状態の計算と反映、そして表示が、繰り返し処理上で実施されています。
しかし、一般的に表示処理は時間がかかるため、繰り返し処理上ではオブジェクトの記録だけにとどめておき、図44のようにシミュレーション処理終了後などにまとめて表示が行われることが多いです。従って、ここではこれまでのシミュレーションプログラムを図45のフローに則って改変してみましょう。
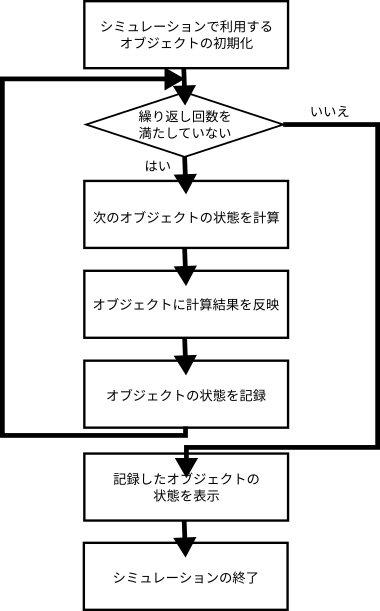
図45における、オブジェクトの記録をどのように行うか、というと、そもそもこれまで作成してきたシミュレーションプログラムではループの繰り返しごとに空間オブジェクトを新たに作成していますから、作成したオブジェクトをオブジェクト記録用として別途用意したリスト構造にループごとに追加していくだけで、他に影響なく記録できます。
そして、シミュレーションの繰り返しが終わった後に、リスト構造を繰り返しループで走査して、追加されている空間オブジェクトを1つづつ順に表示していけば、図45のフローが実現できます。
さて、表示機能は、様々な概念が兼ねる可能性がある機能です。よって、「表示ができる」概念を定義して抽象化したいと思います。この概念は抽象度が高いので具体的な振る舞いを定義することが難しいです。
よってまず、以下の振る舞いを持つPrinterインタフェースを定義します。
- 自身を表示する(
printメソッド)。- 標準出力に何らかの形でオブジェクトを表示させる。
表示機能を持たせたいクラスにPrinterインタフェースを実装しましょう。世代を表示する機能も同様にPrinterインタフェースを実装することで実現させます。ここではクラス名をGenerationPrinterとしましょう。既に表示機能を持っている空間クラスOneDimensionalSpaceについても同様で、抽象化できるように拡張しておきます。
先に述べたように、Printerインタフェースを実装したクラスのオブジェクトは、代入互換性があるPrinter型として扱うことができますから、ArrayListなどのによるPrinter型のリストオブジェクトに区別することなく追加できます。図46のようにこのリストオブジェクトの中身を先頭から1つづつ順に参照し、自身を表示するprintメソッドを実行すれば、順序立ってまとめて表示できるはずです。
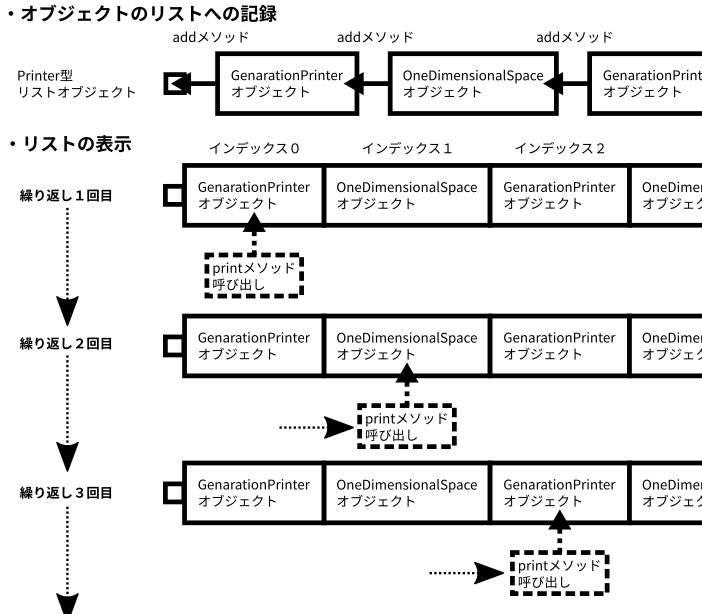
ここまでの検討を全てまとめたクラス図を図47に示します。
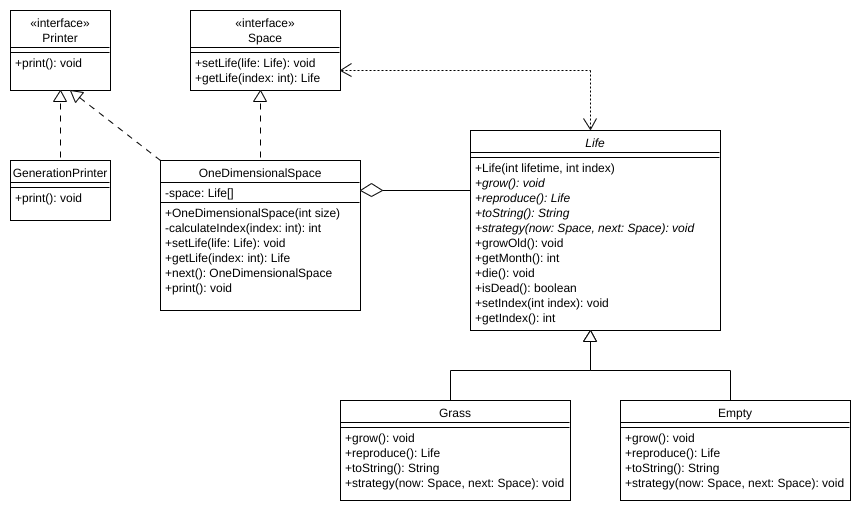
以上を踏まえて、図48にPrinterインタフェースの定義例を示します。
/**
 * 表示することができる対象を表します。
 * @author Me
 */
public interface Printer {

    /**
     * 表示します。
     */
    public void print();
}
図47のとおりOneDimensionalSpaceクラスとGenerationPrinterクラスにPrinterインタフェースを実装しましょう。
ここで既に、図30で示したOneDimensionalSpaceクラスには同じシグネチャのprintメソッドが存在するため、新たに追加でこれらを実装する必要はなく、実装先インタフェースを指定するだけで良いです。
最後に世代を表示させるクラスGenerationPrinterの実装例を図49に示します。
/**
 * 世代表示です。
 * @author Me
 */
public class GenerationPrinter implements Printer {

    /**
     * 世代を表します。
     */
    private int gen;

    /**
     * 世代を設定します。
     * @param gen 世代。
     */
    public GenerationPrinter(int gen) {
        /* 中略 */
    }

    /**
     * 世代を表示します。
     */
    @Override
    public void print() {
        /* 中略 */
    }
}
あとは、これまで定義したインタフェース・クラスを駆使して図45に則ったフローにmainメソッドをなおしてあげれば良いだけです。
改良したフローのmainメソッドの例を図50に示します。
public static void main(String[] args) {

    // 初期空間を生成します。
    int size = 50;

    OneDimensionalSpace space = new OneDimensionalSpace(size);

    // 草をインデックス0に配置します。
    space.setLife(new Grass(0));
    // 菜の花をインデックス3に配置します。
    space.setLife(new Mustard(3));

    // 12ヶ月 * 20 = 20年
    int iteratedMonth = 12*20;

    // 表示リストを初期化します。
    ArrayList<Printer> plist = new ArrayList<Printer>();

    // 世代を表示するオブジェクトを表示リストに追加します。
    plist.add(new GenerationPrinter(0));
    // 初期空間を表示リストに追加します。
    plist.add(space);

    // シミュレーションを行います。
    for (int i = 0; i < iteratedMonth; i = i + 1) {

        // 次の世代の空間を計算します。
        space = space.next();

        // 世代表示を表示リストに追加します。
        plist.add(new GenerationPrinter(i+1));
        // 空間を表示リストに追加します。
        plist.add(space);
    }

    // シミュレーション結果を表示します。
    for (Printer p : plist) {

        p.print();
    }
}
[14]: A. Shalloway, and J.R. Trott, ``- デザインパターンとともに学ぶ - オブジェクト指向のこころ'', 丸善出版 (2014)
実験課題6
Exercise 6(課題6) See the section 5.6.1. "Creation of the Class Diagram". Show the class diagram of User in Figure 18, Student in Figure 32 of the section 4, and Teacher in Figure 3 of the section 5.
(5.6.1.節をよく読み、第4節図18に示すUserクラスと第4節図32のStudentクラス、第5節図3に示すTeacherクラスを含めた関係性を表すクラス図を作成して報告しなさい。)
クラス図の作成
第3節までに説明してきた構造化プログラミングにおける方法論は構造化設計(Structured Design) と呼ばれます。
これに対して、クラス構造を使ったオブジェクト指向プログラミングにおける方法論は、数多く存在しますが、総じてオブジェクト指向設計(Object Oriented Design) と呼ばれます。
グラディ・ブーチが1980年代にこの呼称を初めて使ったと言われており、ブーチはオブジェクト指向設計における多くの方法論の確立に関わっていました。 その内の1つに、クラス図(Class Diagram) があります[14]。クラス図は、統一モデリング言語(Unified Modeling Language: UML) と呼ばれるオブジェクト指向モデリング言語に含まれる、階層化されたクラス間の関係性を表現するための手法です。
クラス図を使うことで、クラス構造を階層的にかつ視覚的にわかりやすく記述することができ、設計に役立てることができます。
UMLを使ったプログラムのモデリングは、紙と鉛筆があれば可能ですが、デジタルデータとして永続化するために一般的にモデリングツールを使って行われることが多いです。UMLモデリングツールは、astah*、Graphviz、PlantUMLなどのエディタソフトウェア、GenMyModelや、draw.ioなどオンラインサービス、それぞれの形態で数多く存在します。
今回は、無料かつアカウント登録不要であるUMLetinoと呼ばれる、オンラインUMLモデリングサービスを使ったクラス図の作成方法を以下に示します。
UMLetinoにアクセスすると、図51の画面が表示されます。画面の左端ペインがメニューバー、中央の領域がクラス要素の配置編集画面、右端上側ペインがクラス要素のリスト、そして右端下側ペインが要素編集エディタです。
今回は、Userクラスを元に作成手順を示してみましょう。Userクラスは、第4週の図18を参考にします。
クラス要素を追加するためには、図52のようにクラス要素のリストから追加したい要素を選択し、ダブルクリックしてください。図53のように、配置編集画面に選択した要素が追加されます。
クラス要素は、配置編集画面にてドラッグすることで位置を編集できます。また、クラス要素のふちにマウスカーソルを合わせてドラッグすると、要素のサイズを変更できます。
もし、追加した要素を削除したい場合は、配置編集画面にて削除したいクラス要素を右クリックするとメニューが表示されるのでDeleteを選択してください。あるいは、クラス要素を選択した状態で、Backspaceキーを押してください。
クラス要素の表示内容を変更するためには、配置編集画面にて編集したいクラス要素を選択すると、図54のように要素編集エディタにクラス要素の設定テキストが表示されます。
初期値であるSimpleClassクラスをUserクラスに変更してみましょう。これまでクラス図の読み方を説明してきましたが、図11のように3つの区画から構成されます。
これら3つの区画は図55のように、-ハイフンにて区切ることで表現できます。クラス名、フィールド、そしてメソッドはハイフンで区切られた行に上から順に記述することで表現できます。
図55にUserクラスの、クラス名、フィールド、そしてメソッドを定義する場合の設定テキストを示します。
図55の設定テキストを編集すると、その結果が図56のように配置編集画面に反映されます。
また、継承(実線白抜き三角矢印)や関連(実線矢印)を表すためには、これまでと同じように、クラス要素のリストから該当する線を選択した状態で、ダブルクリックしてください。
すると、配置編集画面に配置されるので、ドラッグして編集してください。
作成したクラス図は、編集データ(XMLファイル)や画像データ(PNGファイル)としてダウンロードすることができます。図57のように、メニューのなかからFile Exportをクリックしてください。
図58のように保存ダイアログが表示されます。
図58の保存ダイアログにて、テキストボックスにファイル名を設定して、Save Image Fileをクリックしてください。PNGファイルのダウンロードが始まります。
[14]: A. Shalloway, and J.R. Trott, ``- デザインパターンとともに学ぶ - オブジェクト指向のこころ'', 丸善出版 (2014)
レポート課題
Homework 1(調査課題1) Survey why Java do not permit sub-class belonging to multiple super-classes.
(Javaでは親クラスが複数ある子クラスを作ることができない。その理由を 掘り下げて 調査しなさい。)
プロファイリング
プログラムの性能を示す尺度として、プログラムが実行されてから終了するまでに経過した時間である実行時間や、プログラムが動作時にデータを保持するために利用するコンピュータのメモリ領域の総計であるメモリ消費量などが代表的な指標としてあります。これら指標を計測することをプロファイリング(Profiling) と呼びます。
統合開発環境には、このような指標を収集しプログラムの性能を可視化してくれる性能解析ツール(プロファイラ: Profiler)が含まれています。NetBeansも例外ではなく、NetBeansプロファイラを無償で利用することができます。
NetBeansプロファイラの機能は無償であるため限定的ですが、次の機能を使うことができます。
- CPUパフォーマンスの解析
- メモリ使用状況の解析
この節では、性能解析(Profiling)を行って、プログラム処理中で最も足かせとなっている箇所(ボトルネック)の特定することと、改善の仕方について触れてきます。
NetBeansプロファイラについて
この節の要点
- プロファイラを起動するためにはツールバーのデバッグアイコンの右隣にある時計アイコン🕛をクリックする。
- 性能測定は
プロファイリングの構成と開始タブの左上にあるプルダウンメニューセッションの構成をクリックして選択する。- CPU使用率やメモリ使用量を時系列で測定するためには、プルダウンメニュー
セッションの構成ボタンから遠隔測定を選択し、プロファイルボタンを選択する。
NetBeansにおいて、プロファイラを起動するためには、プロジェクトペインでプロファイリングしたいプロジェクトを選択した状態(図1)で、メニューバーからプロファイル(P) > プロジェクト(..)をプロファイル(P)を選択するか、ツールバーのデバッグアイコンの右隣にある時計アイコン🕛(図2)を押すことで、エディタペインにプロファイリングの構成と開始タブ(図3)を開くことができます。
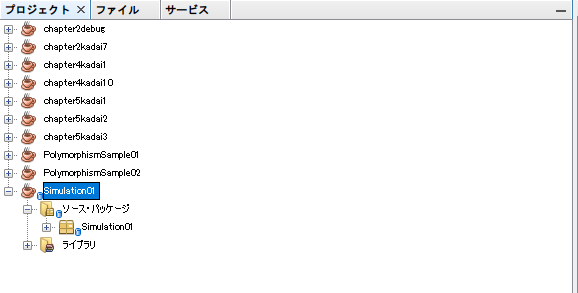
プロファイリングの構成と開始タブの左上にあるセッションの構成をクリックすると、プロファイルのプルダウンメニュー(図4)を開くことができます。
時系列測定
セッションの構成のプルダウンメニューから遠隔測定を選択すると、CPU時間やメモリーの消費量(ヒープサイズ)などの時系列測定をすることができる遠隔測定タブ(図5)を開くことができます。
この測定では、CPU使用率やメモリ使用率のピーク値が大体いくらかぐらいになるか、推し量るために利用されることが多いです。
測定を開始するためには、遠隔測定タブの左上にある緑三角のプロファイルボタン(図6)を選択します。
第5週の課題5のプログラムをプロファイリングしてみた例を図7に示します。
図7においては、この測定結果においては、CPUのピークが18.5%であることがわかります。
実験課題1
Exercise 1(課題1) See the section 6.1. "About Profiler in NetBeans" and 6.2.1. "Analysis of CPU Performance". Show which one of two programs as described below are slower and explain why the program is slow. Follow instructions below to show the result.
- create the Java application project named
chapter6kadai1. - create
mainand each sort method as described below in the main class in the project. - take snapshots in the profiler by switching each sort method in
mainmethod.- If the profiler does not show the dialog of Figure 11, must increase
sizeparameter more than 10000 described in the 5th line of each below main method.
- If the profiler does not show the dialog of Figure 11, must increase
- show difference of execution time by comparing snapshots.
public static void sortA(double[] l) {

    for (int j = 0; j < l.length; j = j + 1) {

        for (int i = 0; i < l.length - j - 1; i = i + 1) {

            if (l[i] > l[i+1]) {

                double d = l[i];
                l[i] = l[i+1];
                l[i+1] = d;
            }
        }
    }
}

public static void sortB(Double[] l) {

    for (int j = 0; j < l.length; j = j + 1) {

        for (int i = 0; i < l.length - j - 1; i = i + 1) {

            if (l[i] > l[i+1]) {

                Double d = l[i];
                l[i] = l[i+1];
                l[i+1] = d;
            }
        }
    }
}
public static void main(String[] args) {

    Random rng = new Random();

    int size = 10000;

    double[] rdl = new double[size];

    for (int i = 0; i < size ; i++) {

        rdl[i] = rng.nextDouble() * size;
    }

    sortA(rdl);
}
public static void main(String[] args) {

    Random rng = new Random();

    int size = 10000;

    Double[] vdl = new Double[size];

    for (int i = 0; i < size ; i++) {

        vdl[i] = rng.nextDouble() * size;
    }

    sortB(vdl);
}
(6.1.節および6.2.1.節をよく読み、chapter6kadai1プロジェクトを作成し、chapter6kadai1クラスに以下に示すアルゴリズムが同一のsortAクラスメソッド、sortBクラスメソッドを追加しなさい。その後、mainメソッドをプロファイラ実行のたびに使い分けることで、それぞれのスナップショットを作成し、どちらのプログラムの方が遅いか、差分表示にて図21のように示しなさい。また、なぜそのプログラムが遅いのか考察しなさい。 なお、図11のようにスナップショットを取得するかどうかのダイアログが表示されない場合は、mainメソッドの5行目のsizeの値を増やして表示されるように調整して、課題を実施してください。 )
CPUパフォーマンスの解析
この節の要点
- 各メソッドにどの程度CPU時間が費やされているか測定するためには、プルダウンメニュー
セッションの構成からメソッドを選択し、プロファイルボタンを選択する。- 1回分の測定結果はスナップショットとよばれる記録として保存できる。
- スナップショットを比較する際、合計時間にプラスの符号が付いているメソッドは、開いているプロファイルの同名メソッドと比較して比較するスナップショットのプロファイルが遅い、逆にマイナスの符号が付いているメソッドは速いことを意味する。
先に述べたプロファイリングの構成と開始タブのセッションの構成プルダウンメニューからメソッドを選択すると、各メソッドが処理に費やした時間とその割合を可視化するCPUパフォーマンスの解析ができるメソッドタブ(図8)を開くことができます。
ここから、第5週の課題5のプログラムを元にプロファイリングしてみたいと思います。課題5のプログラムは、図10のシミュレーションフローを改変して、図44のシミュレーションフローで構成したと思います。この改変にどの程度影響があるか見てみましょう。
解析を開始する前に、サンプリングするメソッドの範囲を指定したほうが結果が見やすくなります。右上端にある設定ボタンを選択すると、図9のようにプロファイルプルダウンリストが表示されます。ここからプロジェクトのクラスを選びます。
その後、メソッドタブの左上にある緑三角のプロファイルボタンを選択すると、メソッドプロファイラが起動します。プログラムの実行が終わると、図10のようにダイアログボックスが立ち上がって、測定が完了します。
ここで、図10のダイアログが立ち上がった場合は、実行時間が短すぎてスナップショットを作成するには不十分である場合です。プロファイラがスナップショット(比較可能な測定結果)を作成できません。
課題5の場合は、シミュレーションの試行回数が不足しています。初期設定が20年間のシミュレーションでしたから、80年間のシミュレーションに直してみましょう。すると図11のような結果になると思います。
プログラムを改変した前後の性能を比較するためには、1回分の測定結果であるスナップショットとよばれる記録を取ると便利です。
図11にスナップショットが作成できる程度に実行時間が確保できた場合の、プロファイリング完了時のスクリーンショットを示します。ここでは、スナップショットの比較を行いたいので、ダイアログボックスが表示された場合は、ひとまずはいを選択してください。
すると、図12のように、プロファイリング実行時刻が割り当てられたスナップショットが未保存の状態で開かれます。
スナップショットでは、プログラム中で頻出したあるいは計算時間が比較的全体の割合に対して大きいメソッドに関して、処理にかかった時間が記録されています。図12ではmainメソッドの処理時間のみしか、表示されていませんが、ツリービュー表示ができるので、クリックすると図13のように更なる内訳を表示してくれます。
ここで、セルフタイムと呼ばれる項目がありますが、この項目は、それ以外に表示されたメソッドの処理時間を差し引いた、メソッドの実行時間になります。
具体的に図13のスナップショットを読み解くと、mainメソッドは、2種類のprintメソッド(全体に対する割合65.1%+33.5%)と、nextメソッド(全体に対する割合1.4%)の処理時間が大部分を占めており、それ以外の処理にmainメソッドが費やした時間すなわちセルフタイムは非常に小さい(全体に対する割合0%)ことがわかります。さらに、2種類のprintメソッド内の処理の内訳を見ると図14のようになっていました。
これらを見る限り、第5週で言及したように、他の処理よりも表示処理(標準出力)に時間がかかってしまうことが改めて解ると思います。
このスナップショットをより具体的に比較するために保存します。図15のように左上にある保存アイコンをクリックしてください。
すると、図16のスナップショットペインに保存したスナップショットが表示されます。
図16のスナップショットペインはメニューバーのウィンドウ(W) > プロファイル(G) > スナップショット(S)を選択することで表示できます。
スナップショットが時刻名だと判別が困難になるので、図17のように変更したいスナップショットを右クリックして、右クリックメニューを開き名前の変更...を選択して、名前を変更しましょう。
ここでは、スナップショット名を「図44のシミュレーションフロー」としました。次に、mainメソッドの内部を第5週の図10のフローになるように変更後、図8から図17までの手順を同様に踏んでスナップショットを作成します。なおこのスナップショット名は「図10のシミュレーションフロー」としました。
ここまで手順を踏まえると、スナップショットペインが図18になるはずです。
ここで、スナップショットペインで「図44のシミュレーションフロー」をダブルクリックしてスナップショットを表示させます。そして図19のように、スナップショットの表示画面の上部ツールバーに他のスナップショットと比較...ボタンがあるので、これを選びます。
すると、図20のように比較するスナップショットを選択ダイアログがたちあがるので、プロジェクトから(P)のラジオボタンが選択されていることを確認し、「図10のシミュレーションフロー」を選択した状態で、OKを選択します。
その結果、図14のような割合表示ではなく、図21のような差分表示がなされます。
ここまでの手順を踏むことで、第5週の図44のシミュレーションフローに対して、第5週の図10のシミュレーションフローの各メソッドがどの程度速度差を持つか、表示することになります。
図21にて、合計時間に、プラスの符号が付いているメソッドは開いているプロファイルに対して 比較するスナップショットのプロファイル が その秒数だけ遅い ことを示しており、マイナスの符号が付いているメソッドは逆に その秒数だけ速い ことを示しています。
具体的にいえば、図21においては、OneDimensionalSpace.printメソッドは+312ms、mainメソッドについては+643ms、なので図10のシミュレーションフローの方が遅い、ことを表しています。
実験課題2
Exercise 2(課題2) See the section 6.3.1. "Analysis of Memory Usage". Show the memory-leaking method in the program as described below as a screenshot and a reason. Follow instructions below to show the memory leak.
- create the Java application project named
chapter6kadai. - create
PPAPGeneratorclass andmainmethod as below. - run the profiler with
Objectmode and the profiling target toAll classes.- If the profiler does not show the dialog of Figure 29, must increase
sizeparameter more than 100000 described in the 9th line of PPAPGenerator class program.
- If the profiler does not show the dialog of Figure 29, must increase
- check the memory-leaking class object except
byte[]class according to the huge number of live objects. - specify its class object by using
profiling classin right-clicked menu. - re-run the profiler with it.
- check the memory-leaking method according to the larger number of
Generationabout live objects.
/**
 * PPAPの歌詞をランダムに作成します。
 * @author Me
 */
public class PPAPGenerator {

    private String[] words = {"I", "have", "a", "an", "Ah", "pie", "pen", "pineapple", "apple"};

    private ArrayList<String> randomList = new ArrayList<String>();

    private Random rng;

    private int startIndex;

    private int endIndex;

    public PPAPGenerator() {

        this.rng = new Random();
        this.startIndex = 0;

        this.endIndex = 0;
    }

    public void generate() {

        int wordnum = this.rng.nextInt(this.words.length);

        this.randomList.add(this.words[wordnum] + " ");

        this.endIndex++;
    }

    public void print() {

        while (this.startIndex != this.endIndex) {

            System.out.print(this.randomList.get(this.startIndex));

            this.startIndex++;
        }
        System.out.println();
    }

}
public static void main(String[] args) {

    // 9単語からランダムに文字列を作成するオブジェクトです。
    PPAPGenerator ppap = new PPAPGenerator();

    Random rng = new Random();

    // 10万回個の単語を出力します。
    int size = 100000;

    for (int i = 0; i < size; i = i + 1) {

        // 90%の確率で文字列を作成します。
        while(rng.nextDouble()<0.9) {
            // 呼び出すたびに文字列に単語を1つ追加します。
            ppap.generate();
        }

        // 文字列を表示します。
        ppap.print();
    }
}
(6.3.1.節をよく読み、プロジェクトchapter6kadai2を作成し、以下に示すPPAPGeneratorクラスとmainメソッドを実装しなさい。その後、プロファイリングを行って、メモリリークしていそうなライブオブジェクトを選定し、さらに「選択したクラスに限定したプロファイリング」を実施して、世代数から最も怪しいメソッドをプロファイリング結果のスクリーンショットを用いて示しなさい。なお、図28のプロファイル設定においては、プロジェクトのクラスを選択するのではなく、すべてのクラスを選択した状態で行いなさい。ここで、byte[]クラスを選択したクラスの対象としないように注意すること。なお、図29のようにスナップショットを取得するかどうかのダイアログが表示されない場合は、mainメソッドの9行目のsizeの値を増やして表示されるように調整して、課題を実施しなさい。)
メモリ使用状況の解析
この節の要点
- プログラム内で使われているオブジェクトが消費しているメモリ量について、全体でどのようなクラスオブジェクトが消費しているのかあるいは特定のクラスオブジェクトがどのメソッドでよく利用されているか測定するためには、プルダウンメニュー
セッションの構成からオブジェクトを選択し、プロファイルボタンを選択する。- Javaでは、プログラム実行時にユーザの動作に応じて適宜作成した動的なデータ(参照型)が不要になった際にメモリ上から除去する操作をガーベジコレクションと呼ばれる言語機能が自動で行われる形で実現している。
- 特定のオブジェクトが消費されているメソッドを測定するためには、プログラム全体のクラスオブジェクトの消費量を測定した後、測定結果のクラスオブジェクト一覧から希望するクラスオブジェクトを選択して右クリックメニューの
プロファイル・クラスを選ぶことで実施できる。- 特定のオブジェクトが消費されているメソッドを測定した結果における世代数とは、そのオブジェクトがメモリ上に残っている間に行われたガーベジコレクションの回数を表す。
- メモリリークとは除去する必要があるデータが除去されずにメモリ上に残り続ける現象のことであり、世代数が大きければ大きいほどメモリリークしている可能性が高いといえる。
プログラムにおいて、なんらかの値を変数に割り当てたり、プログラムを実行するために必要な情報を保存したりする際に、メモリ上の空間を利用します。 このようにしてメモリ上に割り当てられた値は、基本的に、スコープ(変数の参照可能・有効範囲)から外れたときにメモリから取り除かれます。しかし、これは値型に限った話で、参照型はこの限りではありません。
C言語の場合を思い出してみましょう。
図22に示すプログラムは、引数で渡された2つの値を加算する関数sumの利用例です。関数sumは、加算した結果の値をメモリ上のアドレスで返却します。このプログラムの実行結果を図23に示します。図23を見て分かるようにこのプログラムは実行時にエラーを出力します。
#include<stdio.h>

int* sum (int a, int b) {

	int c = a + b;	// 変数cにaとbを加算したデータを割り当てる

	printf("*関数sumの中にて\n")
	printf("メモリアドレス: %p\n", &c);
	printf("割り当てられたデータ: %d\n", c);
	return &c;      // 変数cに割り当てられたデータのメモリ上のアドレスを返却
}

int main (void) {

	int* x = sum(1, 2);

	printf("\n*関数sumの外にて\n")
	printf("メモリアドレス: %p\n", x);
	printf("割り当てられたデータ: %d\n", *x); // Segmentation faultエラー
}
*関数sumの中にて
メモリアドレス: 0x7fff2a6ecb6c
割り当てられたデータ: 3

*関数sumの外にて
メモリアドレス: (nil)
Segmentation fault (core dumped)
図の関数sumは、内部で定義された変数cに割り当てられた値のメモリ上のアドレスを返却します。変数cのスコープは定義した直後から、ブロック・あるいは関数から脱出するまでです。従って、関数sumを脱出した後、変数cに割り当てられたデータは取り除かれるため関数sumの外で呼び出すことはできず、図の実行結果の様に19行目でSegmentation faultエラー(データを取り出そうとしたアドレスが不正)となります。
ですが、次の図のプログラムを見てください。このプログラムは図22のプログラムと処理内容についてはほぼ同じものです。しかし、関数sumで変数cがデータそのものでなくint型のデータ領域のアドレスを保持している(ポインタである)点が異なります。図24のプログラムは、図25の実行結果を見れば分かるように、Segmentation Faultが起こることなく、プログラムが実行できています。
#include<stdio.h>
#include<stdlib.h>

int* sum (int a, int b) {

	// メモリ上にint領域を確保しそのメモリアドレスを変数cに割り当てる
	int* c = (int*)malloc(sizeof(int));
	*c = a + b; // 変数cのアドレスが指し示す領域にa+bの結果を割り当て

	printf("*関数sumの中にて\n")
	printf("メモリアドレス: %p\n", c);
	printf("割り当てられたデータ: %d\n", *c);
	return c; // 変数cに割り当てられたデータのメモリ上のアドレスを返却
}

int main (void) {

	int* x = sum(1, 2);
	printf("\n*関数sumの外にて\n")
	printf("メモリアドレス: %p\n", x);
	printf("割り当てられたデータ: %d\n", *x);
}
*関数sumの中にて
メモリアドレス: 0x2324010
割り当てられたデータ: 3

*関数sumの外にて
メモリアドレス: 0x2324010
割り当てられたデータ: 3
図24のプログラムにおいて、関数sumにて関数mallocを使って変数cに割り当てられた領域は、プログラムが実行された時の初期化処理で最初に確保しておくメモリ領域ではなく、動的に確保される(プログラムが実行時に決定する)任意の大きさのメモリ領域になります。
この関数mallocを使って確保されたメモリ領域はプログラムが終了するか、プログラム中で意図されたメモリ領域を解放する命令を実行するまで、メモリから取り除かれることがありません。
従って、図のプログラムにおける関数sumは実行すればするほど、追加でメモリ領域を確保していくことになり、プログラムが実行中に利用しているメモリ領域はどんどん大きくなります。
メモリ領域は、OSが管理している共有リソース領域であり、OSが同じく動作管理をしている他の複数のプログラムも利用しています。よって、なるべく他のプログラムの実行の妨げにならないようにプログラムで利用するメモリ領域の利用は適宜抑えておく必要があります。
ですから、基本的に利用したメモリ領域のうち、その後利用することがないものについては、先に述べたメモリ領域を解放する命令を意図して実行しなければなりません。図26に利用したメモリ領域を解放する命令を追加した関数mainの例を示します。C言語においては、関数freeが、渡されたアドレスが指し示すメモリ領域を解放する命令になります。
int main (void) {

	int* x = sum(1, 2);
	printf("\n*関数sumの外にて\n")
	printf("メモリアドレス: %p\n", x);
	printf("割り当てられたデータ: %d\n", *x);

	free(x); // xに関数mallocを使って割り当てられたメモリ領域を解放
}
図26に示すように、C言語では手動で動的に確保したメモリ領域は、適宜手動で解放するようプログラムを組む必要があるわけです。 単純なプログラムであれば、そこまで難しい話ではないですが、プログラムの規模が大きくなっていくと、こうしたしなければならない解放処理の記述が膨大な量になってしまい煩雑になってきます。 そうなってくると、メモリの解放し忘れ(メモリリーク)や、二重で解放処理を行ったり(メモリ領域に意図しない修正を加えてしまうバグにつながる[1])、といったミスが出ないとも限りません。
Javaは、このような解放処理をガーベジコレクション(Garbage Collection) と呼ばれる自動化された言語機能として持ちます。 ガーベジコレクションは自動的に不必要と判断したメモリ領域を開放するため、プログラマはメモリの解放処理を意識することなくプログラムを記述することができます。
Javaにおいては、new演算子がC言語のmallocの役割を含み、C言語のポインタ型に相当する型が参照型になります。すなわち、オブジェクトは動的に確保されたメモリ領域にあるデータであり、オブジェクトを作れば作るほどメモリ領域を消費していくことになるわけです。
これらオブジェクトを自動的に解放するために、ガーベジコレクションは、メモリが不足していたり、何も処理していなかったりする時に、実行されます。
具体的には、プログラムが実行された時、(内部的な)初期化処理で利用されるメモリ領域にあるオブジェクトを順に見ていきます。 ここで、オブジェクトは内部で別のオブジェクトを必ず参照しているはずです。また、その別のオブジェクトも更に別のオブジェクトを参照しています。プログラムが現時点で利用しているオブジェクトは、参照関係が木構造のように繋がっています。この木構造から漏れたオブジェクトを全てメモリから解放することで、不必要なメモリ消費をなくすというわけです。
Javaのプログラムを作る際には、ガーベジコレクションがあるため、先に述べた通り、メモリ領域を開放することをあまり意識せずに、オブジェクトを組み合わせて処理を構築できてしまいます。これは逆に言えば、本来、解放すべきメモリ領域を無駄に保持してしまう(メモリリークしてしまう)オブジェクトが作れてしまうことを意味します。メモリ領域を無駄に消費するプログラムが容易に作れてしまうのです。
プロファイラには、プログラムがどの程度メモリを消費しているか可視化することができる機能があります。この機能を使うことで、メモリリークがどこで発生するのかある程度判断することができ、メモリ消費量を抑えるプログラムを作ることに繋げることができます。
先に述べたプロファイリングの構成と開始タブのセッションの構成プルダウンメニューからオブジェクトを選択すると、プログラムが利用しているオブジェクト数・メモリ消費量などメモリ使用状況の解析ができるオブジェクトタブ(図27)を開くことができます。
ここから、CPUパフォーマンスの解析の節と同様に、第5週の課題5のプログラムを元にプロファイリングしてみたいと思います。第5週の図10のシミュレーションフローと、図44のシミュレーションフローのメモリ利用の差を見てみましょう。
解析を開始する前に、サンプリングするメソッドの範囲を指定したほうが結果が見やすくなります。右上端にある設定ボタンを選択すると、図27のようにプロファイルプルダウンリストが表示されます。ここからプロジェクトのクラスを選びます。
解析を開始するためには、メソッドタブのときと同様に、オブジェクトタブの左上にある緑三角のプロファイルボタンを選択します。プロファイリングが完了した際の実行結果例を図28に示します。
CPUパフォーマンスの解析の節と同様に差分を求めることができ、同様の手順で図30のような結果を求めることができます。
図29の結果と図30の誤差を見る限り、図30においては第5週の図44のシミュレーションフローの方が軽量である傾向が出ています。ですが、第5週のシミュレーションプログラムでは、乱数を使ったオブジェクトの生成方法を行っているため、メモリ使用率が一定ではありません。従って、厳密に比較することがが難しいですが、試行回数を増やして平均を取ることである程度見積もることができます。よって、メモリにおいては、シミュレーションフローの差があまり現れないと言えます。
メモリの使用状況をプロファイリングすることで、メモリリークを見つける(推定する)試みをここで行ってみましょう。
ポイントとして、ライブ・オブジェクト数の割合が大きいものに注目することが重要です。
ここで、ライブ・オブジェクトとは、プログラムによって必要とされているオブジェクトのことです。例えば、図29においては、Emptyオブジェクトのライブオブジェクト数が90%で過半数を超えているため、疑う余地があります。
Netbeanプロファイラでは、クラスを指定してライブオブジェクトを更に追跡することができます。図31のように、スナップショットで絞りたい項目を右クリックして、プロファイル・クラスを選択してください。ここではEmptyオブジェクトを選択した状態で右クリックメニューのプロファイル・クラスを選択したと仮定して話を進めます。
すると、プロファイルプルダウンリストにて、選択したクラスが選ばれた状態になり、図32のように表示されます。ここではライブオブジェクトのトラッキングのチェックボックスにチェックを入れてください。
図32の状態で、再度緑三角のプロファイルボタンを押して、プロファイリングをしてみてください。図33に示すEmptyオブジェクトの内部のスナップショットを得ることができます。
図33を見ると、新たに、割り当てオブジェクト数および世代数の項目が増えていることが解ると思います。ここで注目してほしいのが 世代数 です。この数値は、そのオブジェクトがメモリ上に割り当てられている間にガーベジコレクションが行われた回数を示します。従って、世代数はオブジェクトが長期に渡って生存しつづけることで上昇します。今回のEmptyオブジェクトについては、世代数が1であり、他のオブジェクトと比較しても飛び抜けた数的な違いがないため、リークしてない、と判断できます。
ですが、たとえば、他のオブジェクトの世代数が1なのにも関わらず、あるオブジェクトだけ10ある、といった世代数の差は、メモリリークの兆候になります。
[1]: CWE - CWE-415: Double Free (4.2) (20/08/24 閲覧)
[2]: @IT:Java開発の問題解決を助ける(2) (20/08/24 閲覧)
レポート課題
Homework 1(調査課題1) Survey the problem about memory leak.
(メモリリークの問題点についてまとめ、Javaにおけるメモリリークの対策について調査しなさい。)