段階的作成法
この節の要点
- 段階的作成法は、プログラムで実現したいことを初めに文章として書き下し、分割できそうな処理に分け、プログラムの命令としてすべての分割した処理が置き換えることができるまで繰り返し行うトップダウンな手法である。
- 段階的作成法を行うことで、階層的なプログラムを作成できる。
- 分割した処理を作用と呼び、メソッドや関数などのモジュールや、具体的な命令が対応する。
ダイクストラは、段階的作成法について、数段に分けてプログラムを作成することであり、各段階で決定することをできるだけ少なくする 、との方針を述べています。この構成方法においては、アルゴリズムを用意されている命令に対応する 作用(action) で構成することになります。 段階的作成法を、次のプログラムを例に試みてみましょう。
- 小さい順に\(1000\)個の素数を画面に表示する。
素数は、\(1\)とそれ自体でしか割り切ることができない自然数です。上記作用1. は、少なくとも、プログラミング言語に用意された1命令に対応付けることはできません。そこで、作用1. を分離させることを考えましょう。最初の案として、以下のように分離してみましょう。
-
小さい順に\(1000\)個の素数を画面に表示する。
1.1. 小さい順に\(1000\)個の素数を求める。
1.2. 求めた素数を画面に表示する。
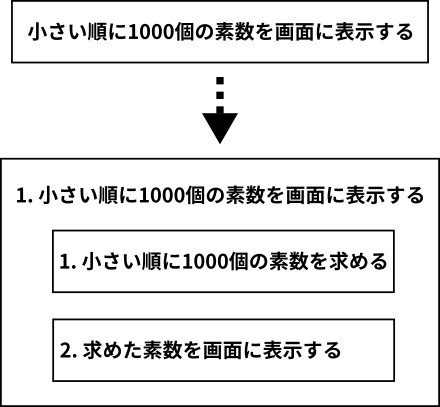
ここで注意すべきなのは、 分離させた作用同士は独立していなければならない 、ということです。少なくとも上記1.1. と1.2. の作用においては、素数の概念を変更することにはなりませんし、また、素数の内容によって、表示が別の操作に変わるというわけでもないから、独立していると言えます。
また、作用の分離にあたって、分離された作用は同じ状態空間を共有することになるので、どのように状態空間を利用するかを考えなければなりません。ここで状態空間とは、作用によってもたらされた結果を維持し、共有するための領域・構造などを指しています。例えば、1.1. と1.2. の作用において共有すべき情報は求めた素数です。つまり、作用の分離と共に、 共有すべき情報をどの範囲でどのようなデータ構造で受け渡すかを考えなければなりません 。
以上のことから、作用の分離に際して何らかの共有すべきデータ構造を定義しなければなりませんが、このデータ構造の決定を プログラムを作成する過程においていつすべきでしょうか 。これについては、少なくとも次の2案を考えることができます。
案1. 作用の詳細をなるべく決めてから、それに合ったデータ構造を決める。
案2. 作用の詳細を決める前に、思い切ってデータ構造を決める。
基本的に、上記の2案はどちらも表裏一体です。 案1. は分解する作用の詳細に依存していますし、これら作用を正しく見極められなかった場合、複雑なデータ構造になってしまいます。また 案2. は、決めたデータ構造に各作用が依存する形になるため、うまく決めることができなかった場合、プログラム自体が複雑になってしまいます。基本的に、作用(あるいはプログラム)とデータ構造、お互いを繰り返し修正する試行錯誤はなるべく少なく楽にすべきです。 ダイクストラは、思い切ってデータ構造から決めることを提案しています 。ここではその提案に則って、 案2. を採用しましょう。
1.1. と1.2. の間で受け渡す素数の集まりは、\(1000\)個で固定されています。だとすれば、ひとまずこの個数を拡張することを考えずに、長さ\(1000\)の配列構造を用意しておけば、受け渡すことができるはずです\(\dagger\)。また、それぞれの要素の型は、整数論の結果より\(1000\)個目の素数が符号付き32bit整数型の上限(2,147,483,647)に収まる事実から、長さ\(1000\)の整数型の配列を、作用1. の状態空間に予め用意しておけばひとまずよさそうです\(\ddagger\)。よって、上記作用 1.1. ~1.2. に対して、作用1.1. より前に新たに作用を追加することで、以下の 1.1'. ~1.3'. に変更できます(図7)。
-
小さい順に\(1000\)の素数を画面に表示する。
1.1'. 長さ\(1000\)の整数型の配列\(p\)を用意する。
1.2'. 小さい順に\(1000\)個の素数を配列\(p\)に順に格納する。
1.3'. 長さ\(1000\)の整数型の配列\(p\)を画面に表示する。
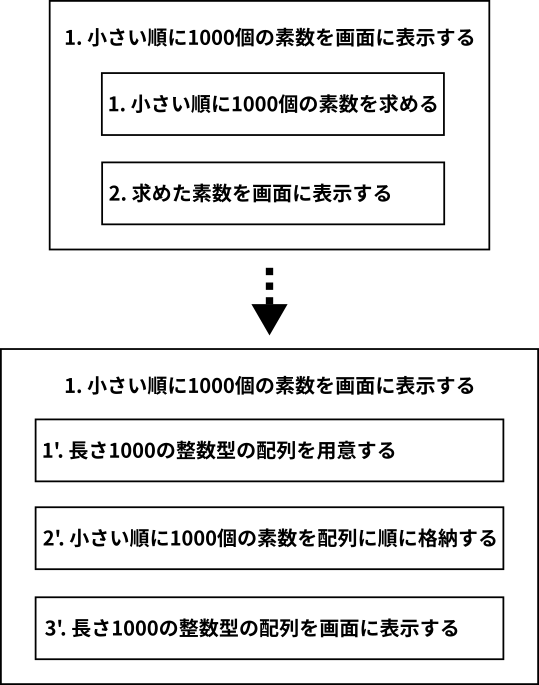
さて、ここで1.1'. には対応付けられる命令が存在します。それは、次の様に記述できます。
1.1'. 長さ\(1000\)の整数型の配列\(p\)を用意する(図8)。
int[] p = new int[1000];
また、1.3'. は配列\(p\)の中身を\(0\)から順に\(1000\)まで順に表示すれば良さそうです。これは素直に書き下すと図9の様に記述できます。
System.out.print(p[0] + " ");
System.out.print(p[1] + " ");
:
System.out.print(p[999] + " ");
図7をよく観察すると、大半の処理が共通しており、唯一、配列インデックスをずらしているところだけが違いです。基本的に、同じ処理がインデックスをずらして連続して行われる場合は、繰り返し構造を使って、洗練させることができます。
ここで、作用1. をプログラムとして記述する上で、プログラマは配列の長さが\(1000\)であることを知っているため、長さを改めて知る必要がないことに注意してください。 改めて、1.3'. は次のように記述できるはずです。
1.3'. 長さ\(1000\)の整数型の配列を画面に表示する(図10)。
for(int i = 0; i < 1000; i++) {

	System.out.print(p[i] + " ");
}
ここで、作用1. の処理において、作用1.2'. が最も核となることは容易に分かるはずです。ここからは、作用1.2'. を掘り下げていきます。
作用1.2'. を分離するにあたって、まず外形から考えていきましょう。先に述べたように、素数は\(1\)とそれ自身でしか割り切ることができない自然数です。素数を単に配列に保存するだけであれば、自明な案は作用1.2'. を次のように書くことです。
1.2'. 小さい順に\(1000\)個の素数を配列\(p\)に順に格納する(図11)。
p[0] = 2;
p[1] = 3;
:
p[999] = 7919;
しかし、この作用1.2'. では\(1000\)個の素数表を知っておく必要がありますし、なによりもプログラムを必要としないことを意味しています。このあまり現実的ではない処理を観察すると、我々は少なくとも小さい順に素数を知っていることが分かりますから、配列\(p\)を埋めるためには、インデックスを昇順に増やして埋めていけば良さそうです。
この処理をまとめると、作用1.2b.を改良した次の作用1.2'. を容易に思い浮かべることができるはずです。
1.2'. 小さい順に\(1000\)個の素数を配列\(p\)に順に格納する(図12)。
int x = 1, pcnt = 0;

while(pcnt < 1000) {

	x = xの次の素数を計算する;
	p[pcnt] = x;
	pcnt = pcnt + 1;
}
もちろん、このwhile文で記述された作用1.2'. は、for文でより洗練させることができることはすぐ分かりますね?
さて、ここで「\(x\)の次の素数を計算する」演算が存在するならばこのプログラムは完成ですが、ここでは無いと仮定します(一般的なプログラミング言語では無いでしょう)。すると、次の洗練段階で、\(x\)がどのように増やされるか表現しなければなりません。
ダイクストラは、手続き (本来は返り値のないメソッドの意味であるが、文脈的には返り値のあるメソッドでも良い)を駆使することで、全ての変数が全ての処理中に存在できる状態よりも、変数が存在できる範囲、すなわちスコープ を定義して適切に変数の存在範囲を制限することの方が、非常に有意義であると述べています。これは、 ある処理を実行するに当たって内部処理を理解せずとも利用できること( 抽象 (化))につながるため です。 つまり、 適宜作用ごとにメソッド化すべきである ことが理解できますね。したがって、「\(x\)の次の素数を計算する」作用をメソッド化しましょう。
作用1.2'.x. として次の様に書きます。
1.2'.x. \(x\)の次の素数を計算する(図13)。
static int nextPrime(int x) {

	int k = x + 1;

	while(! kが素数である) {

		k = k + 1;
	}
	return k;
}
引数\(x\)として与えられた値を素数となるまで増加させれば良いわけですから、繰り返し文を使えば良いはずですね。
次に、図11中の「\(k\)が素数である」作用を、次の作用1.2'.x.x. として再び洗練させましょう。
1.2'.x.x. \(k\)が素数である(図14)。
static boolean isPrime(int k) {

	/* 省略 */
}
この作用1.2'.x.x. を記述するためには既存の命令を組み合わせるだけで実現できるため、全ての作用をプログラムの命令と対応付けできたことによりプログラムは完成しました。
本来は、手続きの洗練をさらに繰り返し行うため、もう少し手順が増えますが、基本的な考え方はここまでで示した通りです。
なお、段階的に設計していくのは、手続きだけでなく、データ構造も段階的に洗練させていきます。従って、作用を分離していく各段階で、手続きまたはデータ構造のいずれか1つを洗練させていくことが段階的作成法の要点です。
ダイクストラは、手続き(メソッド)の呼び出しが入れ子となることを、手続きの呼び出し階層と手続き内部の階層と言った具合に、層状にプログラムを構成することにたとえました。こうした層状のプログラム構成は、上記の段階的作成法を用いることで、作ることができます。この層状のプログラム構成は、以下の利点などが挙げられるため、プログラム作成においては魅力的なやり方であるとダイクストラは述べています。
- 各層が分離(独立)しており、ある層に対する修整が他の層に影響を与えない
- 層を重ね合わせて目的のプログラムを作ることで同じ処理の共通化が進む(再利用性が上がる)
- よく分離された層に注目することでデバッグがしやすくなる
ここで、機能(作用)を分割していく設計方法(図15)を、プログラム設計におけるトップダウン方式 と呼びます[8]。一般的なトップダウン方式のメリットを以下に示します。

- 人は大きなものを小さく分解することは得意であるから、反復的に機能を分解していく方法は容易に行うことができる
同時にトップダウン方式のデメリットを次に示します[8][9]。
- 機能を分割していく関係上、分割された機能の呼び出し関係は木構造になり、再利用性が低下する
- 機能を分割してくことに注視しているため、データ構造が無視されがちであり、プログラムの機能追加など修正にともなう複雑さが増える
一見すると、段階的作成法はトップダウン方式であり、メリット・デメリットが重複しており矛盾していると感じるかも知れません。 ですが、ダイクストラが提案した段階的作成法は、厳密にはトップダウン方式ではありません。 なぜならば、同じ処理を共通化して利用することを推奨しており、機能の呼び出し関係が木構造になりません。 また、機能(作用)の分割のみならず、データ構造の分割についても、機能分割と並行してなされています。 さらに、段階ごとに決定することをなるべく少なくすることと手続きによって抽象化した機能を層状に組み立てていく設計方針は、 理想的には 、変更に強いプログラムを作成できます。
まとめると、プログラムを構造化すること、手続き(メソッド)を定義して抽象化しプログラムを組み立てていくことが、プログラムの理解しやすさひいては書きやすさに繋がるということ、そして、要件を正確に満たしたプログラムを作ることになるわけです。
[an error occurred while processing the directive][8]: M. Steve, ``CODE COMPLETE 上 完全なプログラミングを目指して'', 第二版, 日経BP社 (2005)
[9]: B. Meyer, ``オブジェクト指向入門'', アスキー出版局 (1990)
\(\dagger\): もちろん動的配列やリスト構造を利用した動的な構造を利用することも考えられます。しかし、ここでは議論が複雑になりすぎるので全て静的な構造で定義します。
\(\ddagger\): その他にも、配列インデックスに対応する数値が素数か否かをboolean値で持つ配列構造なども考えることができますが、ここではこれ以上の議論はしません。